Databricks:当员工开始指挥 Agent,公司该怎样运转?
原文链接: https://www.a16z.news/p/databricks-and-the-future-of-the 来源: www.a16z.news 发现于: 小互 · AI 解读站 · 2026/10/28 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
Databricks 与企业的未来
智能体(Agents)和新型数据库技术将如何改变企业的形态,以及我们每天的工作内容
https://substack.com/@bhorowitzhttps://substack.com/@michaelmcguinessBen Horowitz 和 Michael McGuiness 2026年10月27日

未来二十年内,我们生活的许多方面都将发生变化。其中,“你每天的工作内容是什么?”这个问题将轻易进入前五名。
围绕这一问题,两项重大突破即将发生。第一项是智能体自动化(agentic automation):“描述我们当前执行的任务,并将其自动化。”第二项是员工赋权以主动采取行动。身处问题一线的人越来越多地能够自主调查并抓住机会采取行动,而无需等待信息和权力在层级结构中层层传递。
这两者都是对每个人日常工作的根本性变革——而且是向好的方向变革!但是,前提是——这是一个巨大的前提——组织能够真正适应这种新的工作方式。令人震惊的是,“某人的日常工作是什么”在很大程度上受到其雇主使用的记录系统和决策机制的约束。而这本身又受到他们使用的数据库技术及其所能实现的功能的约束。很少有人思考到这一层。
这就是 Databricks 登场的原因。除了在其影响范围内的人(他们非常了解 Databricks)之外,Databricks 可能是硅谷中最不被关注的故事之一,尽管其年化收入规模已超过70 亿美元,同比增长 80%https://x.com/alighodsi/status/2087910823142240500。你肯定听说过它,但并没有太多人真正了解 Databricks 做什么,除了知道它是 1) 一家数据公司,以及 2) 对智能体(Agents)很重要,尽管可能并不清楚原因。
Databricks 的故事是一系列戏剧性事件的集合,是一个产品恰逢其时的偶然典范。三年前,Databricks 上的每一次交互都涉及真人。如今,该公司收到的来自智能体的查询多于来自人类的查询,每天由智能体启动的数据库超过 1700 万个。这一趋势将持续下去。
这个故事包含四个部分:
Databricks 到底做什么?“湖仓一体(Lakehouse)”和“湖库(Lakebase)”是什么?你可能在广告牌上见过这些词,为什么它们是恰逢其时的架构突破?
什么是“记录系统(system of record)”?如果智能体要在真实公司内工作、做出真实决策并为公司知识库做出贡献,为什么它们需要一种新型的记录系统?
企业究竟是什么?如果智能体与人类的比例达到 1000:1,企业形态将如何变化?企业如何差异化自身并创造价值?
在这个新世界中,人们的日常工作是什么?AI 在工作中的承诺通常被宣传为“普通人现在拥有了软件工程师的能力。”但长期影响不一定是“每个人都是工程师”。它可能更接近于“每个人都是管理者”。
这可能是所有故事中风险最高的一环。我们正实时见证管理风格的重大解构,这种管理风格构建了 20 世纪的企业,正如詹姆斯·伯纳姆(James Burnham)的著名著作*《管理革命》*中所记录的那样。85 年前,伯纳姆描述了信息技术和组织复杂性如何创造出一种企业运营模式,其中一小类专业管理人员在公司内部集中决策权。今天,得益于新一波技术浪潮,前线的手工艺从业者正在重新承担责任——这对我们所有人来说都是好事。
这是 Databricks,以及它将如何驱动企业的未来。
从 Spark 到 Agent
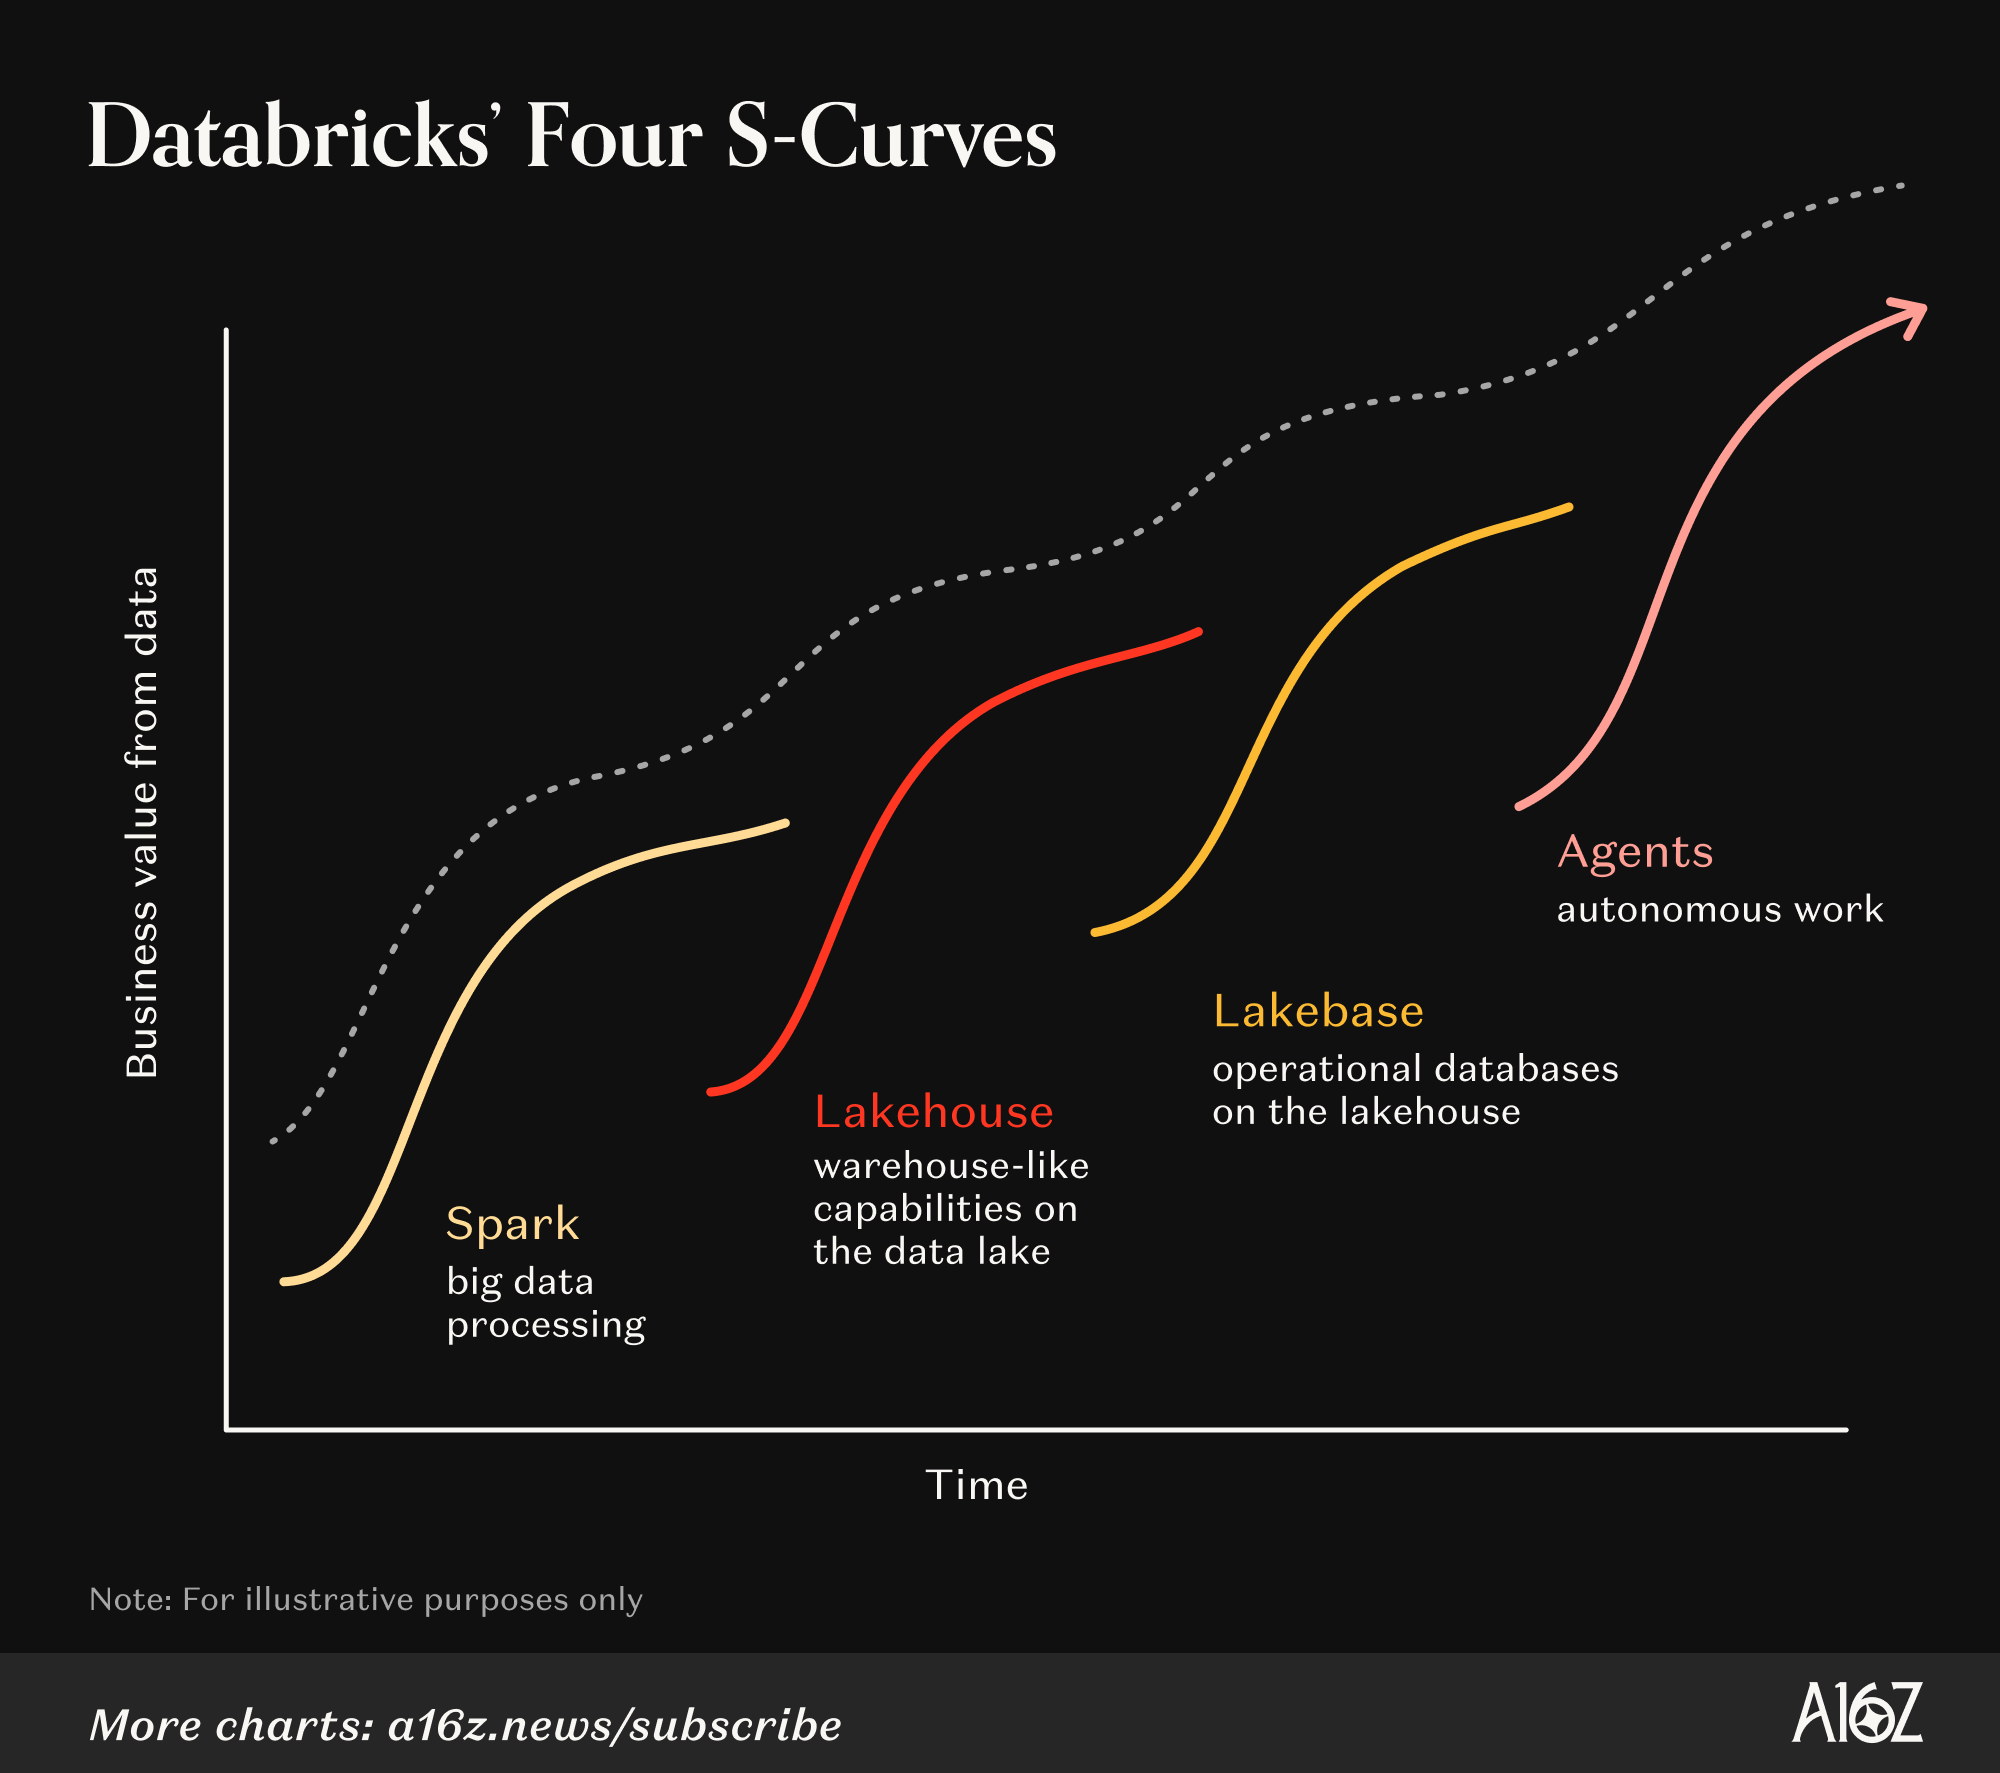
Databricks 最近被描述为“一家抓住了 AI 浪潮的数据公司”。但在浪潮到来之前的十年,这家公司就已经由 AI 研究人员建立起来了。这家企业的业务建立在近二十年来堆叠的四条技术 S 型曲线上——Spark、Lakehouse(湖仓一体)、Lakebase,以及现在的 Agent(智能体)——每一条曲线都为下一条曲线创造了创新窗口。为了充分理解这一释放潜力的序列,我们需要花一点时间谈谈数据库技术。
2009 年,Ali Ghodsi 是加州大学伯克利分校的访问研究员,他目睹互联网公司使用庞大的数据集来预测人们会点击、购买和观看什么。那是人们大量谈论“大数据”的时代。当时的主流框架是 Hadoop,雅虎、Facebook、Twitter 和 LinkedIn 等公司使用 Hadoop 在数千台廉价的商用服务器上并行处理数据负载。在 Hadoop 之前,处理更大负载的标准方法是购买来自 Oracle 或 IBM 等供应商的更大型机器,每台成本高达数百万美元,因此 Hadoop 是一个极具吸引力的替代方案。
Hadoop 的关键缺陷在于,计算的每一轮在下一轮开始之前都会将结果保存到磁盘。这使得当集群中的一台廉价机器发生故障时,数据更容易恢复,这是一个合理的决定。但对于机器学习等迭代负载来说,这种方法痛苦地缓慢,因为你需要做出预测、衡量误差、更新模型,然后重复这一过程。Hadoop 将每一轮视为一个新任务,并每次都从磁盘重新加载相同的数据,因此集群花费几分钟移动数据,只为用几秒钟改进模型。
这个问题激发了伯克利博士生 Matei Zaharia 编写 Apache Spark 的第一个版本。Spark 建立在 Hadoop 将数据处理工作分散到廉价机器上的创新之上,但允许应用程序在轮次之间将频繁重用的数据保留在服务器快得多的内存中,而不是每次都从磁盘加载——同时不牺牲容错性。这使得这些重复性负载的速度提高了多达十倍。该实验室于 2010 年开源了 Spark,三年后,Ali、Matei 和他们的五位研究人员共同创立了 Databricks,旨在为企业提供一个单一平台,以抽象化运行 Spark 所需的分布式基础设施的复杂性——集群、扩展、安全性等。
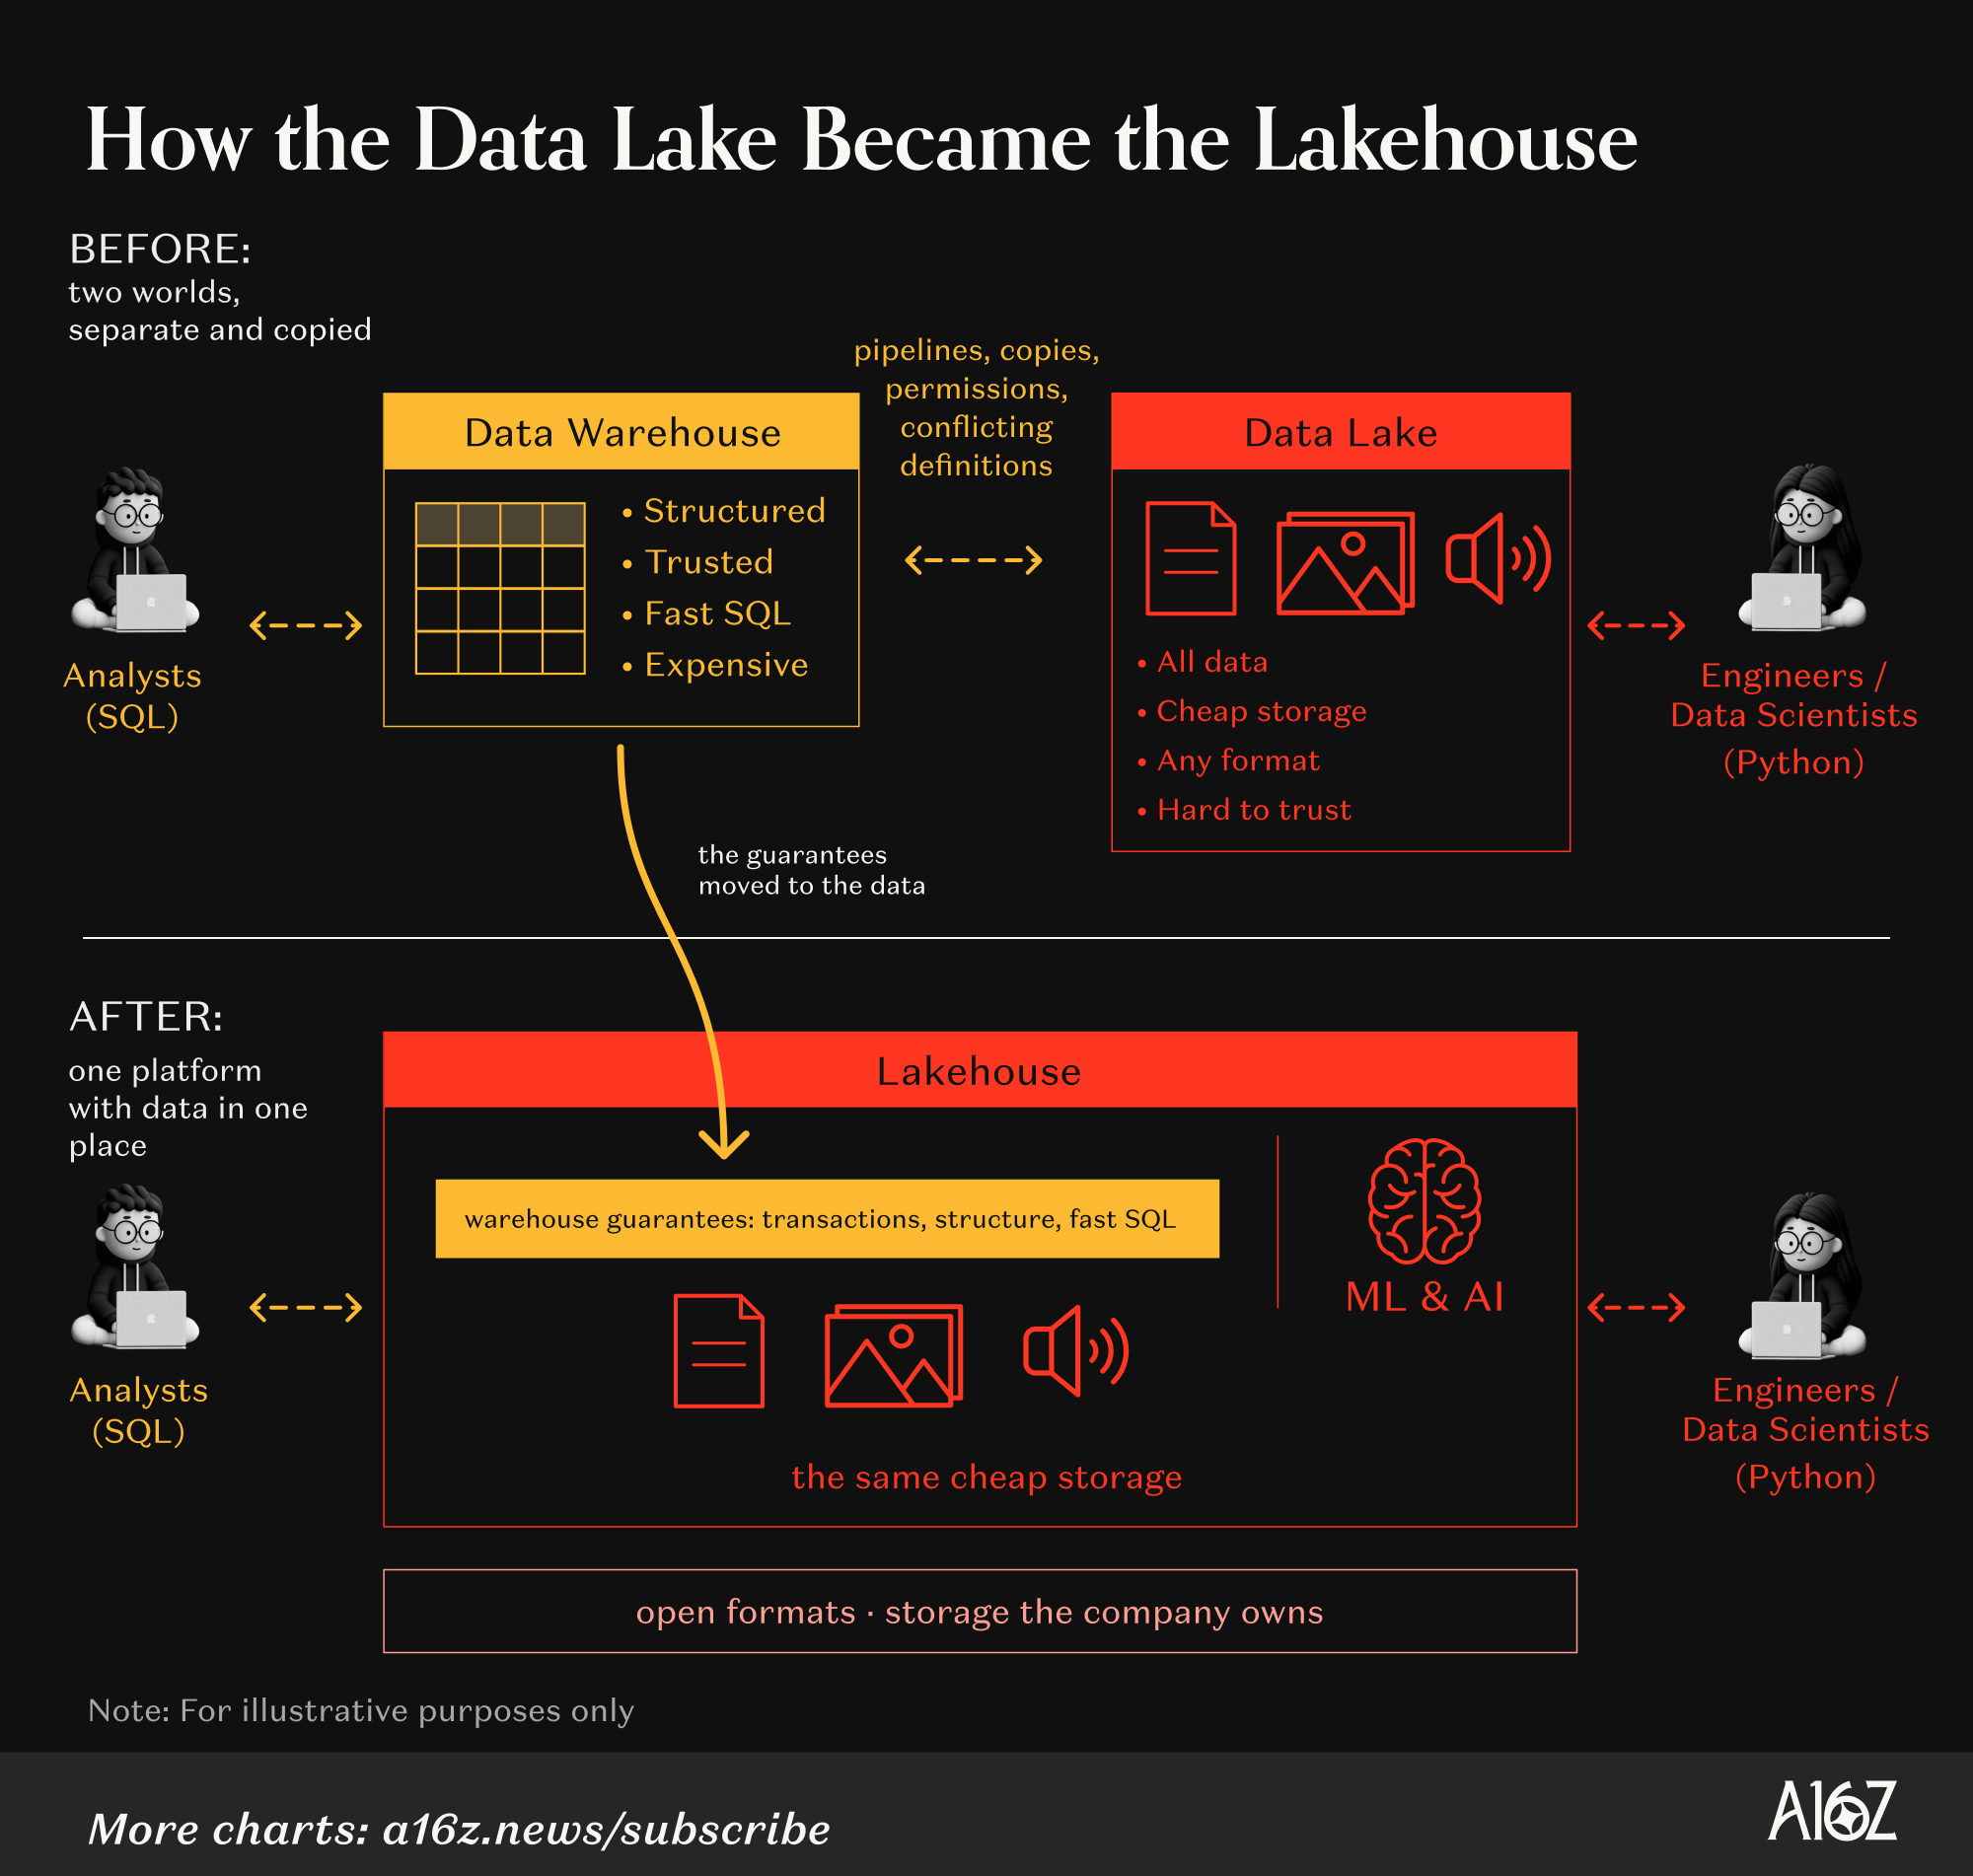
Spark 加速了数据处理,但数据存储在哪里是另一个问题。那个时代的企业数据占据着两个分离的世界。数据仓库存储结构化的、可信的记录,让分析师可以用 SQL 提出问题,并驱动每个仪表板和季度报告。数据湖为文档、图像、录音和日志等其他所有内容提供廉价存储。数据湖很便宜,所以团队将所有内容都倾倒进去;但在输入时没有任何检查或结构化。尽管围绕数据湖 grew 出了庞大的 AI 开源工具生态系统,如 TensorFlow 和 PyTorch,但从一堆你无法信任的数据中获取价值很难,因此它们获得了“数据沼泽”的绰号。
这两个系统都解决了一个问题,但也造成了分裂。工程师和数据科学家生活在用 Python 操作的数据湖中,而分析师生活在用 SQL 操作的数据仓库中。每当一方需要另一方的数据时,就必须有人构建管道来传输数据。这导致公司拥有大量的副本、管道、权限和冲突的定义。但在 2010 年代后期,Databricks、Uber 和 Netflix 各自独立地找到了相同的修复方案。它们的项目(Delta Lake、Hudi 和 Iceberg)在湖中的文件之上添加了一个表层,赋予了它们类似数据仓库的保证,如全有或全无的更新、模式管理和版本历史。公司不再需要将数据移动到单独的数据仓库以确保可靠性和性能,而是可以在数据已经存在的相同存储上运行类似数据仓库的工作负载。这是使新架构成为可能的突破。
2020 年,Databricks 通过合并数据湖(data lake)和数据仓库(data warehouse),发明了“湖仓一体”(lakehouse)。它将数据湖廉价且灵活的特性与数据仓库严格的可靠性和快速的查询性能相结合,并在同一基础之上实现了仓库级 SQL 和机器学习作为一等公民的工作负载。承载所有数据的廉价存储变得足够可信,成为工程师、数据科学家和数据分析师最终可以共享的数据基础。“最好的数据仓库就是湖仓一体”,这句标语得到了客户的广泛认同。如今,Databricks 的 Lakehouse 年收入运行率已超过 15 亿美元,同比增长超过 100%。
亚马逊 CTO Werner Vogels 在 2020 年 1 月的一篇 博客文章 中从客户角度阐述了这一观点。“如果你想在传统数据仓库中整合所有这些数据,而没有数据湖的支持,就需要大量的数据准备以及提取、转换和加载(ETL)工作,”他解释道。“你必须对要丢失的数据做出权衡,并不断改变刚性系统的结构。”数据湖允许你以任何格式导入数据,从而消除了这些权衡。Vogels 写道,湖还是机器学习和 AI 的强大基础,因为“它们依赖于大量且多样化的数据集”。
然而,仍存在一个分歧。Lakehouse 统一了公司分析所用的数据,但并未统一其应用程序所运行的数据。操作型数据库(operational database)负责管理日常业务运营中的实时事务,如处理支付或用户登录,它仍然通过一系列脆弱的数据管道与 lakehouse 连接。计算和存储仍然捆绑在一个单体系统中,数据被锁定在专有格式中,使得迁移成为任何组织中令人畏惧的技术项目之一。
因此,在 2025 年,Databricks 收购了 Neon,一家无服务器 Postgres 公司,其数据库主要由 AI Agent 创建,并代表了一种被称为 lakebase 的新型数据库架构类别(这也促使 Databricks 将集成 Neon 到 Databricks 中的产品称为“Lakebase”)。正如 lakehouse 在数据湖之上重建了数据仓库一样,Lakebase 将这一理念应用于操作型数据库。它将存储与计算分离,使数据可以廉价地存储在数据湖中,而计算能力可以根据需求上下扩展。由于操作型数据库和 lakehouse 共享相同的基础存储,数据库的更改会自动提供给分析师、工程师和 Agent,无需构建和维护复杂的数据管道。Databricks 将这种事务与分析的统一称为 LTAP(Lake Transaction/Analytical Processing,湖事务/分析处理)。
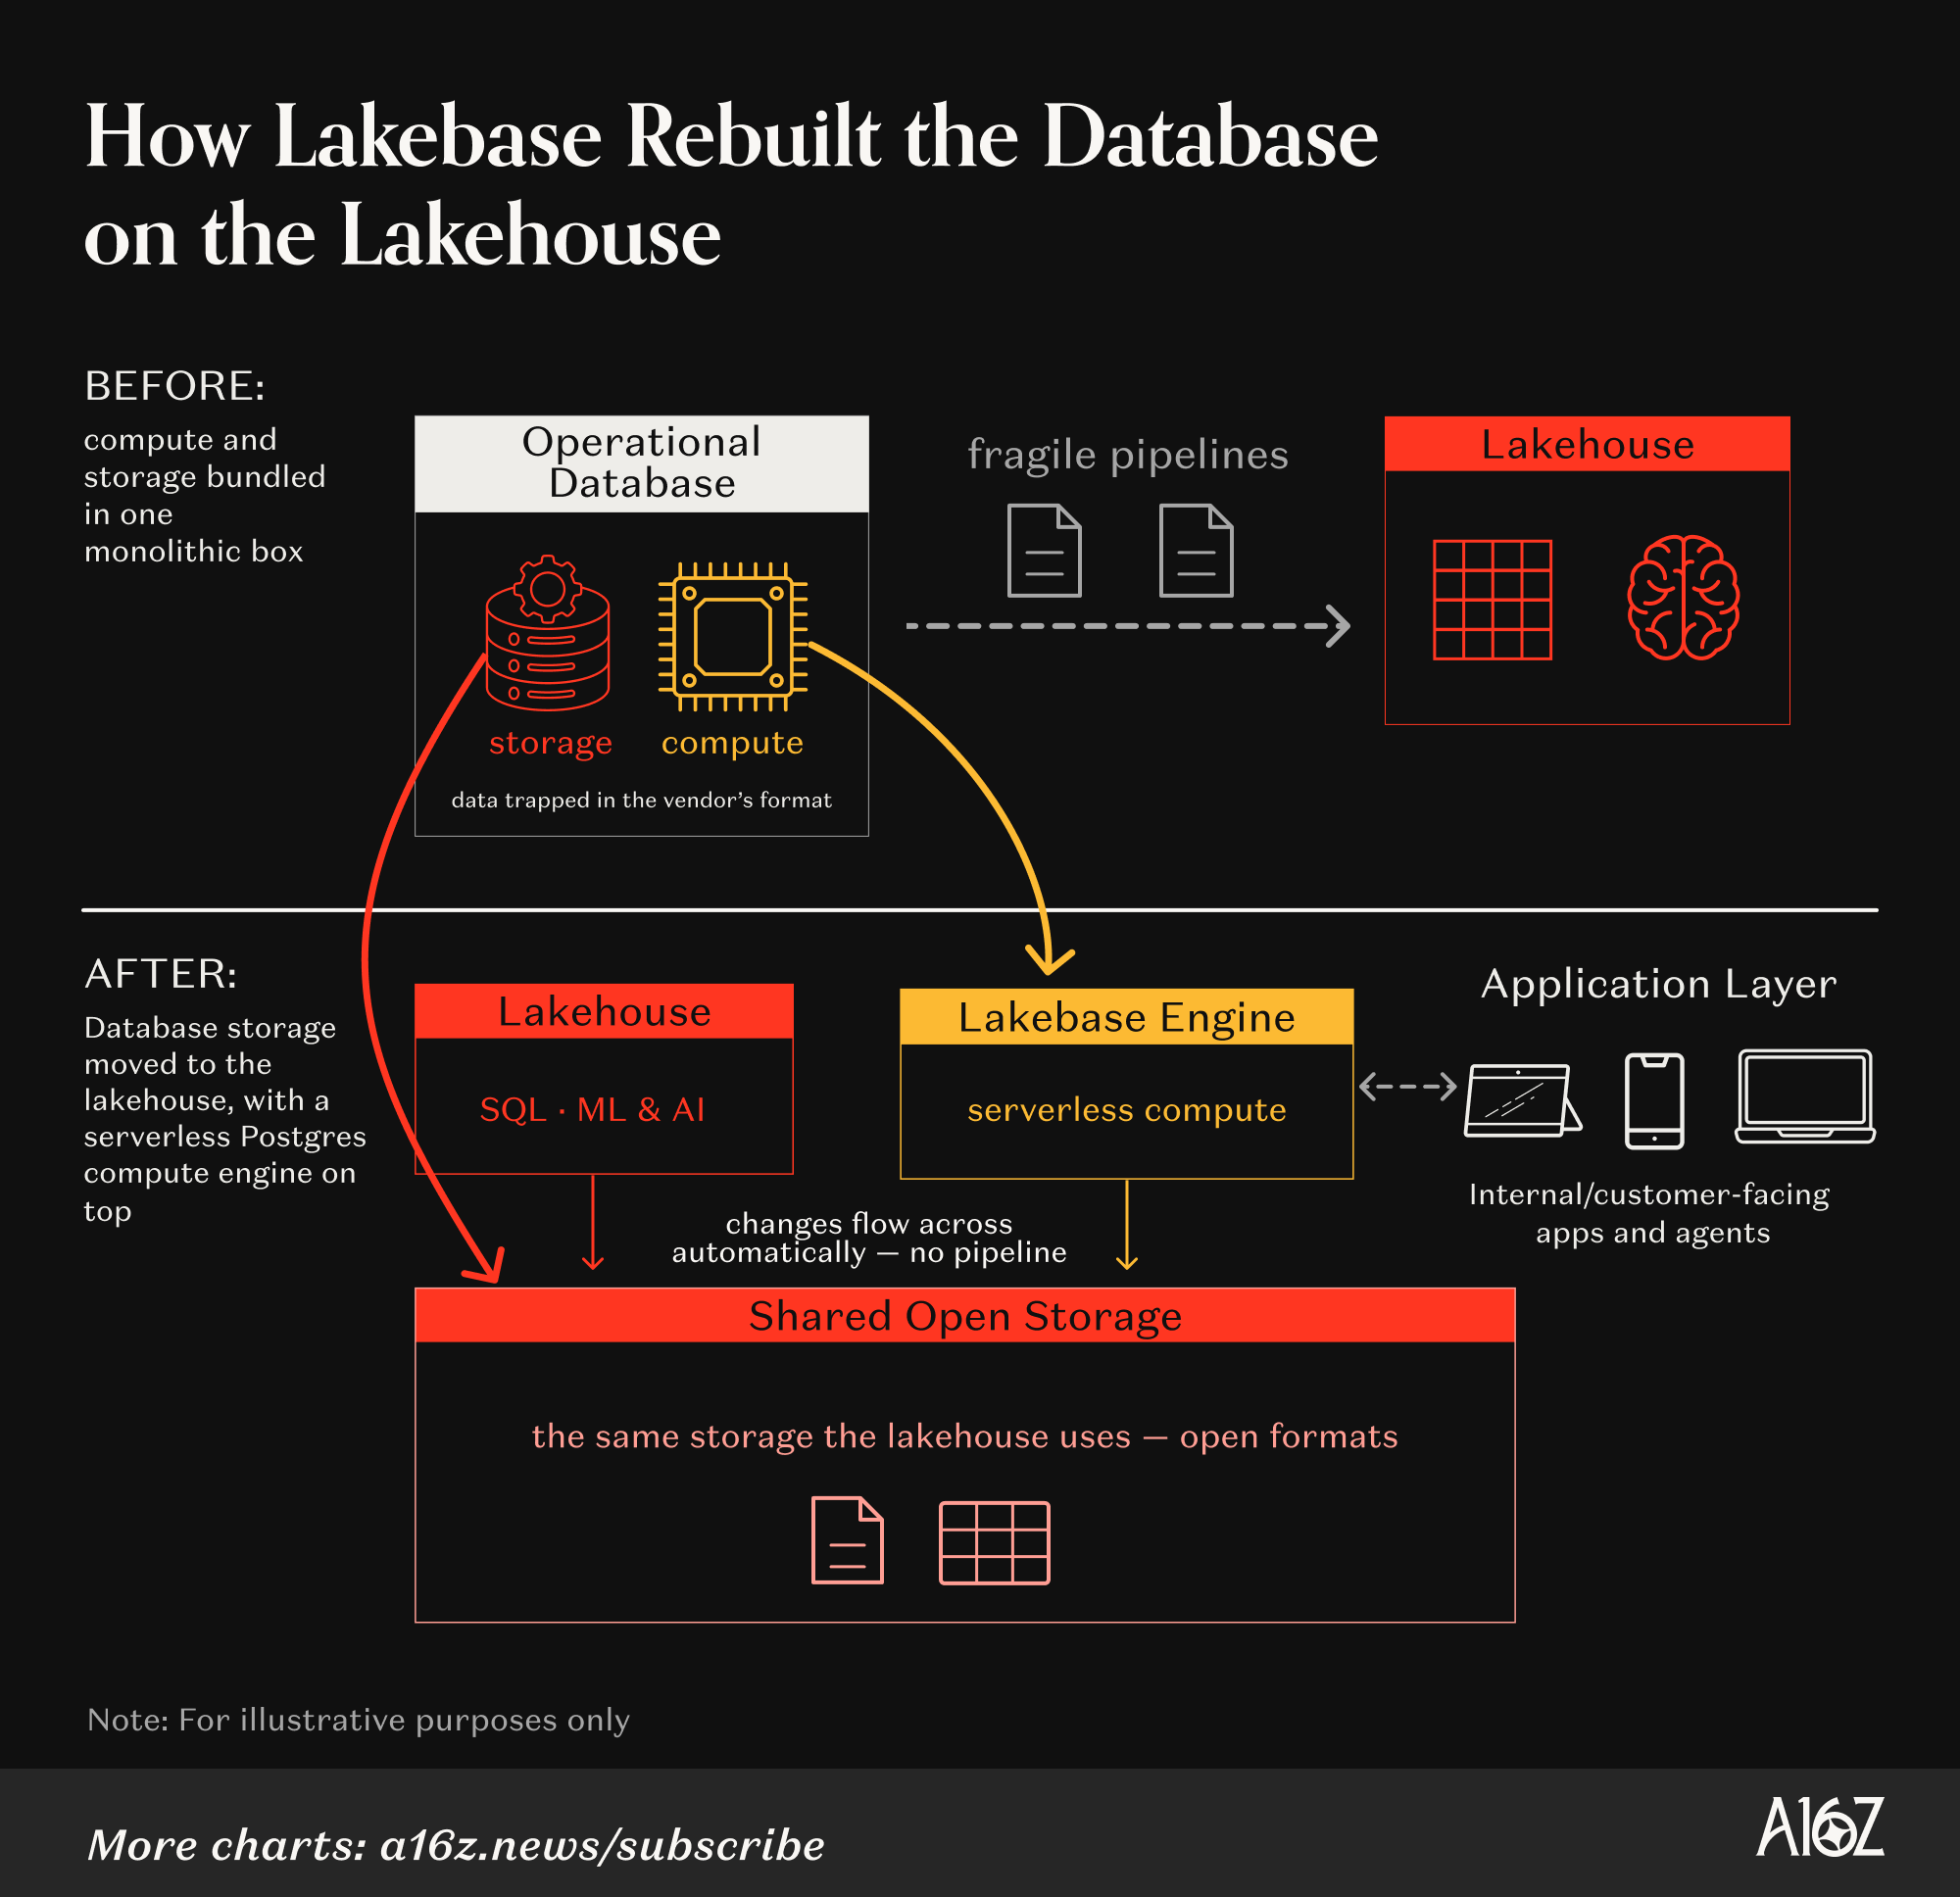
这种分离使得数据库的行为更像代码。即使是 PB 级规模的数据库也可以在几秒钟内复制,因为 Lakebase 仅复制变更。这使得 Agent 可以创建一个隔离的分支,在其上进行实验,并在完成后将其丢弃——直到最近,Databricks 才充分认识到这一点的重要性。Lakebase 于去年推出,年收入运行率已突破 1 亿美元,Agent 是其最活跃的用户。“我们认为,从长远来看,这可能会成为一个比现有数据库市场更大的市场,”Ali 表示。
这一技术突破恰逢其时。几十年来,公司的软件由一小群工程师构建,供其他人使用。我们正迈向这样一个世界:个人声明他们想要的结果,软件则自行决定如何实现它。不再是由数千名员工从由中央团队管理的少数几个数据库中读取和写入数据,公司将拥有数千个数据库,供数百万个 Agent 读写。
Agent 的记录系统
Databricks CEO Ali Ghodsi 在公司的 Data + AI Summit 2026 上发表演讲(照片:Databricks)
六月,Ali 在公司的 Data + AI Summit 上面对约 30,000 人,询问在座的人是否认为通用人工智能(AGI)已经到来。他数了数,大约只有百分之十的人举手。
“我们认为 AGI 已经到来,”他告诉他们,指出当前的前沿模型已经能够解决 Humanity’s Last Exam 上超过一半的问题——这些题目由一百多个领域的专家编写,被认为任何 AI 都无法回答,共计 2,500 道题。
2022 年 ChatGPT 发布时,它能处理需要人类花费约 30 秒的编码任务。如今的前沿 Agent 能够完成需要熟练工程师整整一个工作日才能完成的编码任务。独立评估实验室 METR 的研究人员追踪了 Agent 能够独立完成的任务长度,涵盖自 2019 年以来的模型,结果显示这一长度大约每七个月翻一番。最近,进展甚至更快,编码之外的领域也呈现出类似趋势。如果这一趋势持续到 2030 年代初,Agent 将能够完成需要人类花费数年才能完成的任务。
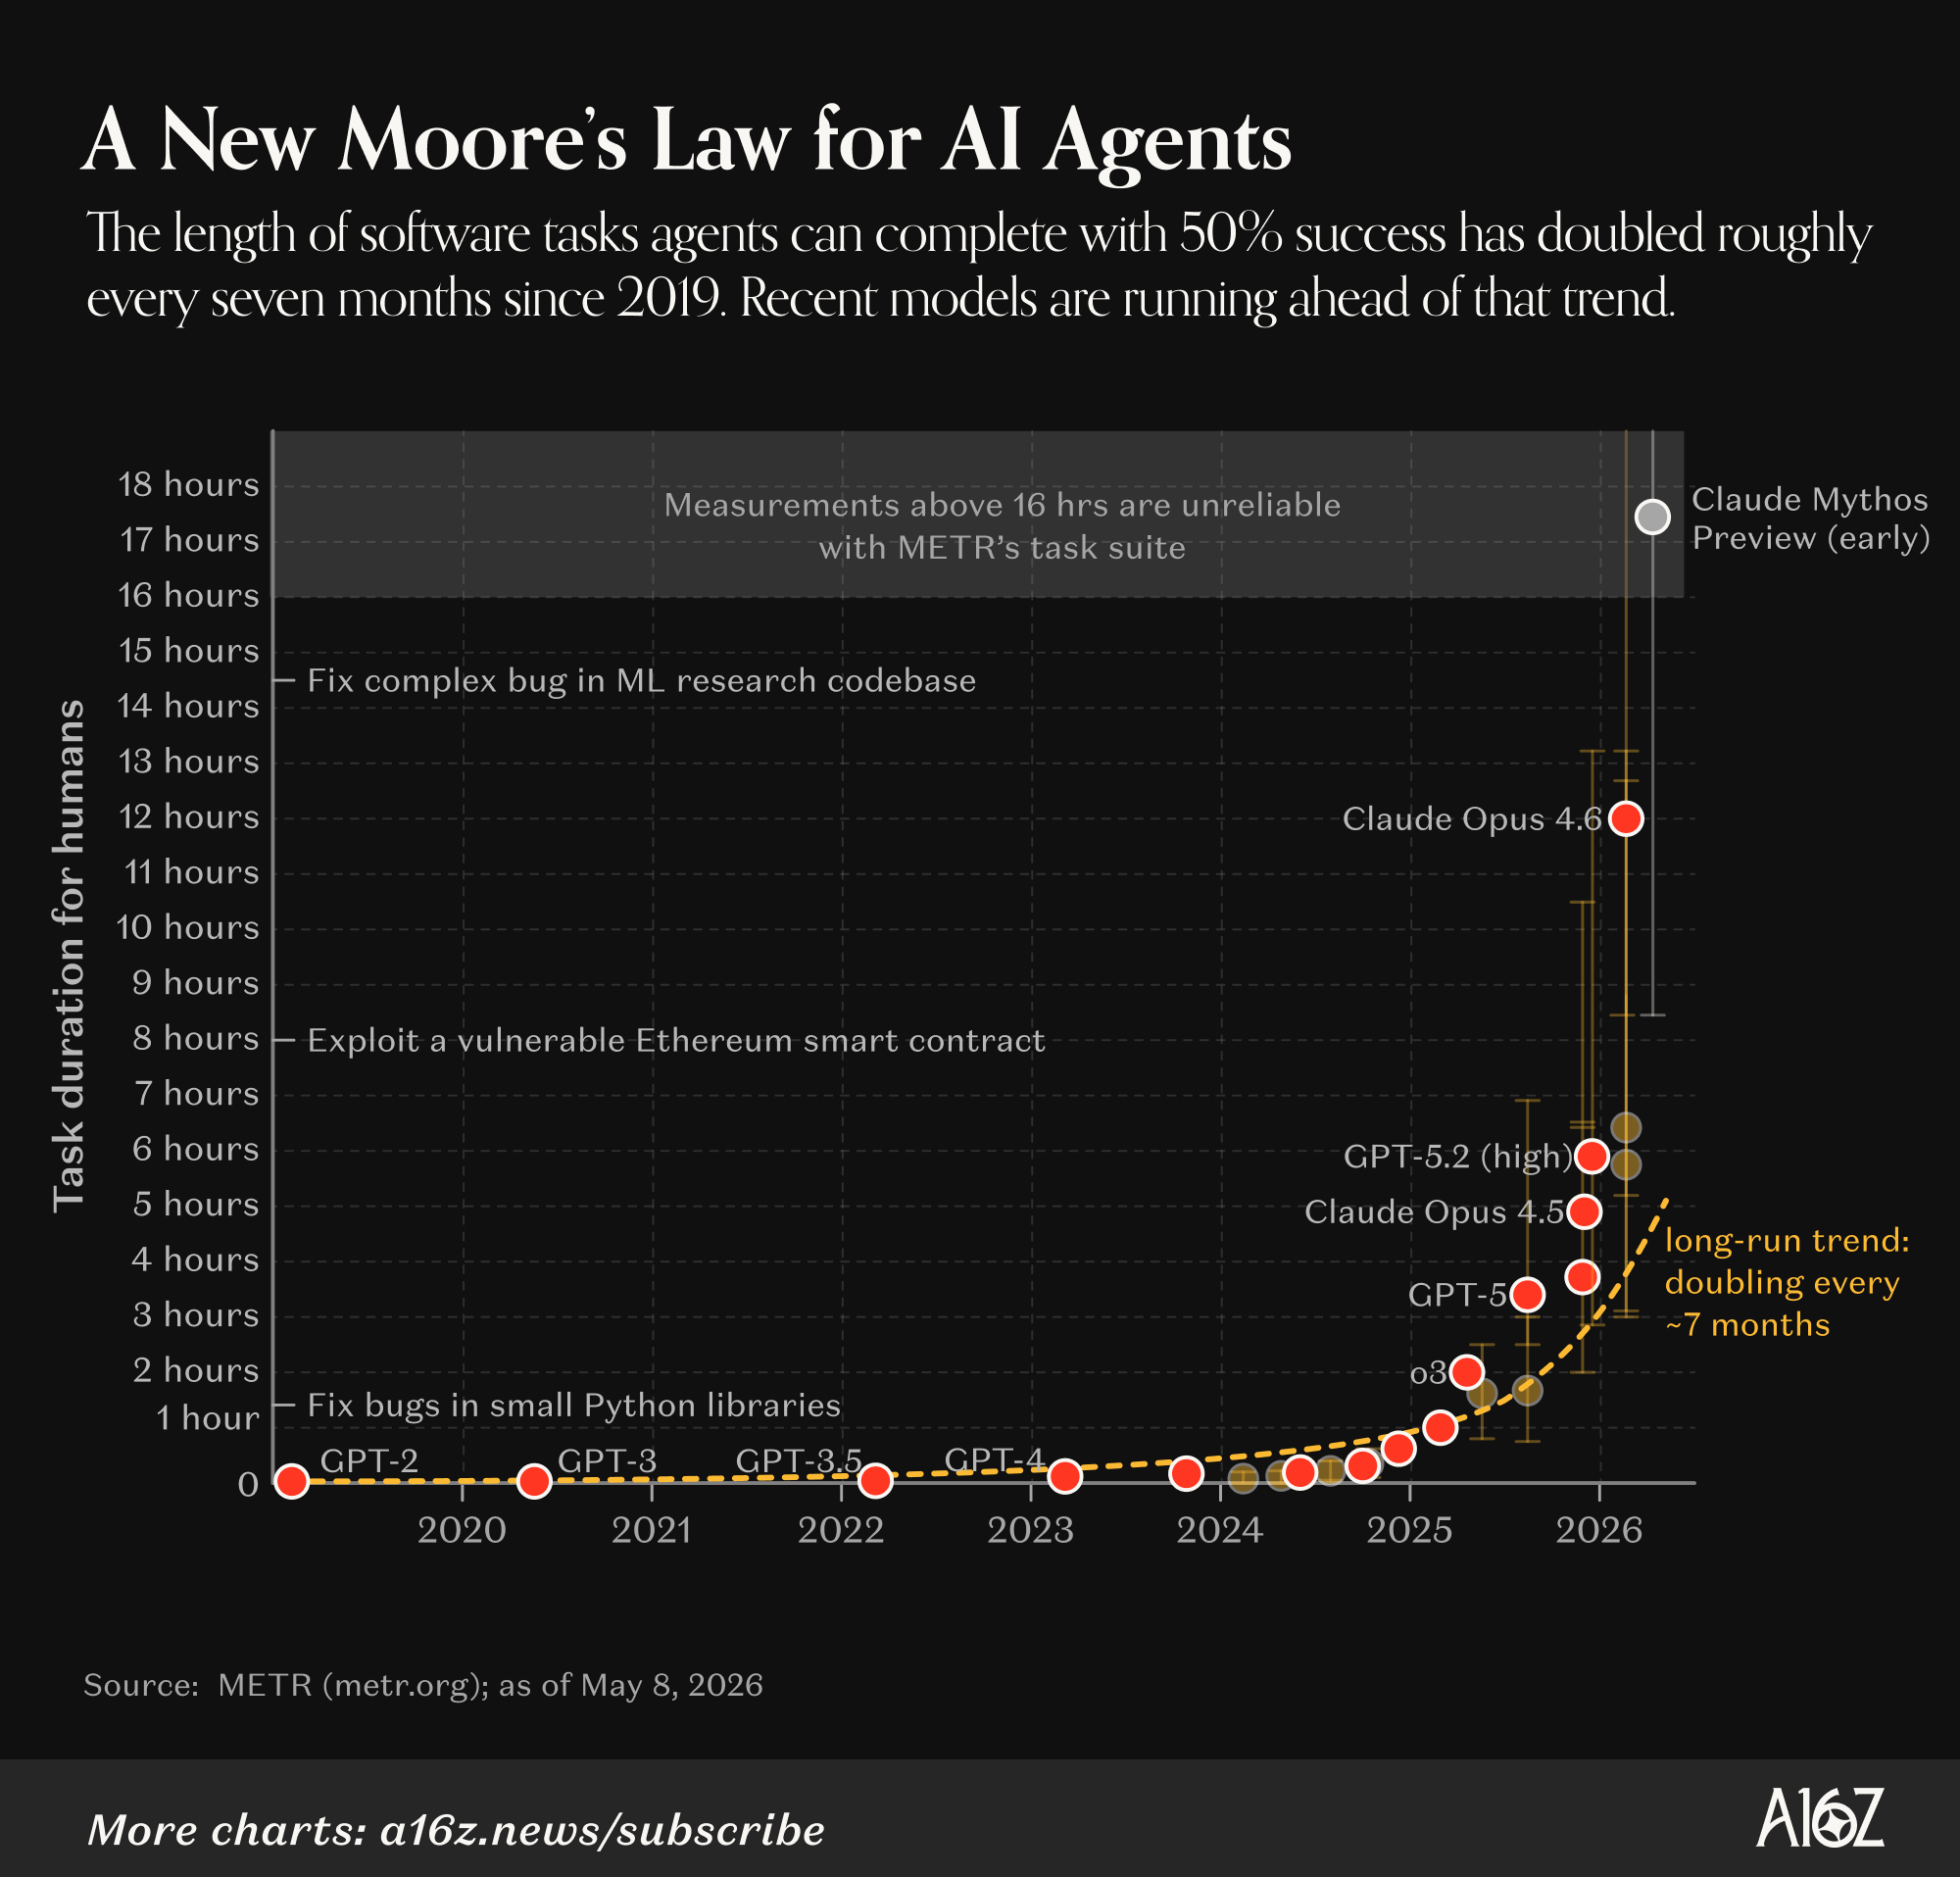
然而,在大多数公司中,AI 目前仍不被信任去可靠地更新 Salesforce 中的记录。
“AI 并没有智能问题,”Ali 解释道,“它有上下文问题。”即使是最聪明的人类,如果没有访问公司数据的权限、行动许可、反馈或了解其他员工的头脑中的知识,也将几乎毫无用处。Ali 的答案是他所称的“Agent 的记录系统”。
你可能看过 Palantir CEO Alex Karp 谈论本体论(ontology)的视频片段。“市场上所有的价值都将流向芯片和我们所说的本体论,”他提出,“本体论允许你获取一个 LLM,使用它,优化它,并将其应用于你的企业。”但这在实际中意味着什么,通常留给听众自己去思考。
每家公司都有一个本体论——即对存在的事物、事物之间的关系、词语的含义以及当两个来源发生冲突时以哪个为准的工作模型。它的部分存在于数据库、仪表板、政策和文档中。但大部分只存在于经验丰富的员工的头脑中。而且它永远无法完成。合同会变化,变通方法成为流程,例外成为规则,官方记录逐渐偏离实际工作方式。谁决定什么以及记住哪些决策是正确的——权力和评估也同样未成文。人们几乎无声地补偿所有这些差异。销售副总裁的工作是知道最大的承诺交易停滞不前,因为冠军(champion)正在私下面试其他机会,知道某位代表的“90%”实际上意味着 50%,并在这些数据到达 CEO 之前削减预测。
为了让 Agent 自主行动,目前存在于人们头脑中的本体论(ontology)、权限和评估机制,必须迁移到公司的记录系统(system of record)中。Databricks 押注湖仓一体(lakehouse)是其天然归宿,因为公司的其余数据都存储并治理在那里。“如今,湖仓一体已成为记录系统,”Ali 表示。“我称之为 SORA——Agent 的记录系统。”
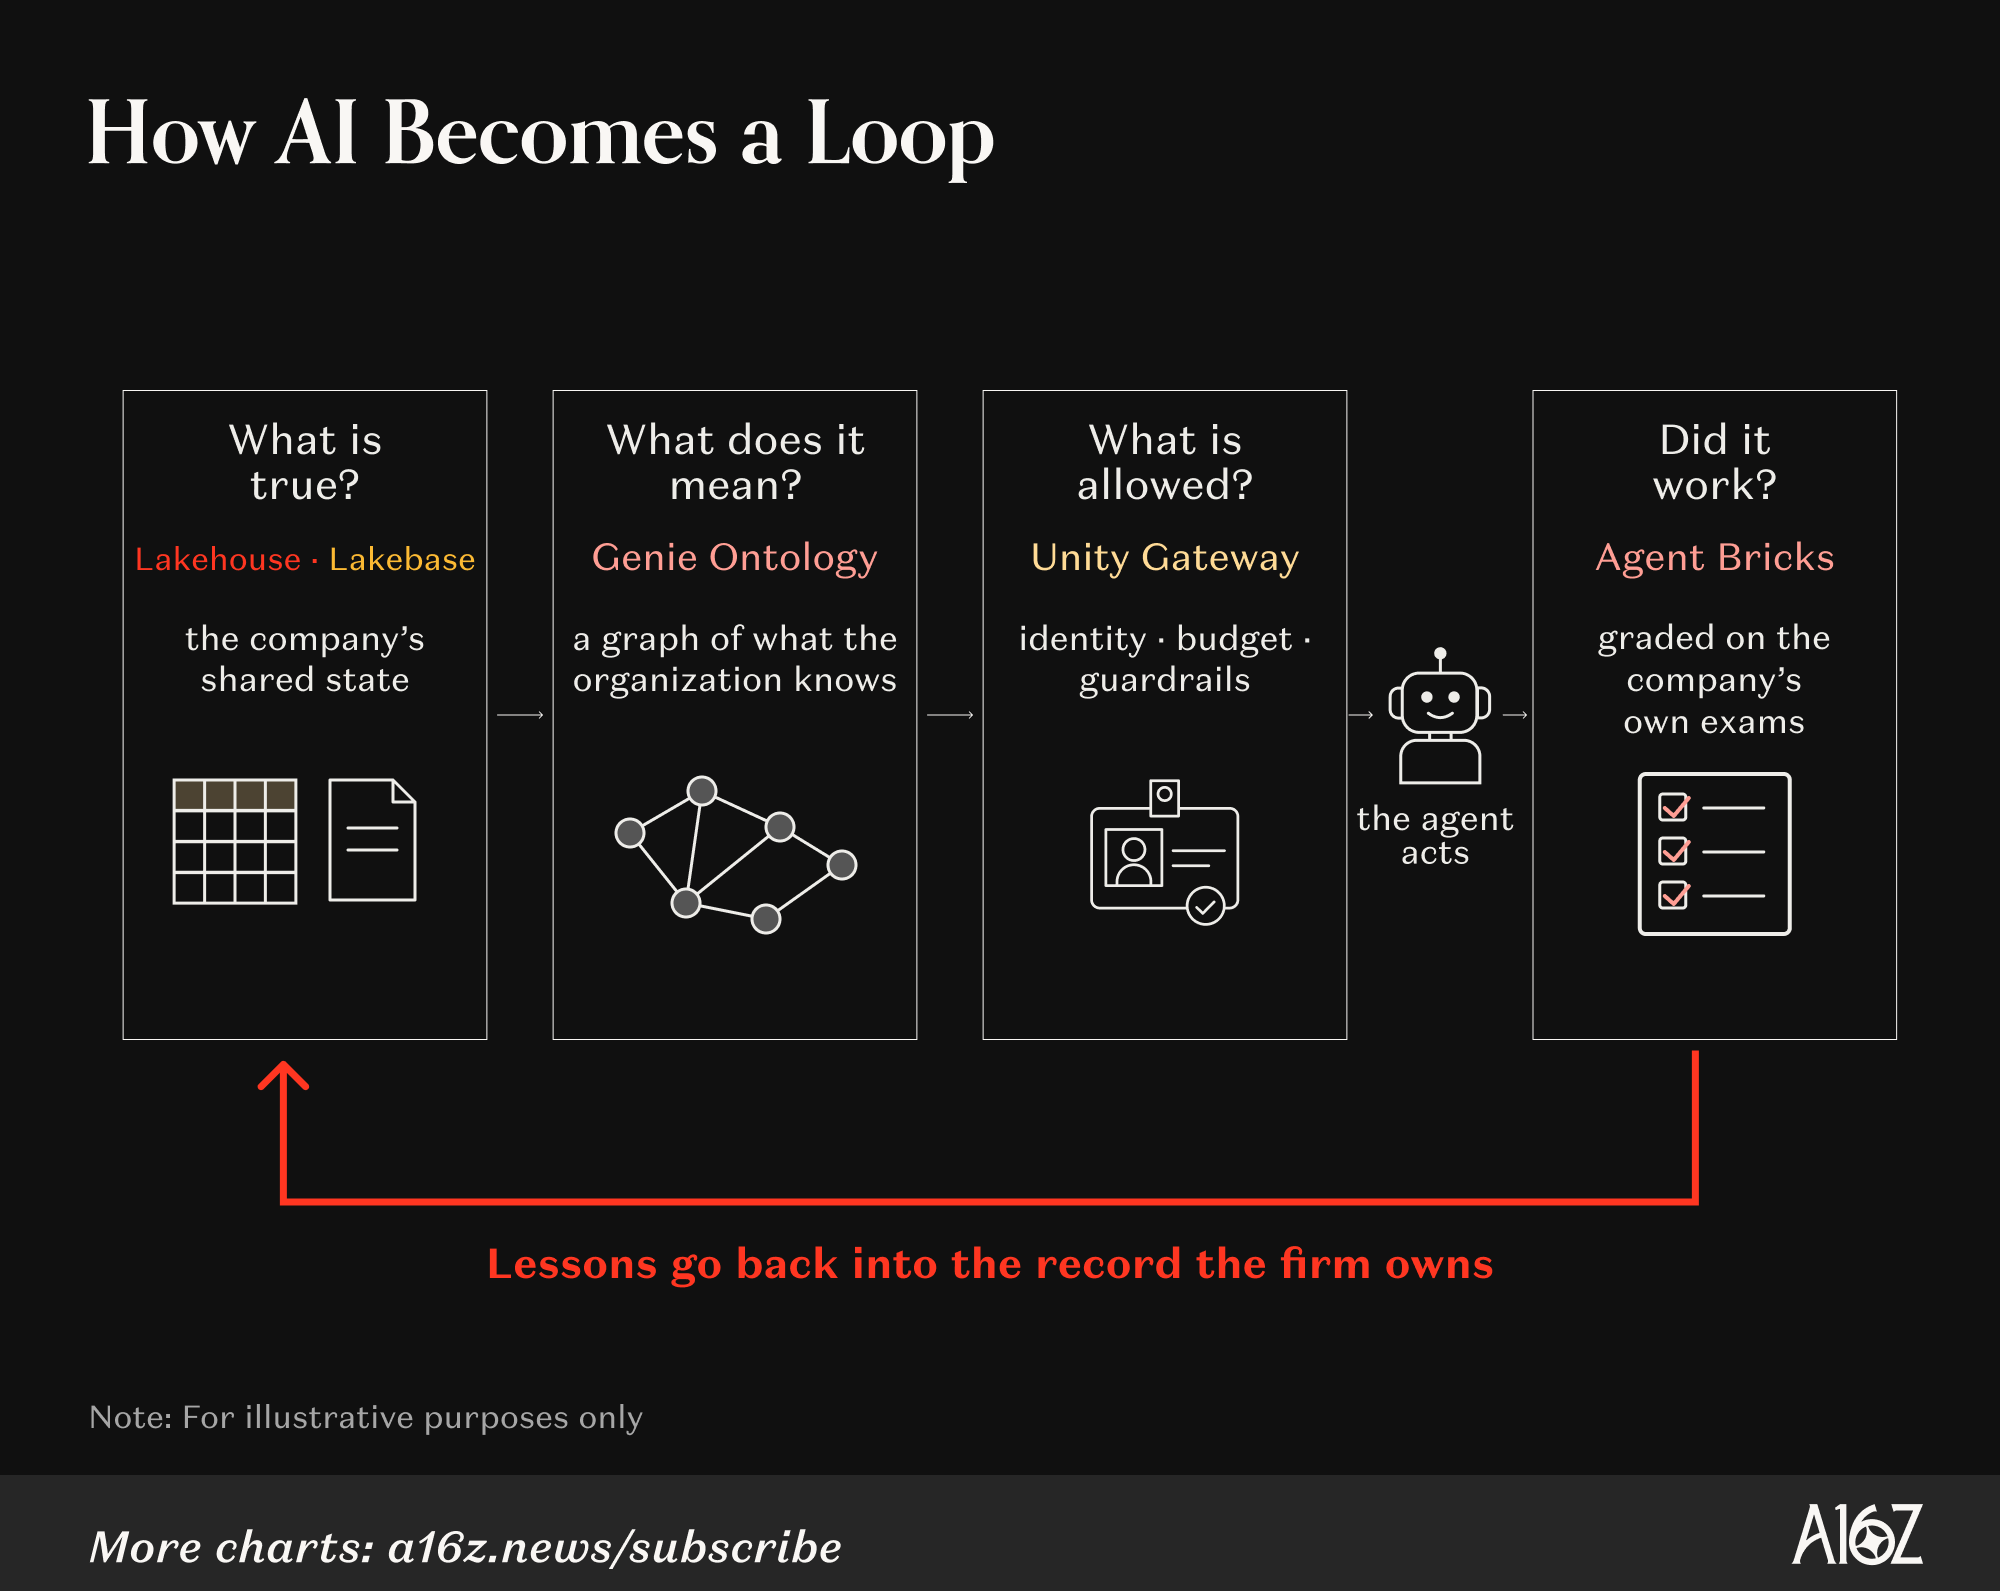
员工可以通过 Genie 与这个记录系统进行交互。Genie 是 Databricks 在 2024 年推出的自然语言界面,允许公司中的任何人向数据提问,并越来越多地在其之上构建 Agent。在底层,这个记录系统必须贯穿整个公司,并持续回答以下四个问题,Databricks 正在针对这些问题开展工作:
什么是真实的? Lakehouse 和 Lakebase 已经保存了状态。
这意味着什么? 与其让 AI 在每次有人提问时遍历公司中的所有数据以寻找答案,Databricks 的 Genie Ontology 会持续构建一个关于组织所知内容的图谱,例如如何计算收入或上周站会纪要中讨论了哪些内容。工程师们将一种名为 OntoRank 的算法(向 Google 的 PageRank 致敬)用于对知识的权威性进行排名,通过权衡创建定义的人、使用范围以及最近更新频率等属性。在 Databricks 的测试中,将 Agent 锚定在公司本体上 将 答案的准确率从约 50% 提高到了 84.5%。
什么是允许的? 当每个员工都是人类时,为每位员工提供登录凭据的旧访问模式尚能维持,但当员工每天启动数百个 Agent 时,该模式就会失效。“你不能将访问权限授予每个专有、孤立的数据库给你的 Agent,”Ali 解释道。Databricks 的 Unity Gateway 为公司中的每个模型、Agent 和 AI 工具提供身份、预算和护栏(guardrails),并追踪日志记录每一个操作,以便公司能够了解其 AI 系统在做什么、访问了哪些数据以及消耗了多少成本。
是否有效? Databricks 提供了两种构建 Agent 的方式。业务团队在 Genie 中构建他们的 Agent,将提示词转化为可共享的 Agent,该 Agent 会对公司数据进行推理,并越来越多地在 Slack 或 Salesforce 等应用程序中采取行动。工程师则在 Agent Bricks 中构建更定制的 Agent,这是 Databricks 用于生产级 AI Agent 的开发者平台。无论哪种方式,Databricks 都允许团队编写自己的“考试”——即可接受的结果和不可犯的错误——并提供工具,根据公司对特定任务“良好”的定义来优化每个 Agent,这正是 AI 形成闭环的方式。
企业计算中的每一次平台转变都引发了对记录系统的新争夺。IBM 主导了大型机时代。Oracle 和 SAP 成为客户端-服务器企业的基础,而 Salesforce、Workday 和 ServiceNow 则为销售、人力资源和 IT 构建了 SaaS 记录系统。Agent 是下一次转变。
但哪个供应商获胜是一个比 Agent 将如何改变公司本身更次要的问题。
企业的性质
在其 1937 年的文章《企业的性质》中,经济学家罗纳德·科斯(Ronald Coase)提出了一个根本性问题:企业为何存在?如果市场可以通过价格和合同协调活动,为什么还要将人们聚集在公司内部,并使其工作受到管理层的指挥?
他的答案归结为交易成本。找到合适的人、协商以何种价格完成何种工作,以及监控所有这些过程都需要时间和金钱。企业用一种更开放的安排取代了其中一些重复的市场交易,在这种安排中,管理者在商定的范围内调配资源。但是,在企业内部组织工作也并非没有成本。随着公司的发展,更多的信息必须通过更多的人传递,最终,在内部组织下一笔交易的成本将与从市场购买它的成本相当。在科斯的论述中,企业会扩张,直到这两项成本相遇。
四十年后,赫伯特·西蒙(Herbert Simon)——少数同时获得诺贝尔奖和图灵奖的人之一——观察到,集中化企业的记忆会导致决策的分散化。他写道,“共享计算机记录允许每个分散的决策点独立采取行动”,因为系统会自动将这些行动与共享记录进行协调。
对于航空公司而言,波士顿的一名票务代理在出售最后一张飞往芝加哥的机票时,不必再逐一联系其他票务代理。她只需查阅记录,当她售出这张票时,记录对所有人都会更新。集中化的状态使分散化的行动更加安全,因为人们可以与记录进行协调,而不是彼此协调。
关系数据库将这一原则扩展到了整个公司。过去需要报告、会议和管理交接的工作,变成了对共享记录的查询,这使得公司能够在不增加同等比例管理成本的情况下,协调更多的产品、地点、人员和交易。到了 20世纪 90 年代,互联网让外部世界能够向公司的记录写入数据,在线市场可以在数百万陌生人之间协调买家、卖家、库存和支付。
由于内部和外部交易成本都下降了,数据库时代并没有使企业统一变大或变小。相反,它允许更广泛的企业类型存在。大型企业能够管理更多的复杂性,而小型企业则可以租用或购买那些曾经需要整个部门才能提供的能力。
AI 可能也是如此。在企业内部,Agent 可以通过自动化报告、搜索和常规任务来降低协调成本。在企业外部,它们可以帮助寻找和评估供应商、协商常规条款以及监控结果。就像之前的数据库一样,AI 将提高可存在的企业和市场的复杂性上限。但其更具深远影响的效果可能是它如何改变企业的形态。
20 世纪典型的企业呈金字塔形,因为层级制度是其信息处理系统。事实通过报告和会议向上流动,决策向下传达,信息流的地图反映了组织架构图。管理层决定哪些数据值得收集或共享,这意味着公司对自身的认知水平仅取决于其管理者选择收集的内容。
数据库改变了这种结构,但只是部分改变。共享记录允许人们直接访问信息并更独立地行动,但通常是在他人已经设计好的程序内进行。在计算机时代的很长一段时间里,相对较小的一组管理者、运营团队和工程师定义了公司的模式(schemas)、指标、应用程序和工作流——而使用这些系统的员工远多于帮助设计它们的员工。
这不仅限制了人们能做什么,也限制了组织能知道什么。例如,如果她的经理没有撰写包含该信息的报告,那么每周听到几次相同投诉的支持代表所掌握的信息,是公司所不知道的。而解决问题则是另一回事。
现在,了解(knowing)和行动(doing)的技术障碍正在同时降低。
正如 Andrej Karpathy 在 2023 年所说,“最热门的新编程语言是英语。”自然语言界面允许更多的领域专家查询公司数据,而不必等待懂 SQL 或 Python 的人来预判或回答每一个问题。在百年全球医疗保健公司诺和诺德(Novo Nordisk),科学家过去需要等待数据工程师编写查询。现在,他们只需问 Genie:“显示我们所有的肥胖数据”,它便会立即提取相关的试验、见解和可视化图表。
在定义的权限范围内,员工被授权创建解决方案,从而节省数小时甚至数天的工作时间。在电动汽车制造商 Rivian,一位没有 SQL 经验的财务分析师使用 Genie 为 CFO 构建了一个收入仪表板,而一位供应链分析师则构建了一个应用程序来跟踪 inbound inventory shipments(入库库存运输)。
这并不意味着每个人无需批准即可访问公司的所有数据或资源。随着工作日益分散,共享本体(ontology)、权限和问责制变得愈发重要。记录系统(system of record)集中管理状态和护栏(guardrails),同时下放提问、设计工作流和执行行动的权限。
三月,杰克·多西(Jack Dorsey)撰写了一篇题为《从层级到智能》的宣言,描述了他的公司 Block 如何开始测试这一理念的极端版本。“首次,”他写道,“一个系统可以维护整个企业的持续更新模型,并利用它以以前需要人类通过管理层级传递信息的方式协调工作。”
Ali 提出的“Agent 的记录系统”与 Jack 所称的公司“世界模型”(world model)类似——即对公司运营、决策、能力和优先事项的持续更新表示。公司边缘的人员将模型扎根于现实,而模型则提供行动所需的共享上下文。“人们会进入模型尚无法触及的领域。”Dorsey 解释道。“他们能感知到模型无法察觉的事物:直觉、带有偏见的方向、文化背景、信任动态、房间里的氛围。他们会做出模型不应独自做出的判断,尤其是涉及伦理决策、新颖情况以及错误成本具有生存性影响的重大时刻。”结果是,公司需要更少的管理层级来进行协调,并且领导者对工作的可见度更高,即使工作变得更加分散。
Databricks 已经为 Block 提供了部分底层基础设施。它管理并治理着 Square、Cash App 和 TIDAL across 的 PB 级 Block 数据,Block 使用 Databricks 为其 AI 编码助手 goose 提供公司上下文 grounding。
对 Dorsey 而言,这种新架构的竞争优势在于速度。“公司基于信息流动的速度快慢,”他辩称,“层级和中层管理阻碍了信息流动。”
Ali 在方向上同意 Dorsey,但有一个区别。“我在哲学上同意 Jack Dorsey,”他 说。“问题是,这是否也适用于人类组织架构图?”他辩称,人们混淆了两件事:组织架构图和信息在公司中的流动方式。“十到二十年前,这两者是一样的。”了解发生了什么唯一的方法是询问你的人,他们再询问他们的人,沿着层级树上下传递——但这不再成立。“Genie 几乎能回答我在任何会议上关于任何问题的任何疑问,”他补充道。公司仍然需要经理,只是需要更少的信息路由者。培养人才、帮助团队决定什么是重要的,以及察觉某人是否不开心,仍然需要人类的关注。
因此,虽然两人在层级消失的程度上有分歧,但两人都认为 AI 将接管信息路由工作,这些工作曾赋予管理者对二十世纪公司的巨大权力,因为随着公司变得过于复杂,没有它们就无法运营。
第二次管理革命
八十五年前,在大萧条之后,詹姆斯·伯纳姆(James Burnham)写了一本名为《管理革命》(The Managerial Revolution)的书,预见了商业运作方式甚至资本主义本身运作方式的巨大变化。走出大萧条后,一种流行的时髦态度是,企业家资本主义作为一种经济趋势已经走到尽头,某种新系统必将取代它。社会主义集体是当时的一种时髦提议,国有化是另一种。
伯纳姆理解正在发生的事情。他阐述了一种第三种事物,不仅仅是公司结构,而是一种全新的社会秩序,称为“管理社会”(managerial society)。在这个体系中,决定性的统治阶级既不是传统的资本家所有者,也不是工人,而是职业经理人、规划者、官僚和运营大型企业和国家的行政人员。
他认为,现代机构在技术上过于复杂,无法由单个资本家亲自指挥。既然没有一位首席执行官能够了解一家拥有十万名员工的公司内部发生的一切,控制权就会逐渐从所有者和领域专家转移到行政管理人员手中。
在 20 世纪下半叶,管理主义取得了近乎完全的胜利。“《财富》500 强公司的大多数高管都不是公司所在领域的专家,他们肯定也不是这些公司的创始人,”Marc Andreessen 评论道。“他们是职业经理人,事实上,在他们的职业生涯中,他们可能会管理多种不同类型的业务——他们可能在医疗保健行业工作一段时间,然后是金融服务行业,接着又从事其他行业。”
但这种胜利正在自我消耗。Burnham 的管理阶级在可扩展性和专业可靠性方面的优势,是以速度和适应性为代价的,尤其是在面对技术变革时。
也许,正如 Marc 所建议的那样,在像 Databricks 这样坚实的基础之上应用 Agent,可以创造出一种能够兼得两者优势的第三种模式。它有助于保留创始人的活力和适应性,同时重构了规模化所需的管理工作。Agent 通过自动化部分信息路由和协调工作,使更多创始人能够采用这种运营模式,而公司的记录系统则为边缘人员提供了行动所需的上下文和权限。
Elon Musk 将 Marc 的观点更进一步。今年早些时候,他预测那些“人在回路中”的公司将会失败。他认为,在 AI 时代将人类保留在回路中,就像使用需要人工计算某些单元格的电子表格一样。
Elon 关于最终目的地的观点可能是正确的——没人知道完全自主的公司还有多远,预测从几年到永远不等。但在那之前,讽刺的是,管理主义的衰退看起来更像是每个人都在成为管理者。并非每个人都会拥有直接下属,但会有更多的人负责定义工作、委派执行、检查结果并更新流程。第二次管理革命与其说是管理的终结,不如说是职业管理阶级对其垄断地位的终结。
软件工程师今天正深切感受到这一点,因为工作正从手工编写代码转变为管理一个 Agent 团队。工程师的一天越来越像管理者:界定问题,将其分解为任务,委派给并行工作的 Agent,然后审查返回的 pull request——批准一些,并将另一些退回并附上备注。随着 Agent 在更多领域变得有能力,更多的知识工作者将进行类似的转变:从亲自执行每一个步骤,转变为定义、委派和评判工作。Novo Nordisk 的科学家和 Rivian 的供应链分析师已经在使用 Genie 指导 Agent 完成过去需要工程师或数据科学家团队才能完成的工作,从而使这些团队能够专注于最具战略性的工作。
这对人类生产力和薪资来说是好消息,因为执行和判断是经济互补品:当 AI 降低了常规执行的成本时,对指导执行的判断力的需求就会上升。
数学家 Alfred North Whitehead 在一个世纪前观察到:“文明的进步在于扩展了我们无需思考就能执行的重要操作的数量。”企业也以同样的方式进步,通过一个个循环变得更加自主。每次有人纠正一个 Agent 循环时,该纠正都应改善下一次的执行。随着一个循环证明它可以可靠地完成一项有限的任务,人类就会从中退出,转向下一个未解决的问题,并将他们所学到的内容留在公司的共享记录中。
但是,正如伯纳姆可能已经注意到的那样,为了保持主权地位,企业必须拥有自己的模型,以及边缘端人员所教授给它的一切。
主权企业
在代理型企业中,优秀人才的价值将比以往任何时候都更高。但优秀人才也会来来去去。与此同时,模型不断进化,而每个竞争对手都可以租用相同的模型。那么,在这个新世界里,企业究竟如何构建可持续的竞争优势?
考虑两家租用相同前沿模型来辅助信贷决策的银行。第一家银行向模型发送提示词,接收答案,并记录最终决策。第二家银行则记录哪些事实导致了该答案、任何人工覆盖操作、哪些决策表现良好、哪些失败了,并据此调整其政策。一年后,当更先进的模型出现时,只有一家银行成为了更优秀的银行。如果你在贵公司替换了 AI 模型,而新模型继承了你的定义、权限、评估案例、客户历史以及来之不易的特例,这就构成了可持续竞争优势的基础。如果新 AI 模型从与所有人相同的提示词开始,那就不是。
第二家银行就是人们开始称之为“主权”企业的事物。如果提供商提高价格、更改条款或停用某个模型,该企业可以切换提供商而不会丢失其积累的知识。随着模型变得越来越智能,公司对它们的依赖性越来越强,这种独立性就变得越来越重要。
微软首席执行官萨提亚·纳德拉(Satya Nadella)在最近的一篇文章中,出于不同的原因得出了类似的结论。他认为,AI 模型不断吸收人类和组织的专业知识并将其商品化,因此“每家公司都必须构建我认为的人力资本和 token 资本”。人力资本是公司人员拥有的知识、判断力、关系和创造力,而 token 资本是公司构建并拥有的 AI 能力。两者在学习循环中相互叠加,而“这个循环将成为企业新的知识产权(IP)”。
数据是 token 资本的基石。“每家公司的业务数据都是他们的金矿,”英伟达首席执行官黄仁勋在 Databricks 2024 数据 + AI 峰会上对观众表示,解释了英伟达的几乎每个流程都始于数据飞轮,从芯片设计到供应链。“它使我们有可能成为世界上最大的小型公司之一,”他说。当时,英伟达的市值超过 3 万亿美元,而员工人数仅为 3 万。“当然,原因在于我们公司拥有如此多的 AI 帮助我们,做着令人惊叹的事情。”黄仁勋认为这将适用于每家公司。“这是一个非凡的时代,”他说,“而这一切始于数据。”
Databricks 押注的是,数据和基于此构建的循环应存在于企业控制的系统中。甚至包括 Databricks 自己的专用模型,它多年来一直针对企业工作负载进行优化。重要的是循环,而不仅仅是数据;这也是他们自 2023 年(在所有人都意识到之前)以来的关注重点。所有权本身不是护城河,但它防止企业的记忆被困在某个供应商的堆栈中。只有当数据和 AI 在分析这些数据时帮助企业比竞争对手更快地改进其决策和产品时,护城河才会出现。
Databricks 很早就建立了这种能力。Spark 是开源的,因此客户可以自行下载并运行它。但最终,创始人了解到,如果 Databricks 能让 Spark 运行更简单、更快、更安全、对企业更有用,客户愿意为此付费。为了生存,他们必须比免费替代品更快地为客户创造价值。随着智能体降低寻找和切换到替代品的成本,更多公司将面临类似的考验。
你将拥有的最佳想法
大约十年前,阿里(Ali)就向我寻求建议。当时,全球最大的一些公司之一曾提出以相当于其上一轮融资估值约六倍的价格收购 Databricks。
考虑到就在两年前,这家公司几乎倒闭,甚至找不到 Series C 轮的主投方,这看起来简直是一个梦幻般的结局。我们在 2013 年领投了该公司的 Series A 轮,当时公司由七位伯克利学者组成,唯一的经常性收入来自他们自己会议的门票销售。随后,我们联合 NEA 一起领投了其他投资者都不愿参与的 Series C 轮。
阿里 记得 那次对话比我还清楚:
“嘿,你想怎么做就怎么做。无论哪种情况,我都会支持你。实际上,如果你以这个价格出售,对我来说真的很好:a16z 会赚很多钱,我会让投资者们获得数倍的回报。老实说,对我个人而言,那可能是更好的选择。但我只是回想一下。我曾担任 Loudcloud 和 Opsware 的 CEO——那家公司给我的牌子和你现在拥有的公司不一样。当我回顾过去时,人生中有多少次机会能拥有像 Loudcloud 或 Opsware 这样的公司,更不用说 Databricks 了?这是一个如此巨大的市场。你可以出售并赚取大量金钱,你将在人生中取得巨大成功。但如果你像我一样,你会在余生中一直想着:‘我错过了那次机会。那是唯一的机会,我应该全力以赴。而现在我将永远不知道我能走多远。’所以,你是想带着这种遗憾生活,还是只想拥有金钱?无论你想做什么,我都会支持。”
阿里说了声谢谢,然后挂断了电话。接着他自言自语道:“我们绝不会这么做。这事不会发生。”
你很少能遇到如此优质的市场机会与如此优秀的创业者结合的情况。这是极其罕见的事情。我们见过许多优秀的创业者,但他们的市场机会有限;我们也见过拥有巨大市场机会的公司,但创业者不足以实现这一潜力。但这一次,我们两者兼备。
上个月,Databricks 的年收入运行率突破了 70 亿美元,同比增长 80%,估值达到 1900 亿美元。事实证明,这位创业者足够强大。
而 TAM(总潜在市场)正是公司本身的基石——一个共享的记录系统,它定义了什么是真实的、数据意味着什么、谁可以做什么以及什么行之有效。有了这个基础,人和 Agent(智能体)可以自主行动,无需将每个决策都层层上报给管理层,同时他们的行动结果也会回流到公司拥有的记录中。
协调成本将下降,公司现有的人员能完成更多工作,以前说不通的新公司也将得以建立,因为十个人就能完成过去需要成千上万人才能做的事。而在 AI 能够像优秀的人一样处理所有事务之前——这还有很长的路要走——这将使优秀的人更有价值,而非更无价值。
由于 Agent 将处理那些已经被解决的工作,将只有少数人执行他人设计的流程。更多的人将致力于尚未解决的问题——判断什么是好的、察觉什么发生了变化,并决定接下来应该存在什么。
在未来几十年里,人们整天会在工作中做什么?诚实的回答是:做任何尚未被解决的问题。随着 Agent 和公司自动化我们已知的工作,人们将与这种新智能合作,构建令人惊叹的新事物,并解决以前无法触及的问题。
 SpaceX & the Sentient SunMarc Andreessen and Michael McGuiness·Jun 15Read full storyBase Power & the Future of ElectricityErin Price-Wright and Michael McGuiness·Aug 4Read full story
本通讯仅供信息参考,不应被视为法律、商业、投资或税务建议。此外,本内容不构成投资建议,也不旨在供任何 a16z 基金的投资者或潜在投资者使用。本通讯可能链接到其他网站或包含从第三方来源获取的其他信息——a16z 未独立核实此类信息的当前或持续准确性,也不对此类信息作出任何陈述。如果本内容包含第三方广告,a16z 未审查此类广告,也不认可其中包含的任何广告内容或相关公司。文中提及、引用或描述的任何投资或投资组合公司并不代表 a16z 管理的所有车辆中的所有投资;请访问 https://a16z.com/investment-list/ 获取完整的投资列表。其他重要信息可在 a16z.com/disclosures 找到。您收到此通讯是因为您之前已选择加入;如果您希望退订未来的通讯,您可以立即取消订阅。
关于此帖的讨论
https://substack.com/profile/32064242-john-galt-iii?utm_source=commentJohn Galt III21小时前
Databricks - 价值 1900 亿美元 - 70 亿美元收入 - 如果你问美国 100 个随机的人这家公司是做什么的,你可能会得到一两个甚至听说过这家公司的人。
因为我是个技术文盲,即使读了这篇写得很好的文章,我仍然不确定 Databricks 的产品是什么,但结果似乎是效率,以及各个领域的公司能够在保留自己的数据和知识产权的同时创建自己的 AI 程序。
无论如何,很高兴美国有这样的聪明、有才华的人,以及支持他们的私人基金。 回复分享https://substack.com/profile/122694523-david-smukowski?utm_source=commentDavid Smukowski17小时前
虽然“交易成本”本可以通过互联网和现在的 AI 在数据集中化后消除,但成本实际上在增加。计算机被教导在需求定价、减少透明度、期货合约等方面制造更多的摩擦。
未来的现实是 Databricks 和其他公司会拿走你的数据,有时会用更多的数据(比如医疗记录)来修饰它,并要求你付费才能拿回来。
证据是巨大的数万亿美元投资。他们想要回他们的钱,还要利息。而且这利息是高利贷。 回复分享还有 6 条评论...
没有帖子