Agent 的上下文工程(Context Engineering)从检索(Retrieval)开始
原文链接: https://www.langchain.com/blog/context-engineering-starts-with-retrieval 来源: www.langchain.com 发现于: 管理台手动提交 说明: 本文由 AIHot汪 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
AI 总结
作者:Jess Weng
发布时间:2026 年 10 月 23 日
来源:LangChain 官方博客
文章核心观点:Agent 的上下文工程(Context Engineering)从检索(Retrieval)开始。Agent 的上下文窗口有限,无法记住所有信息,必须高效检索正确内容。检索环节如果出问题,后续的上下文管理再好也没用。
Agent 检索的三大常见问题
低效搜索
反复打开文件、反复换关键词,浪费大量 token 和时间,上下文很快被搜索结果占满。一次塞入过多上下文
一次返回完整大数据导出或大量文档,直接撑爆上下文窗口,留给实际工作的空间所剩无几。无关或过时信息
错误或过时的内容进入上下文后,Agent 会基于错误信息继续推理,错误会被放大。
应对策略(以 Deep Agents 为例)
1. 解决低效搜索
- 优先使用内置文件系统工具:
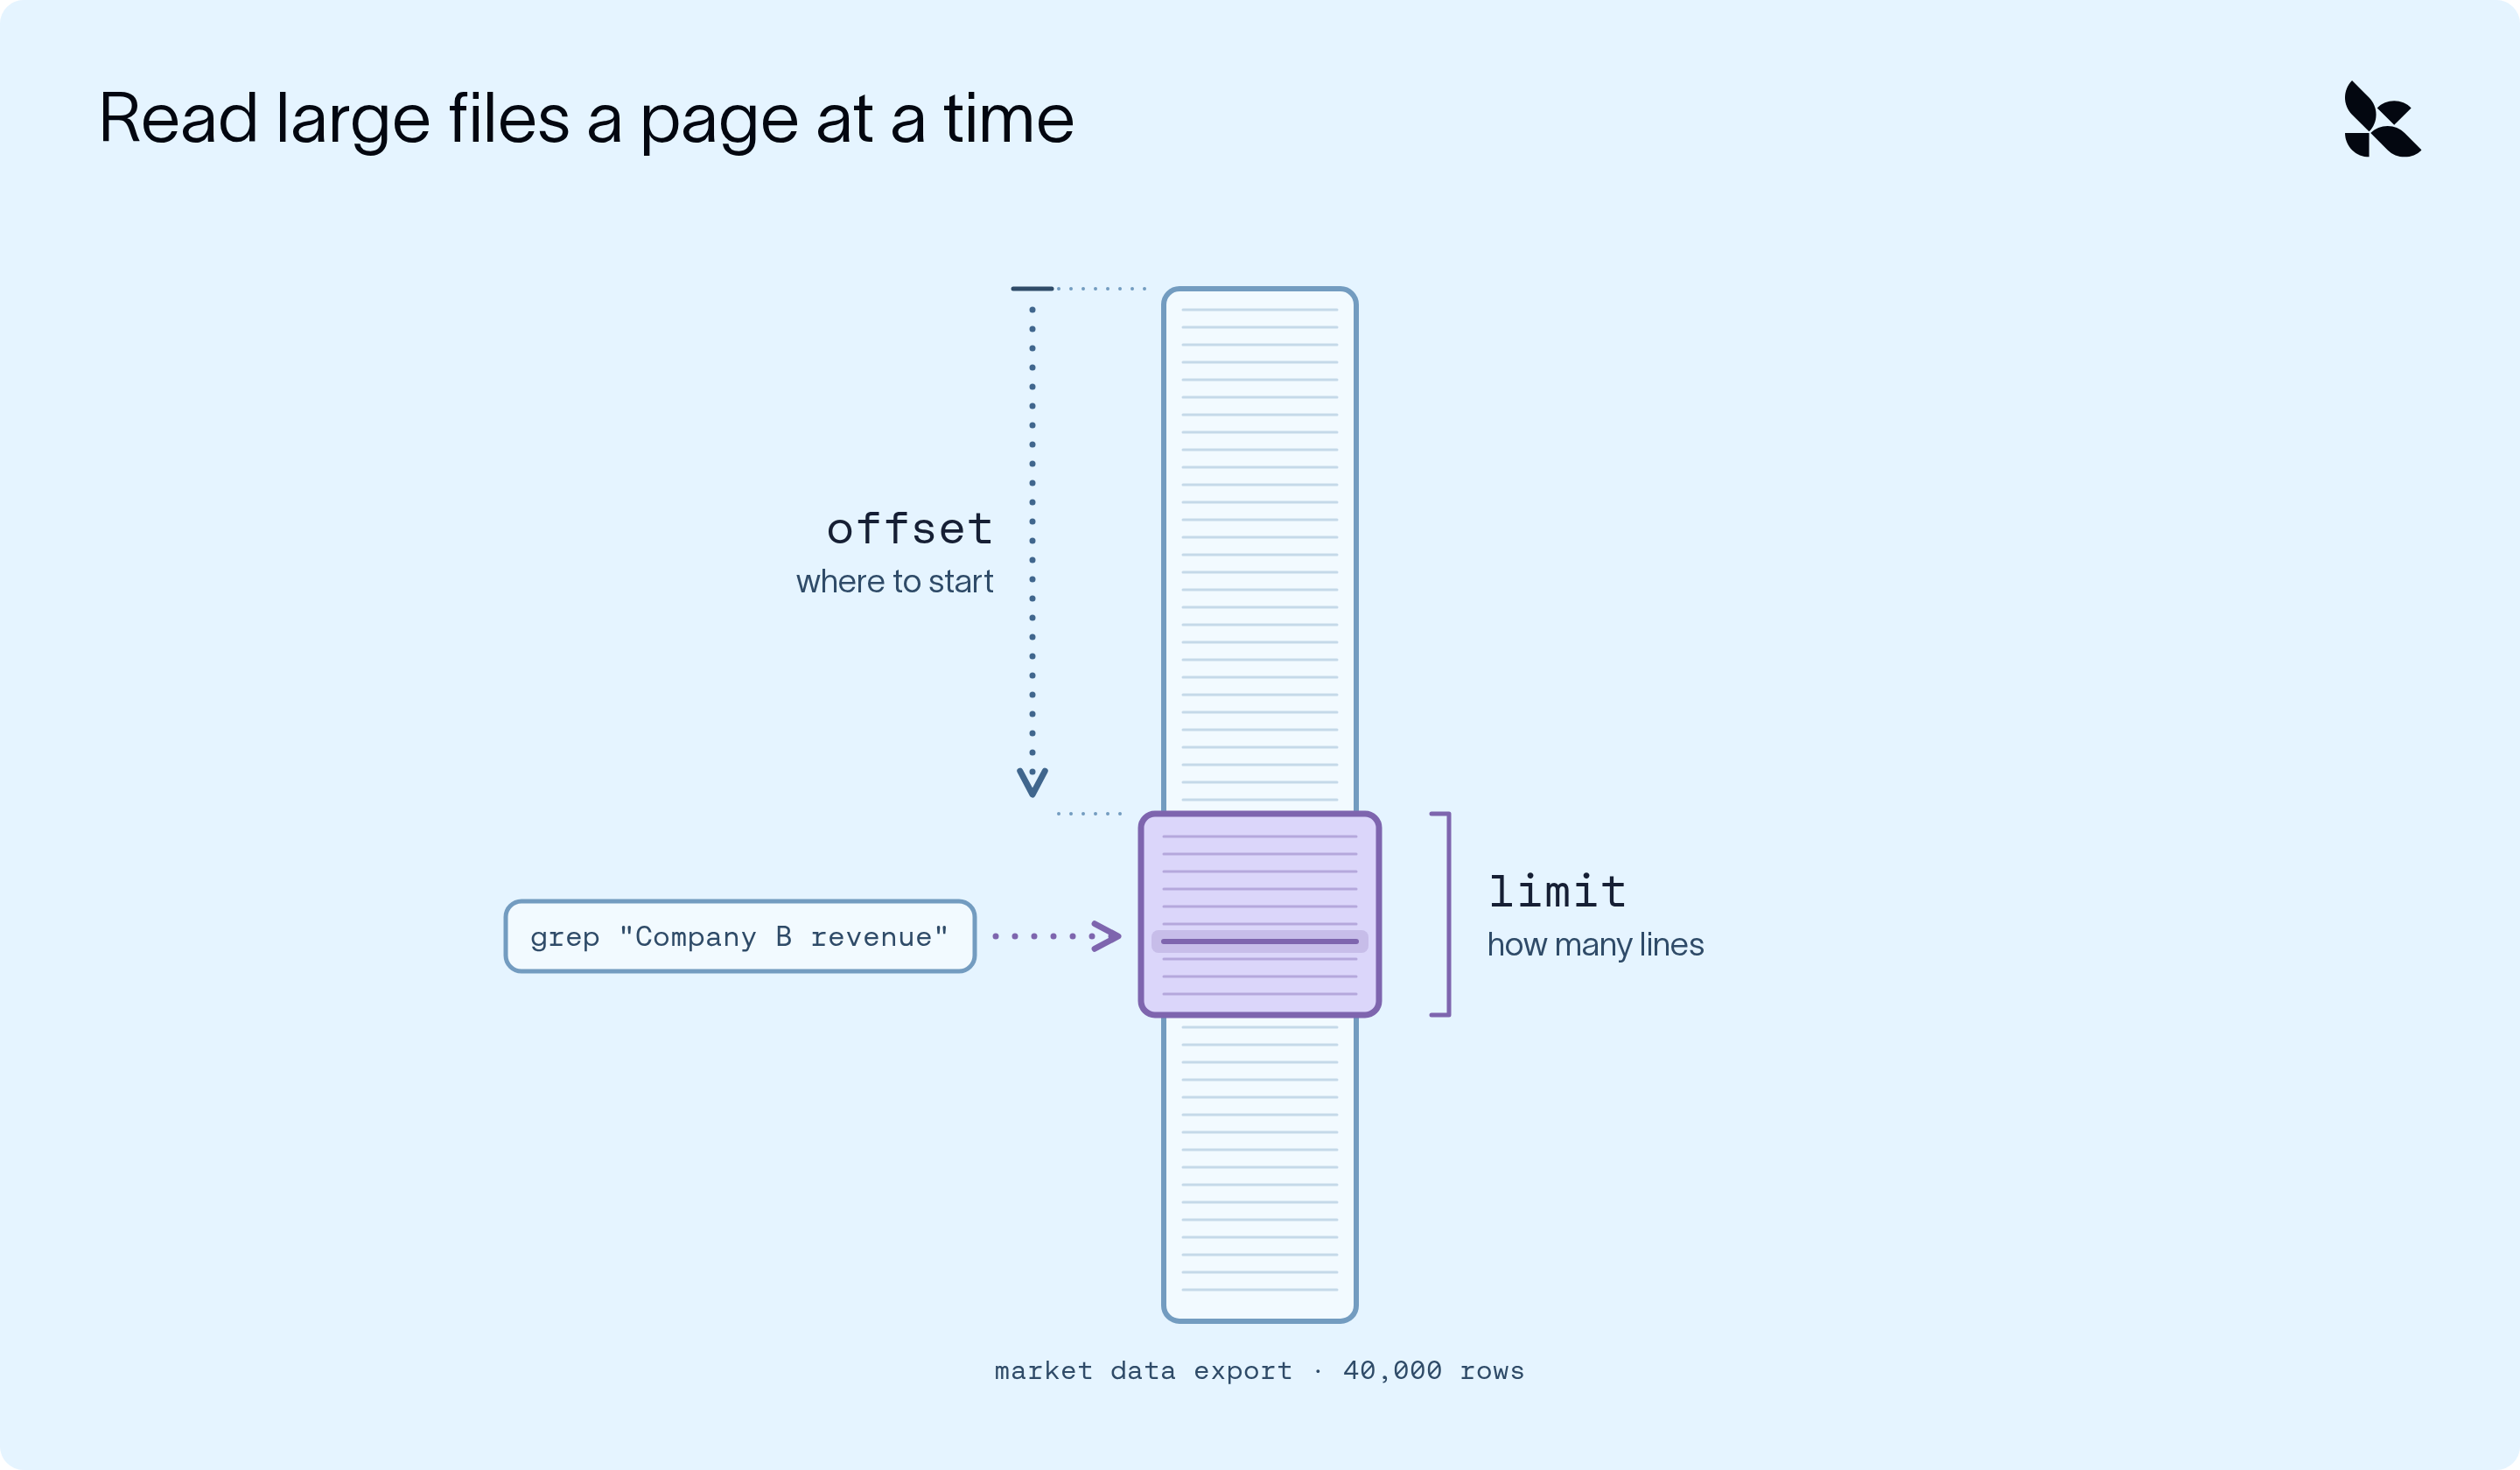
glob:按文件名模式匹配(先看名字)grep:在不加载整个文件的情况下搜索关键词read_file:按页读取(默认 100 行),支持 offset + limit
- 关键词不够时再引入语义检索工具(向量库 / RAG)
- 采用 Agentic Retrieval:让 Agent 自己决定何时搜索、搜什么、是否需要继续搜(而不是一开始固定搜一次)
- 把搜索经验打包成 Skill(渐进式披露,只在需要时加载完整指令)
2. 解决一次塞入过多信息
- 大文件分页读取
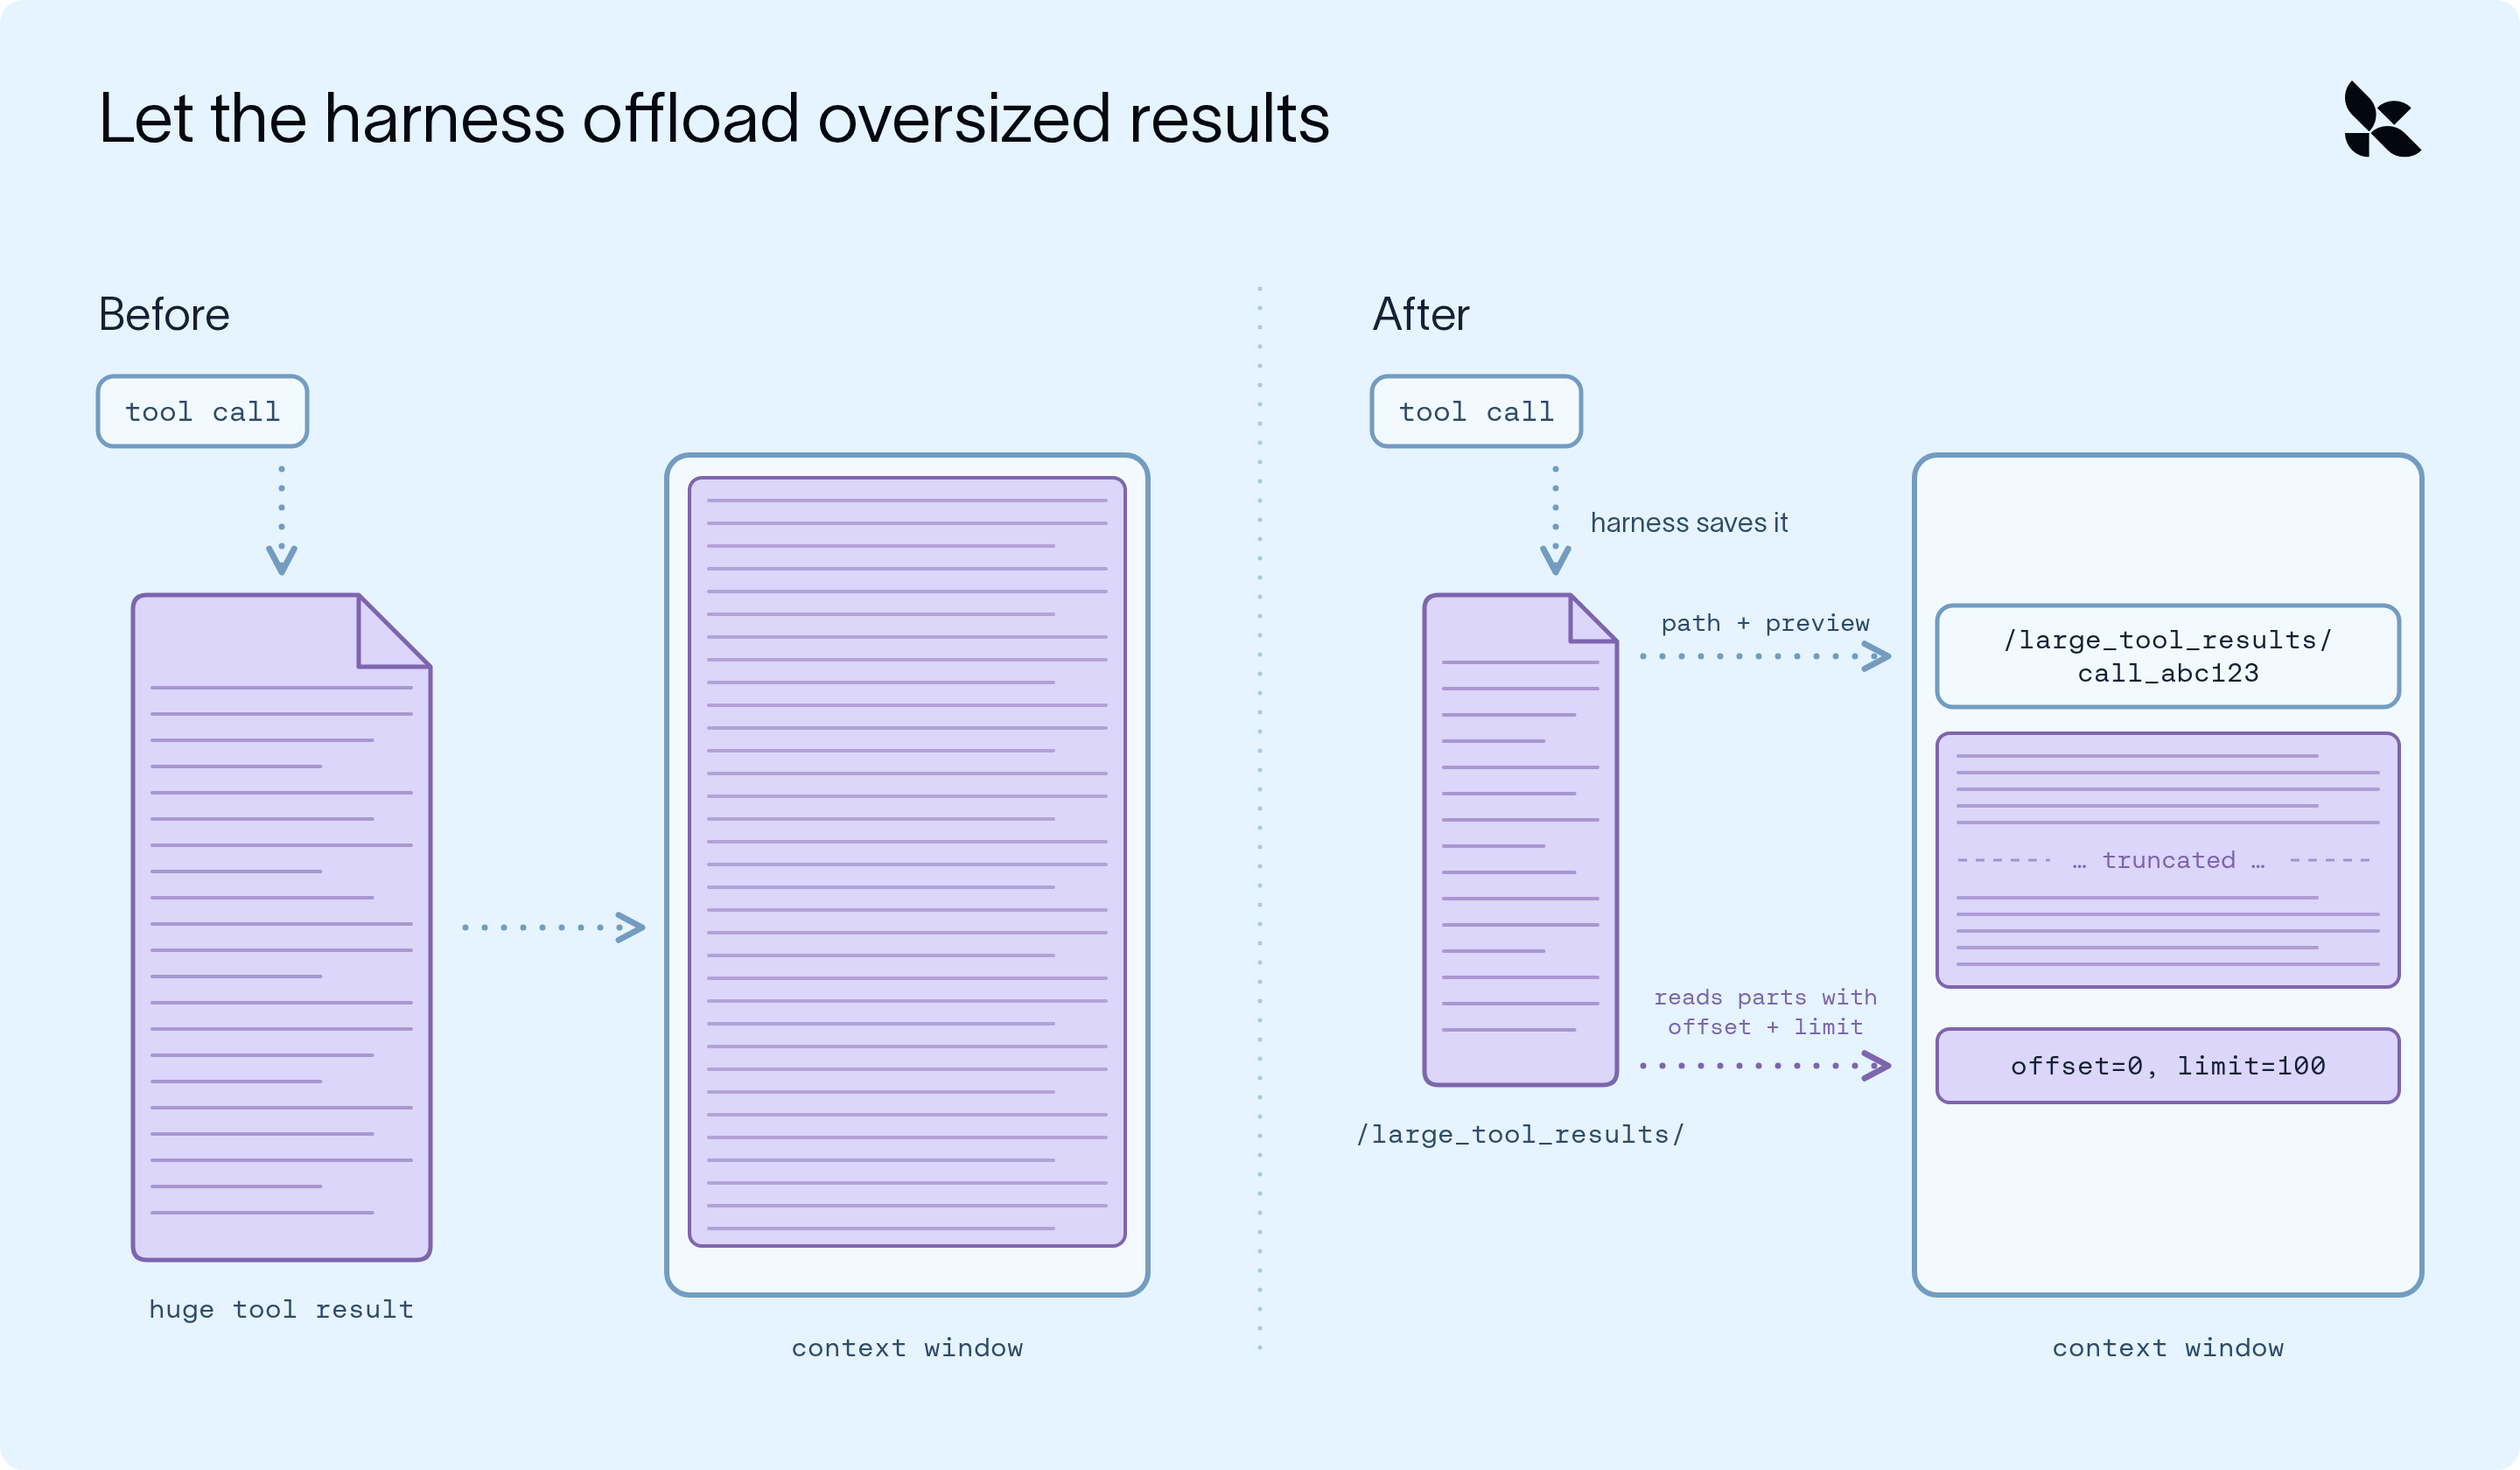
- Offload 机制:工具结果过大时,Harness 自动把完整内容存成文件,只返回路径 + 预览
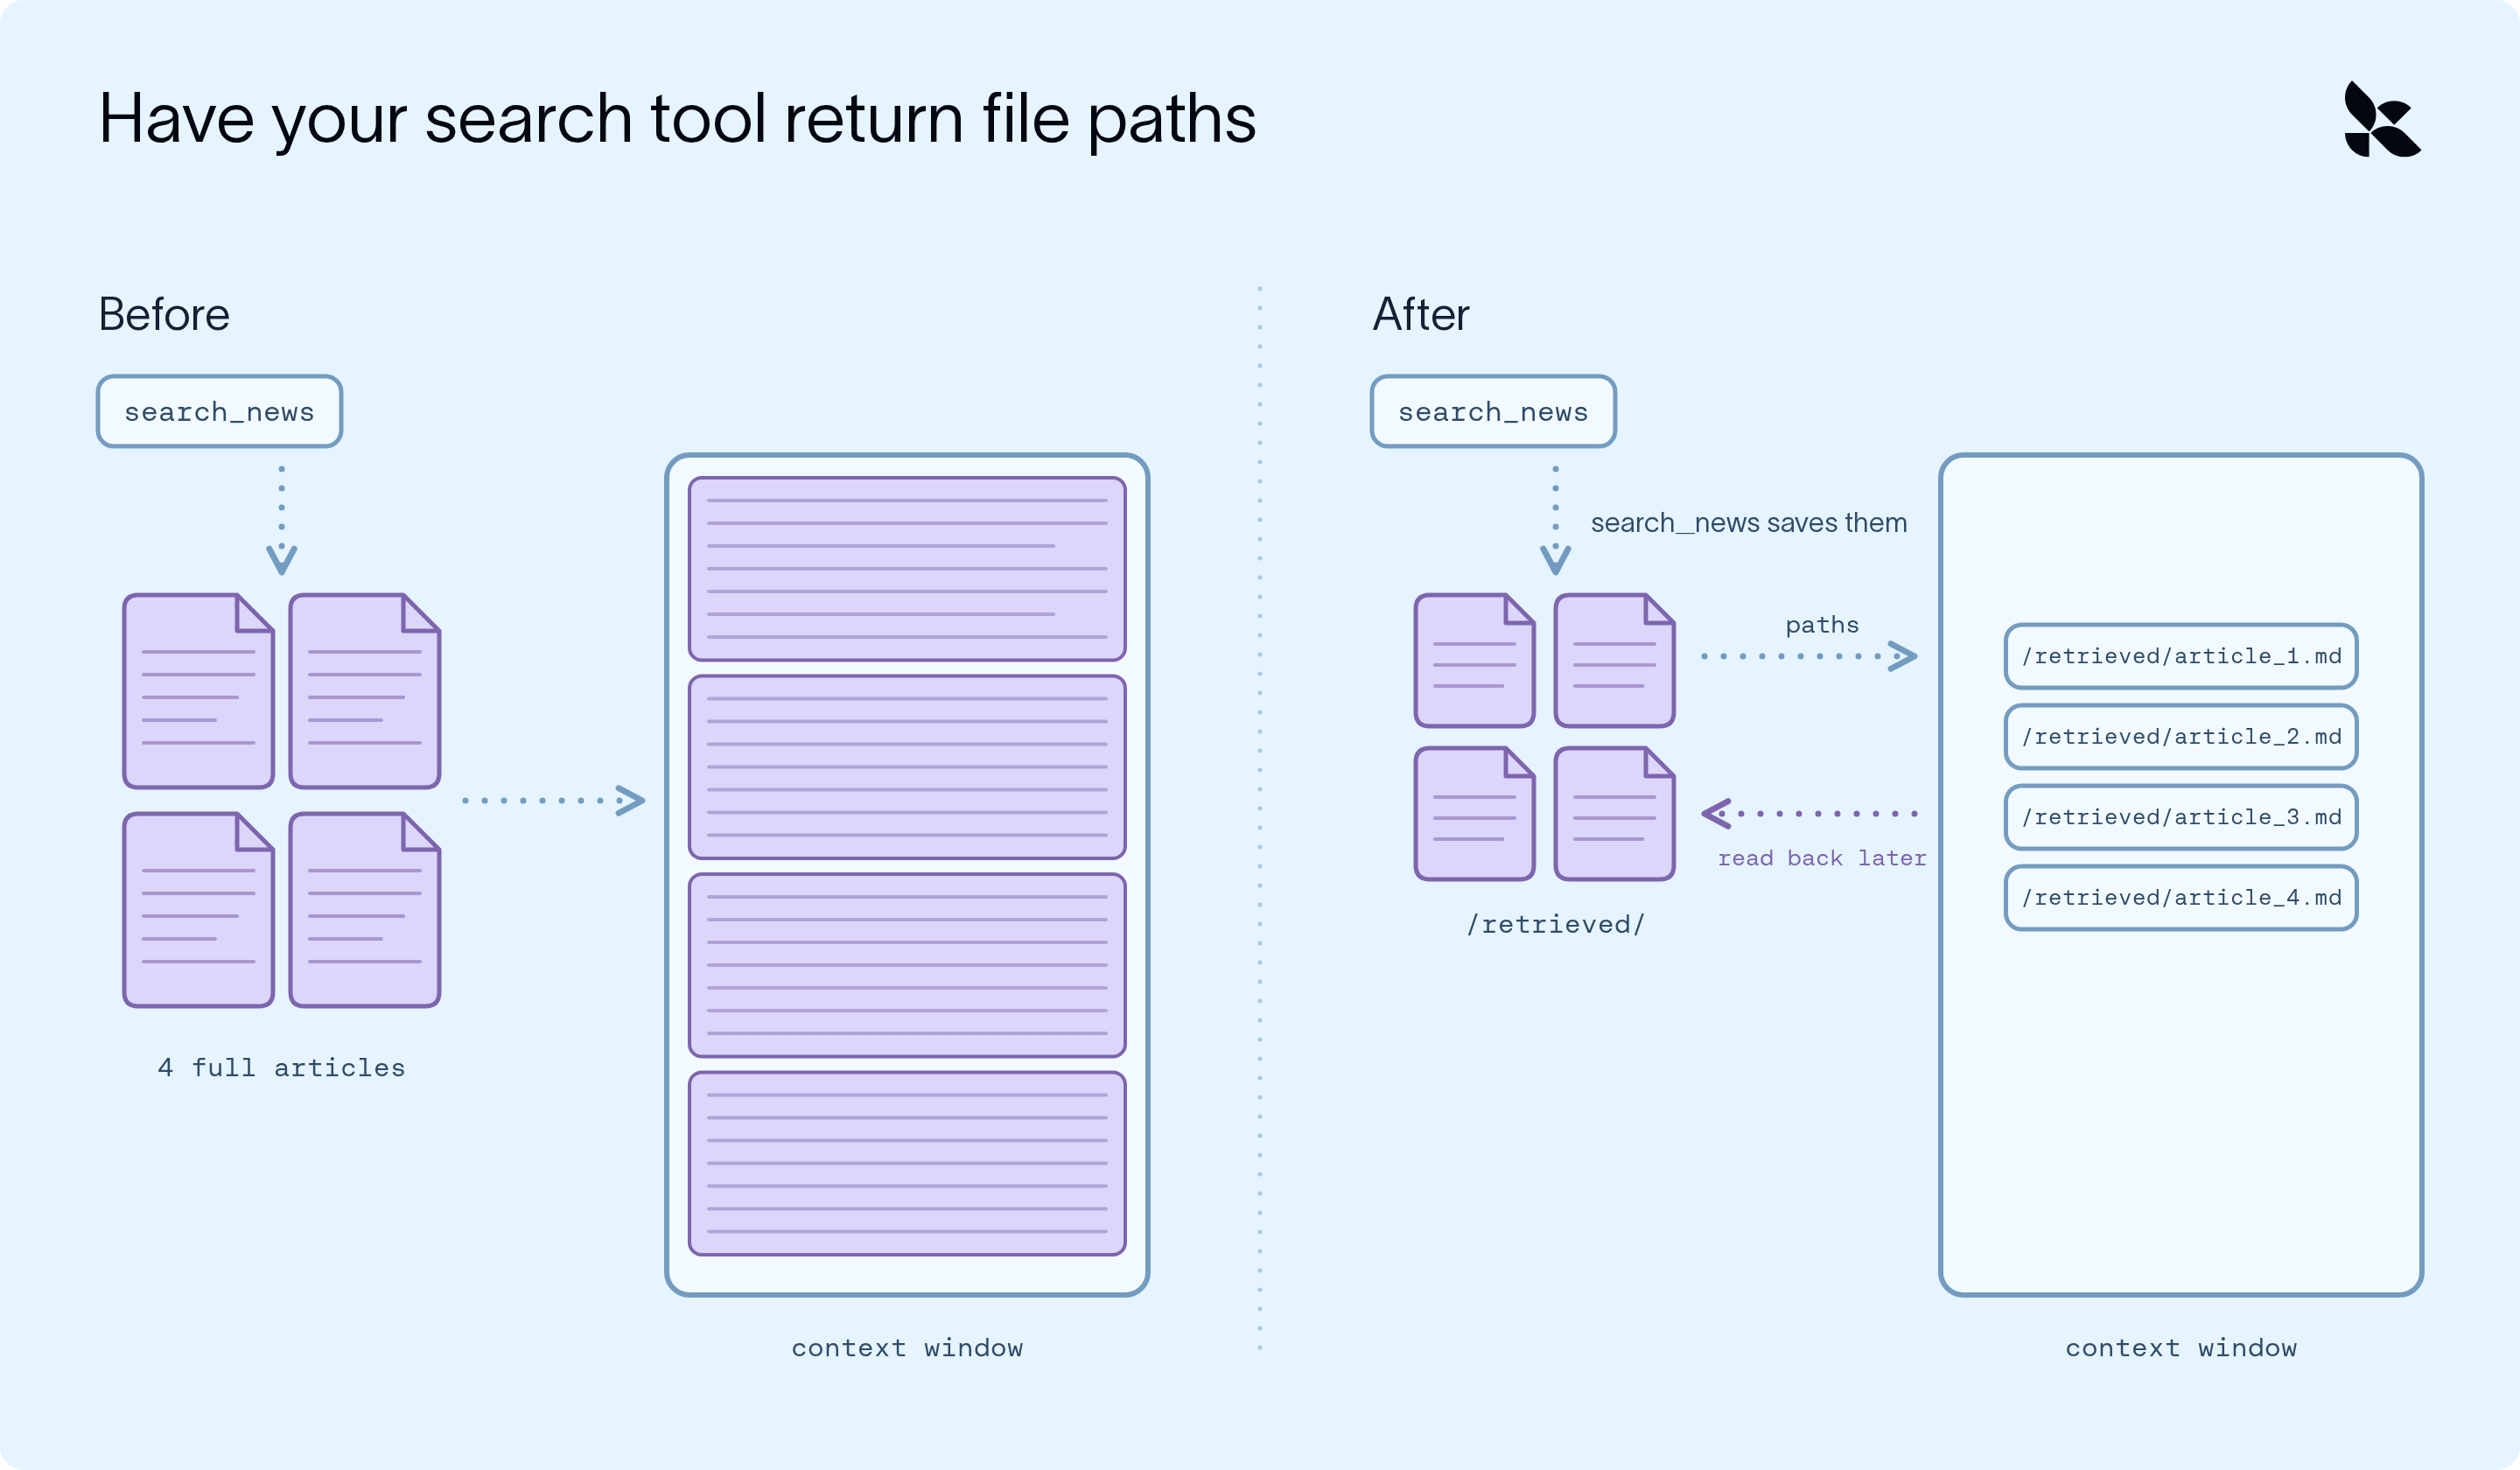
- 自定义检索工具也采用同样思路:检索 → 保存为文件 → 只返回路径
3. 解决无关/过时信息
- 采用 “Retrieve → Offload → Delegate” 模式:
- 检索并保存为文件
- 主 Agent 只拿到路径
- 把阅读任务委托给 Subagent(子 Agent),由子 Agent 过滤并返回关键事实
- 主 Agent 最终只看到结论,无关内容留在子 Agent 的上下文中
- 确保数据源尽量新鲜(用搜索 API、按日期过滤等)
- 对检索到的内容保持警惕(可能存在 prompt injection),验证回答是否有据可依
核心检索原则总结
- 优先用最轻量、最高效的工具(知道关键词就用 grep,别一上来就语义搜索)
- 分页读取,而不是一次性加载
- 返回指针(文件路径),而不是完整内容
- 把阅读和过滤委托给子 Agent
- 验证回答是否真正 grounded 在检索结果上
结论
Retrieval(检索)是 Context Engineering 的第一道关卡。Deep Agents 通过内置文件系统工具、自动 offload、子 Agent 委托等机制,从底层帮助 Agent 做到“在正确的时间拿到正确的上下文”。
文章最后也提到,检索只是一半,另一半是如何管理已经进入上下文的信息(另有一篇配套博客专门讲这个主题)。
深度智能体概念指南
上下文工程始于检索
 Jess Weng2026年10月23日
 12分钟返回博客创建智能体创建智能体分享https://www.langchain.com/blog/context-engineering-starts-with-retrieval#https://www.langchain.com/blog/context-engineering-starts-with-retrieval#https://www.langchain.com/blog/context-engineering-starts-with-retrieval#
关键要点
- 智能体受限于有限的上下文窗口,信息检索会出现三种失效情况:搜索效率低下、一次性上下文过多、以及无关或过时的上下文。
- Deep Agents harness 默认保持搜索范围小巧。内置的文件系统工具在读取之前先进行搜索:glob 匹配文件名,grep 查找匹配行,read_file 逐页读取。过大的工具结果会被卸载:完整结果保存至文件,但智能体仅获得路径和预览。
- 对于自定义搜索工具(如 RAG),请使用“检索、卸载、委派”策略:将结果保存至文件,返回路径,并让子智能体进行读取。主智能体仅看到相关内容。
想象一下你在参加开卷考试:你理论上拥有所有答案,但这反而让找到正确的答案变得更加困难。
- 你该从哪里开始搜索?
- 你如何确认资料来源的正确性?
- 你如何优化时间,以免将精力浪费在重复的搜索上?
高效地找到正确信息并非易事。
将一个问题交给智能体,它会面临类似的困境:它拥有有限的上下文窗口,因此像人类一样,它必须检索信息以完成特定任务(而不是依靠记忆)。在搜索过程中,智能体会遇到以下困难:
- 搜索效率低下: 每次搜索都消耗 token 和时间。搜索笨拙的智能体(例如,打开每个文件只是为了查看内容,或者不断重新表述同一个查询)会在找到任何有用信息之前,用搜索结果填满其上下文。
- 一次性上下文过多: 一次搜索如果转储完整的数据导出或十几份文档,会瞬间填满上下文窗口,不留任何空间用于实际工作。
- 无关或过时的上下文: 过时或偏离主题的信息对模型来说可能看起来与正确答案同样具有说服力。一旦进入上下文窗口,智能体可能会在此基础上构建(错误将在后续每一步中延续)。
幸运的是,智能体有多种技术可用于检索正确的信息。智能体 harness 的职责是战略性地应用这些技术,从而为给定任务在正确的时间提供正确的上下文。
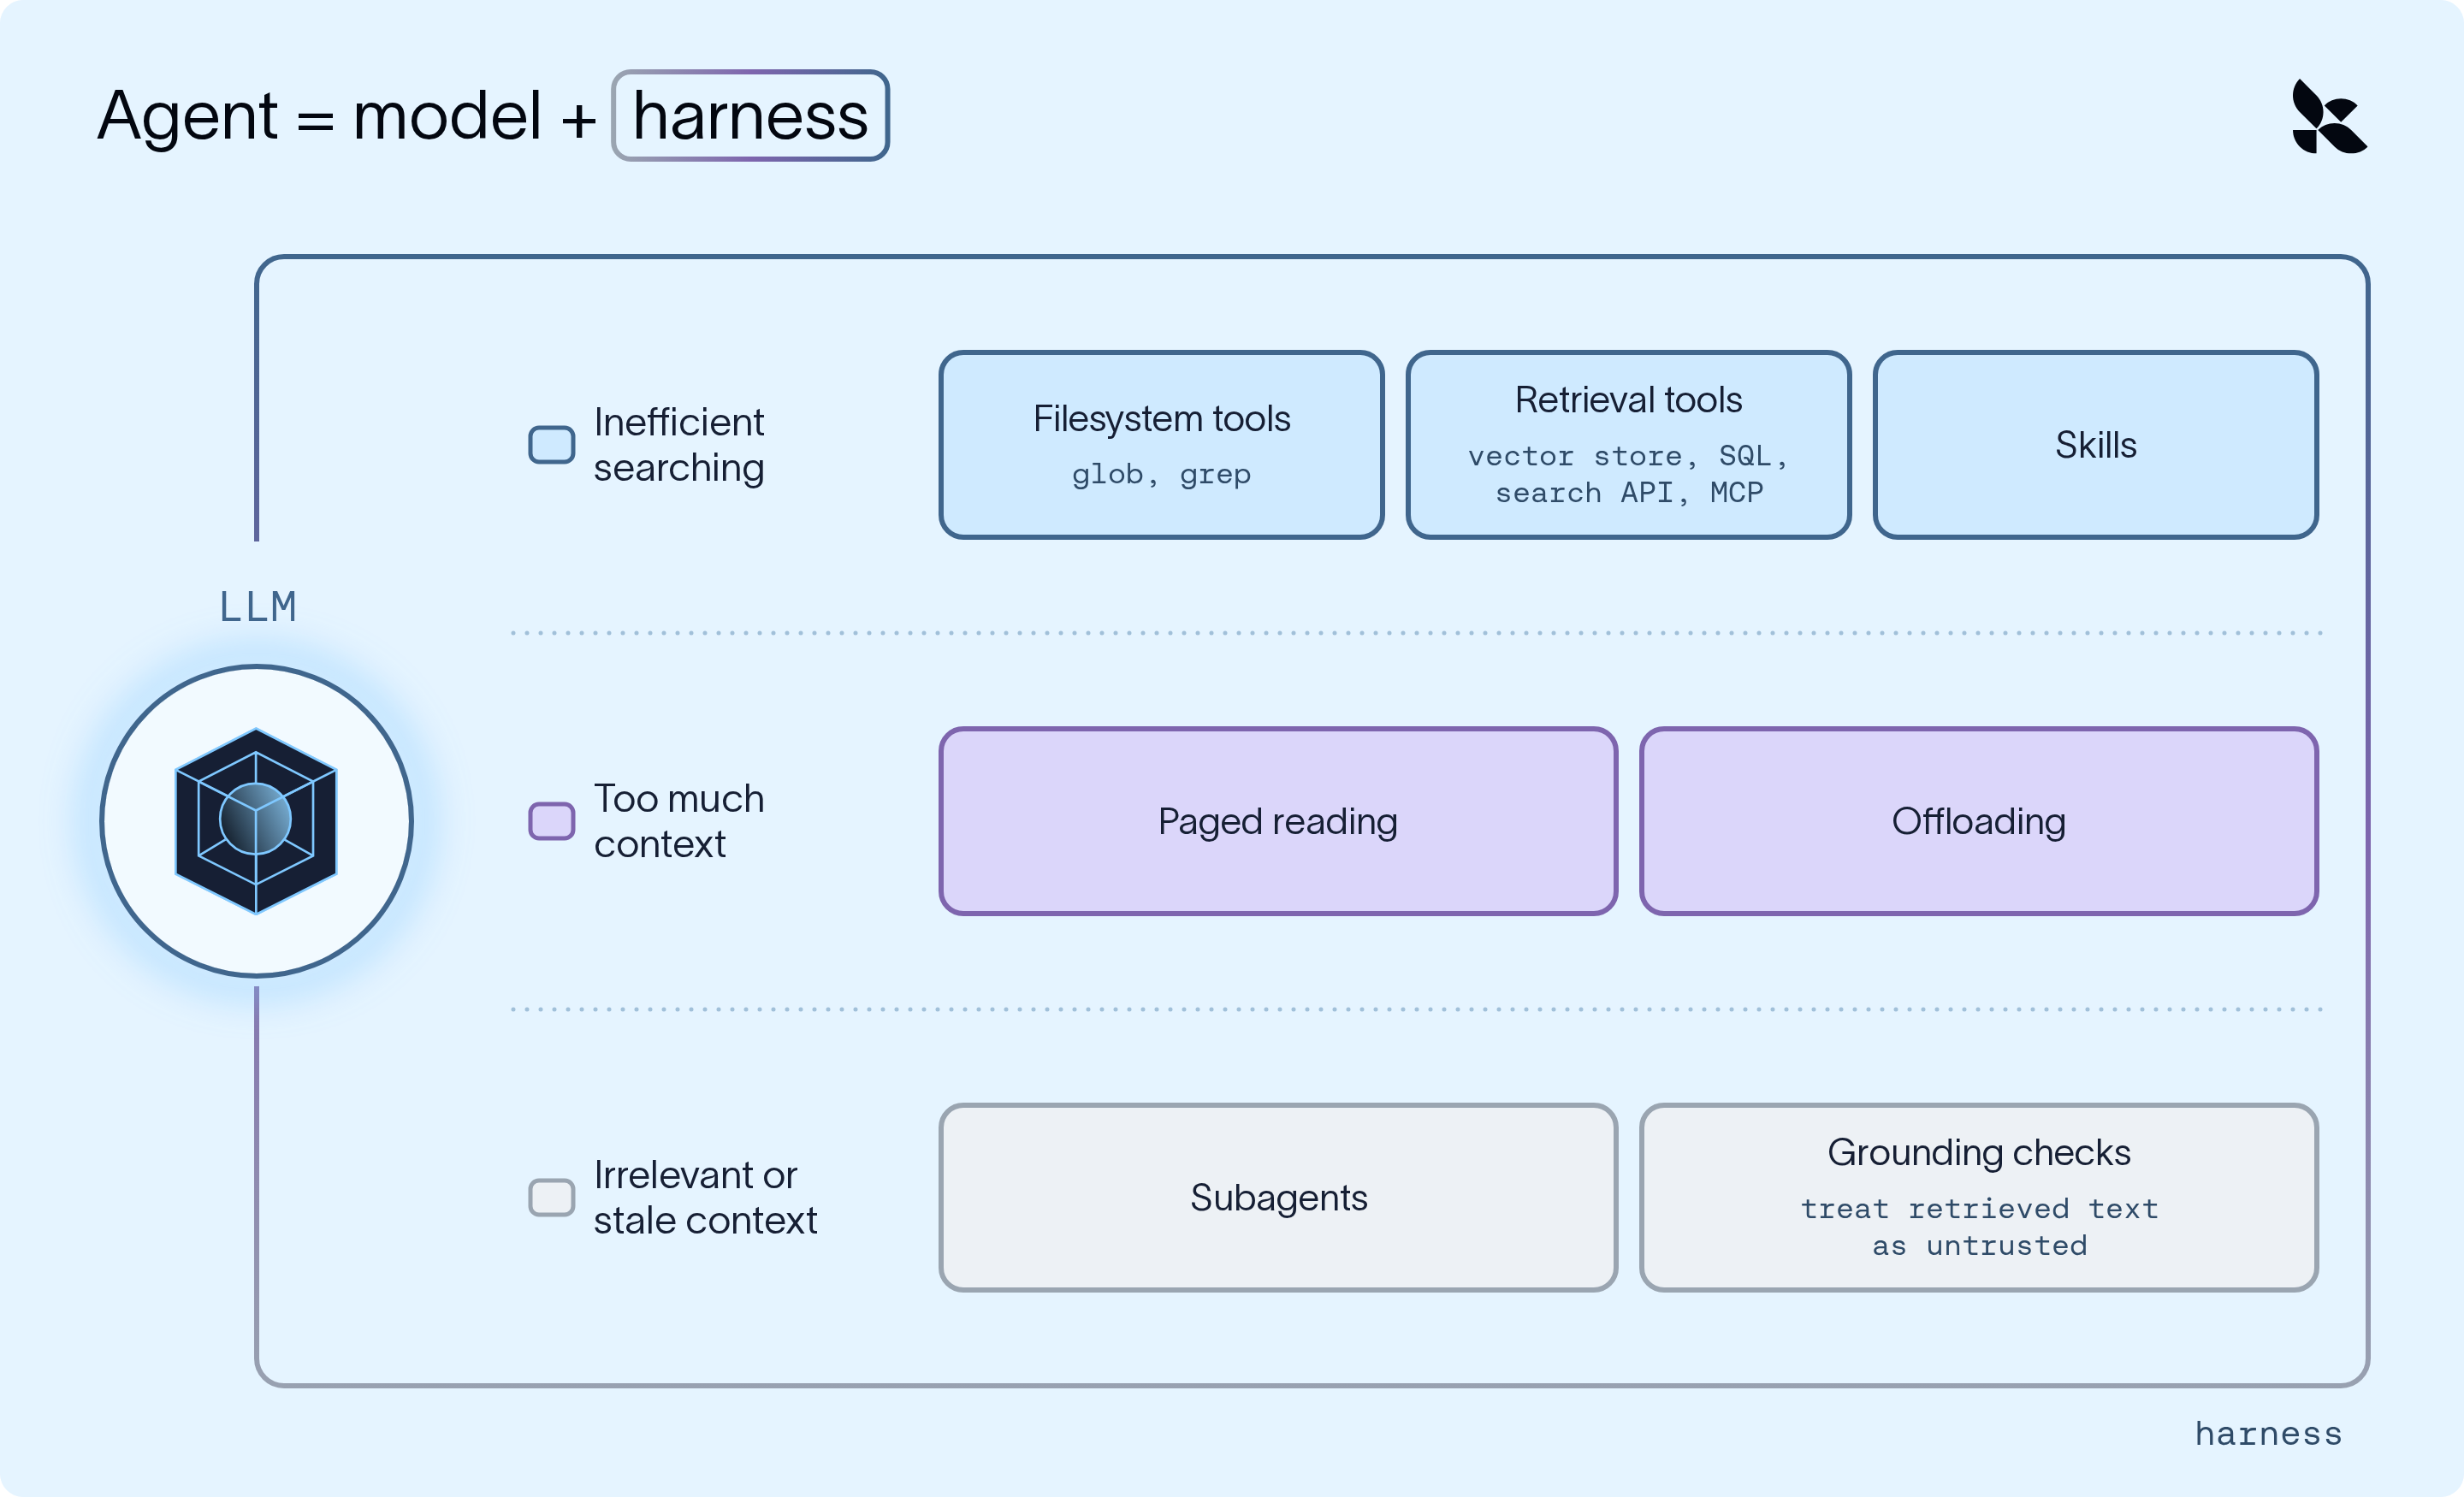
本文涵盖智能体检索(仅查找并引入任务所需的信息)面临的挑战、我们可用的对抗技术,以及在设计智能体 harness 时如何牢记这些要点(以 LangChain 的 Deep Agents harness 为例)。
如需了解更多关于上下文进入上下文窗口之后的管理方法,请参阅这篇关于 上下文工程 的博客。
我们的示例:一个竞品分析 Agent
让我们看看这些方法如何应用于真实场景:一个竞品分析 Agent。每周一,该 Agent 会调研数百个竞争对手,并按照团队的模板撰写一份报告。它需要:
- 找到上周关于 Company A 的笔记
- 在庞大的市场数据导出文件中查找某个具体的营收数字
- 在新闻存档中搜索任何新动态
这每一项都是不同类型的检索,因此面临的问题也各不相同。我们使用 Deep Agents harness 构建了这个 Agent,因此有一些开箱即用的技术可以用来尽量减少这些问题。
1. 低效搜索
我们的 Agent 要为每个竞争对手找到三样东西。如果每样都要尝试十几次(打开文件只是为了看看里面有什么,或者因为来源用词不同而重新措辞搜索),那么在写出报告的第一个字之前,它的 context window 就已经被失败的搜索填满了。
因此,最好的搜索是 Agent 无需重复的那一种,这意味着要为每项任务使用合适的工具。
从内置的 filesystem 工具开始
Agent 搜索信息最常见的方式之一是使用 filesystem。然而,如果我们的 Agent 打开每个文件只是为了看看里面有什么,那它的搜索效率会非常低:它读取的每个文件都会进入它的 context window,仅仅“翻看”就能把窗口填满。
更好的做法是先检查名称和关键词(就像开卷考试时先翻书末的索引,而不是逐页阅读)。两个常用的 filesystem 工具恰好能做到这一点:
glob按名称模式查找文件。例如,**/company-a*.md可以找到上周关于 Company A 的笔记。grep在文件内部进行搜索,而不会将文件加载到 context window 中。它匹配字面文本,可以返回匹配的文件、匹配的行或匹配次数。
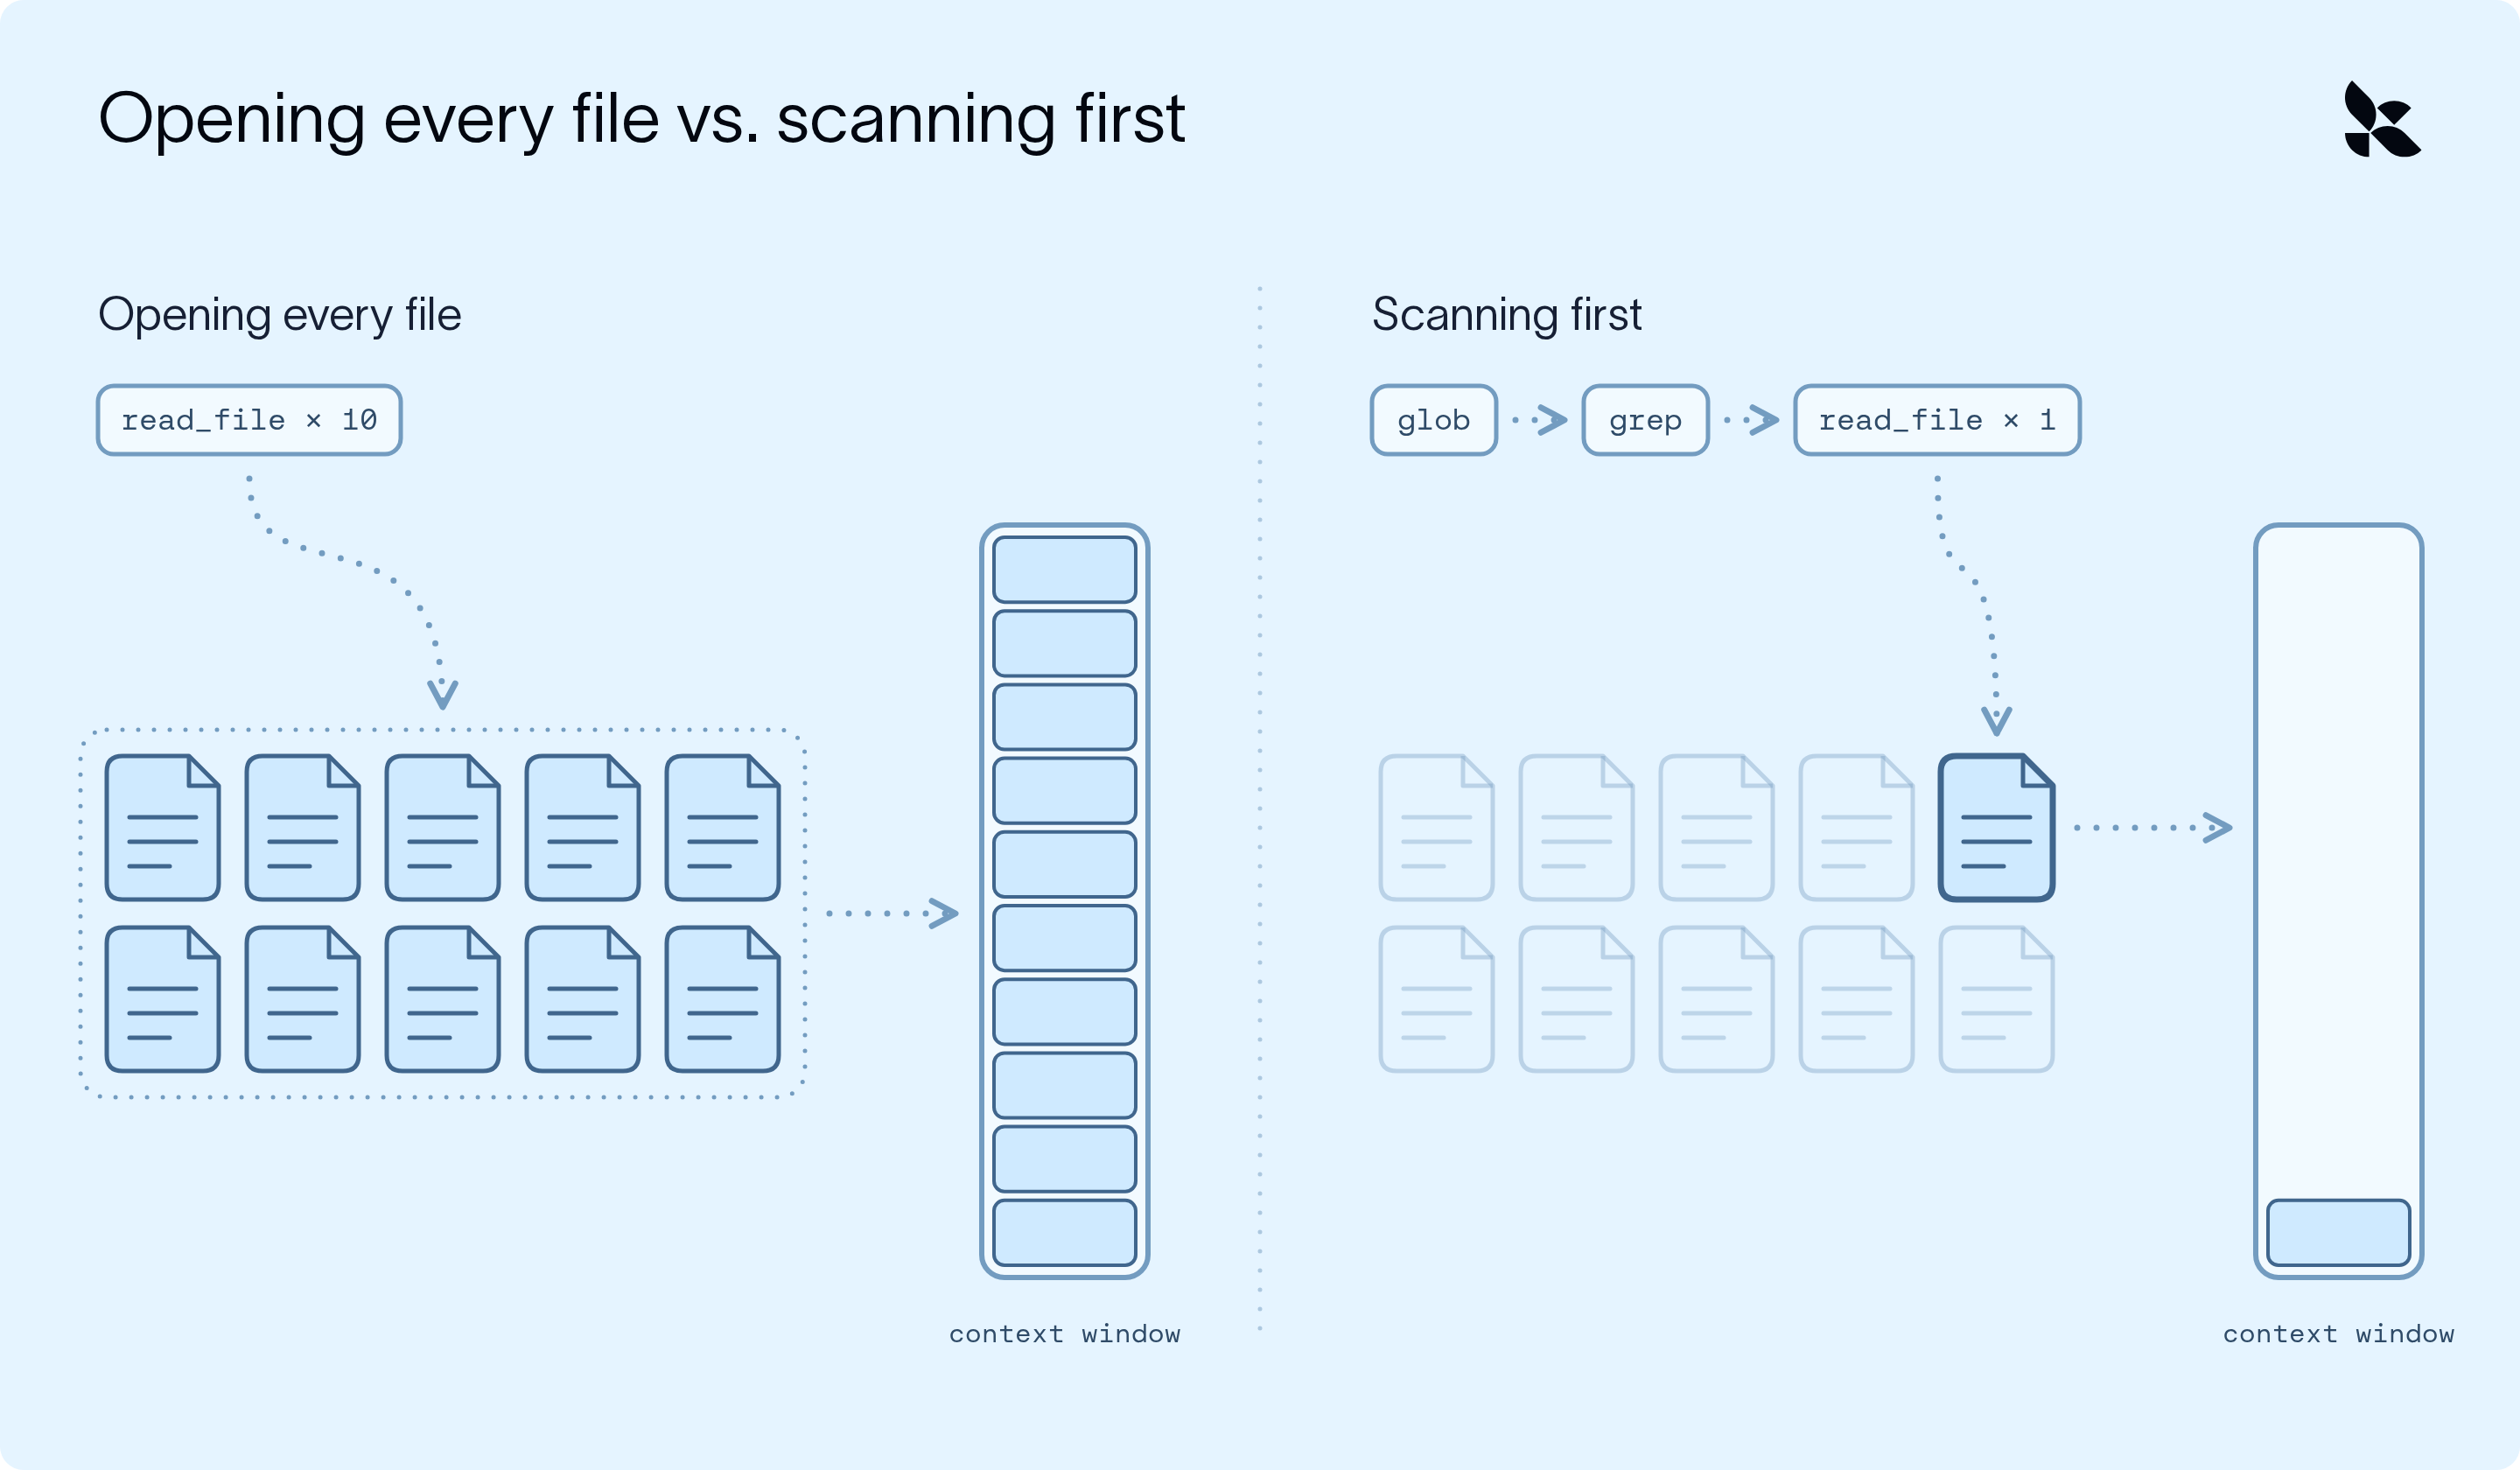
每个 deep agent 都内置了这些工具,此外还有 ls、read_file、write_file 和 edit_file。无论文件存储在哪里(agent state、本地磁盘、持久化存储还是 sandbox),这些工具都能正常工作,因为它们都通过 Agent 的 backend 来处理。
当关键词不够用时,添加 retrieval tool
当你知道要找什么词时,Grep 非常好用,但它只能匹配你给出的确切文本。对于我们示例中的第三项任务——在新闻存档中搜索新动态——这就是个问题。如果我们的 Agent 用 grep 搜索 "Company A funding",它就会漏掉一篇标题为 "Company A closes $50M Series B" 的文章,尽管那正是它要找的内容。
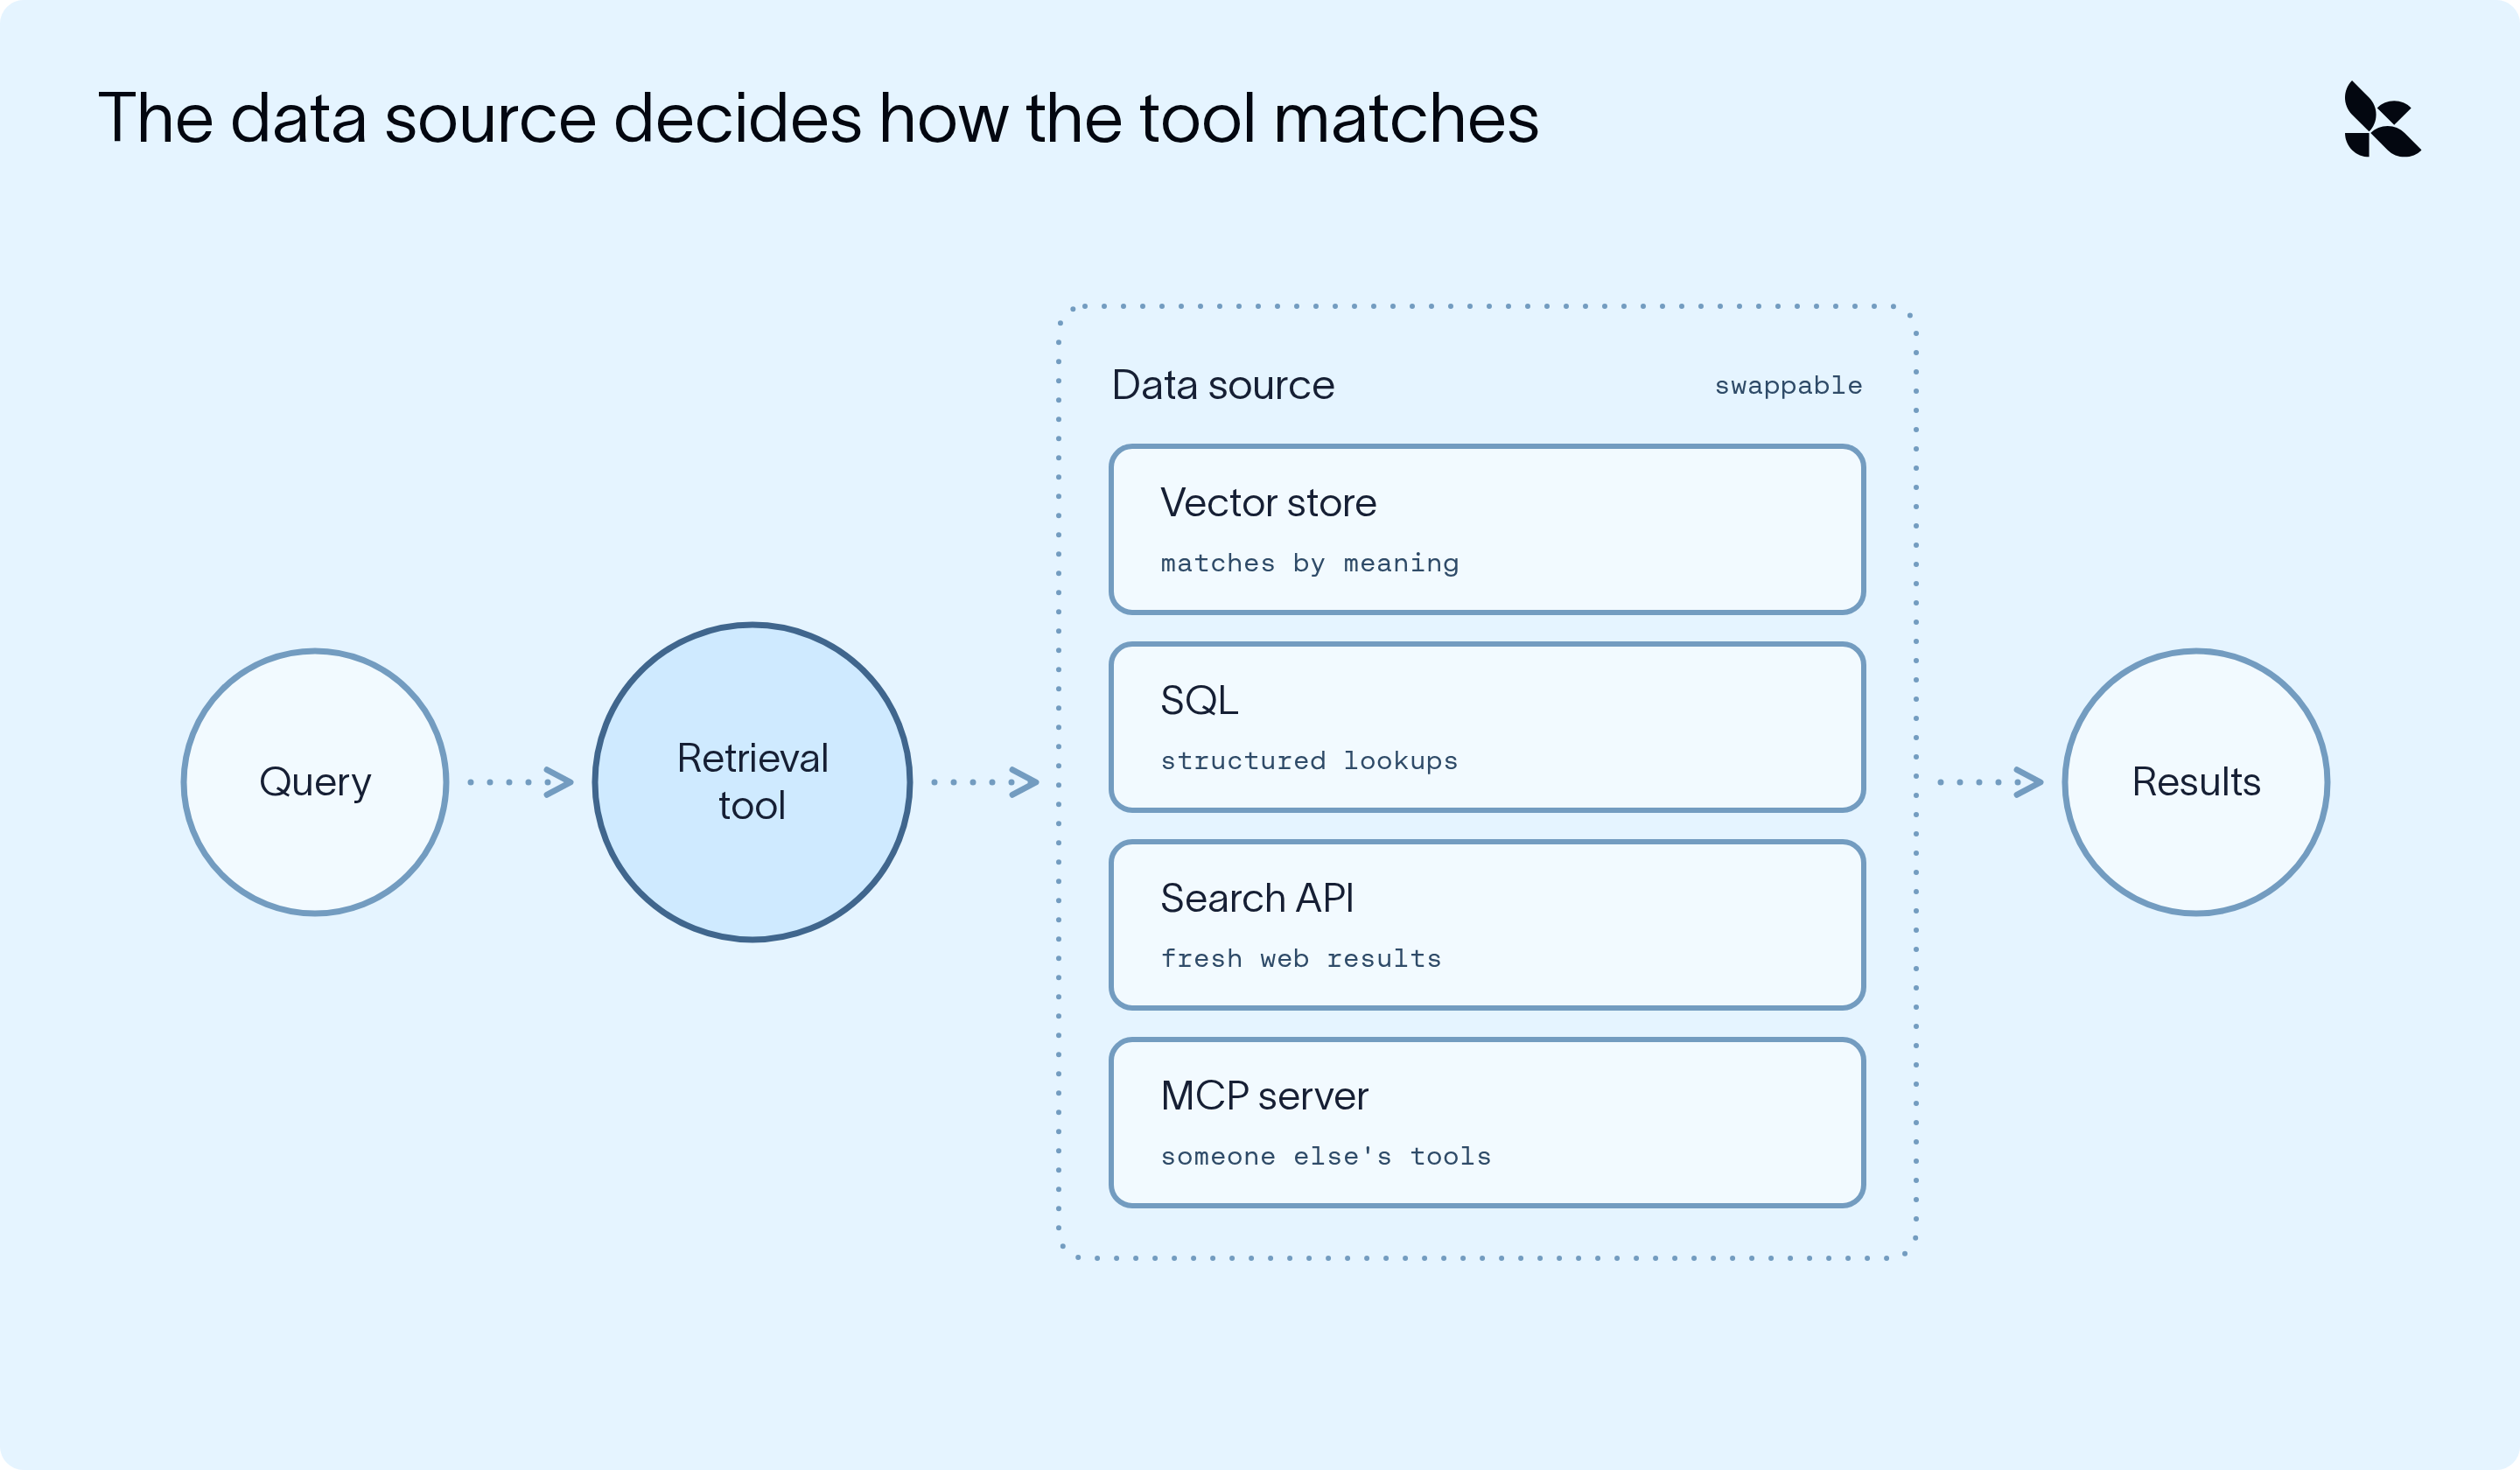
要按含义而非确切词语进行搜索(semantic search),你需要添加一个由 vector store 支撑的 retrieval tool。retrieval tool 是指 Agent 可以调用来获取信息的任何工具:它接收一个 query,在某个数据源中查找,并返回找到的结果(最接近的匹配)。
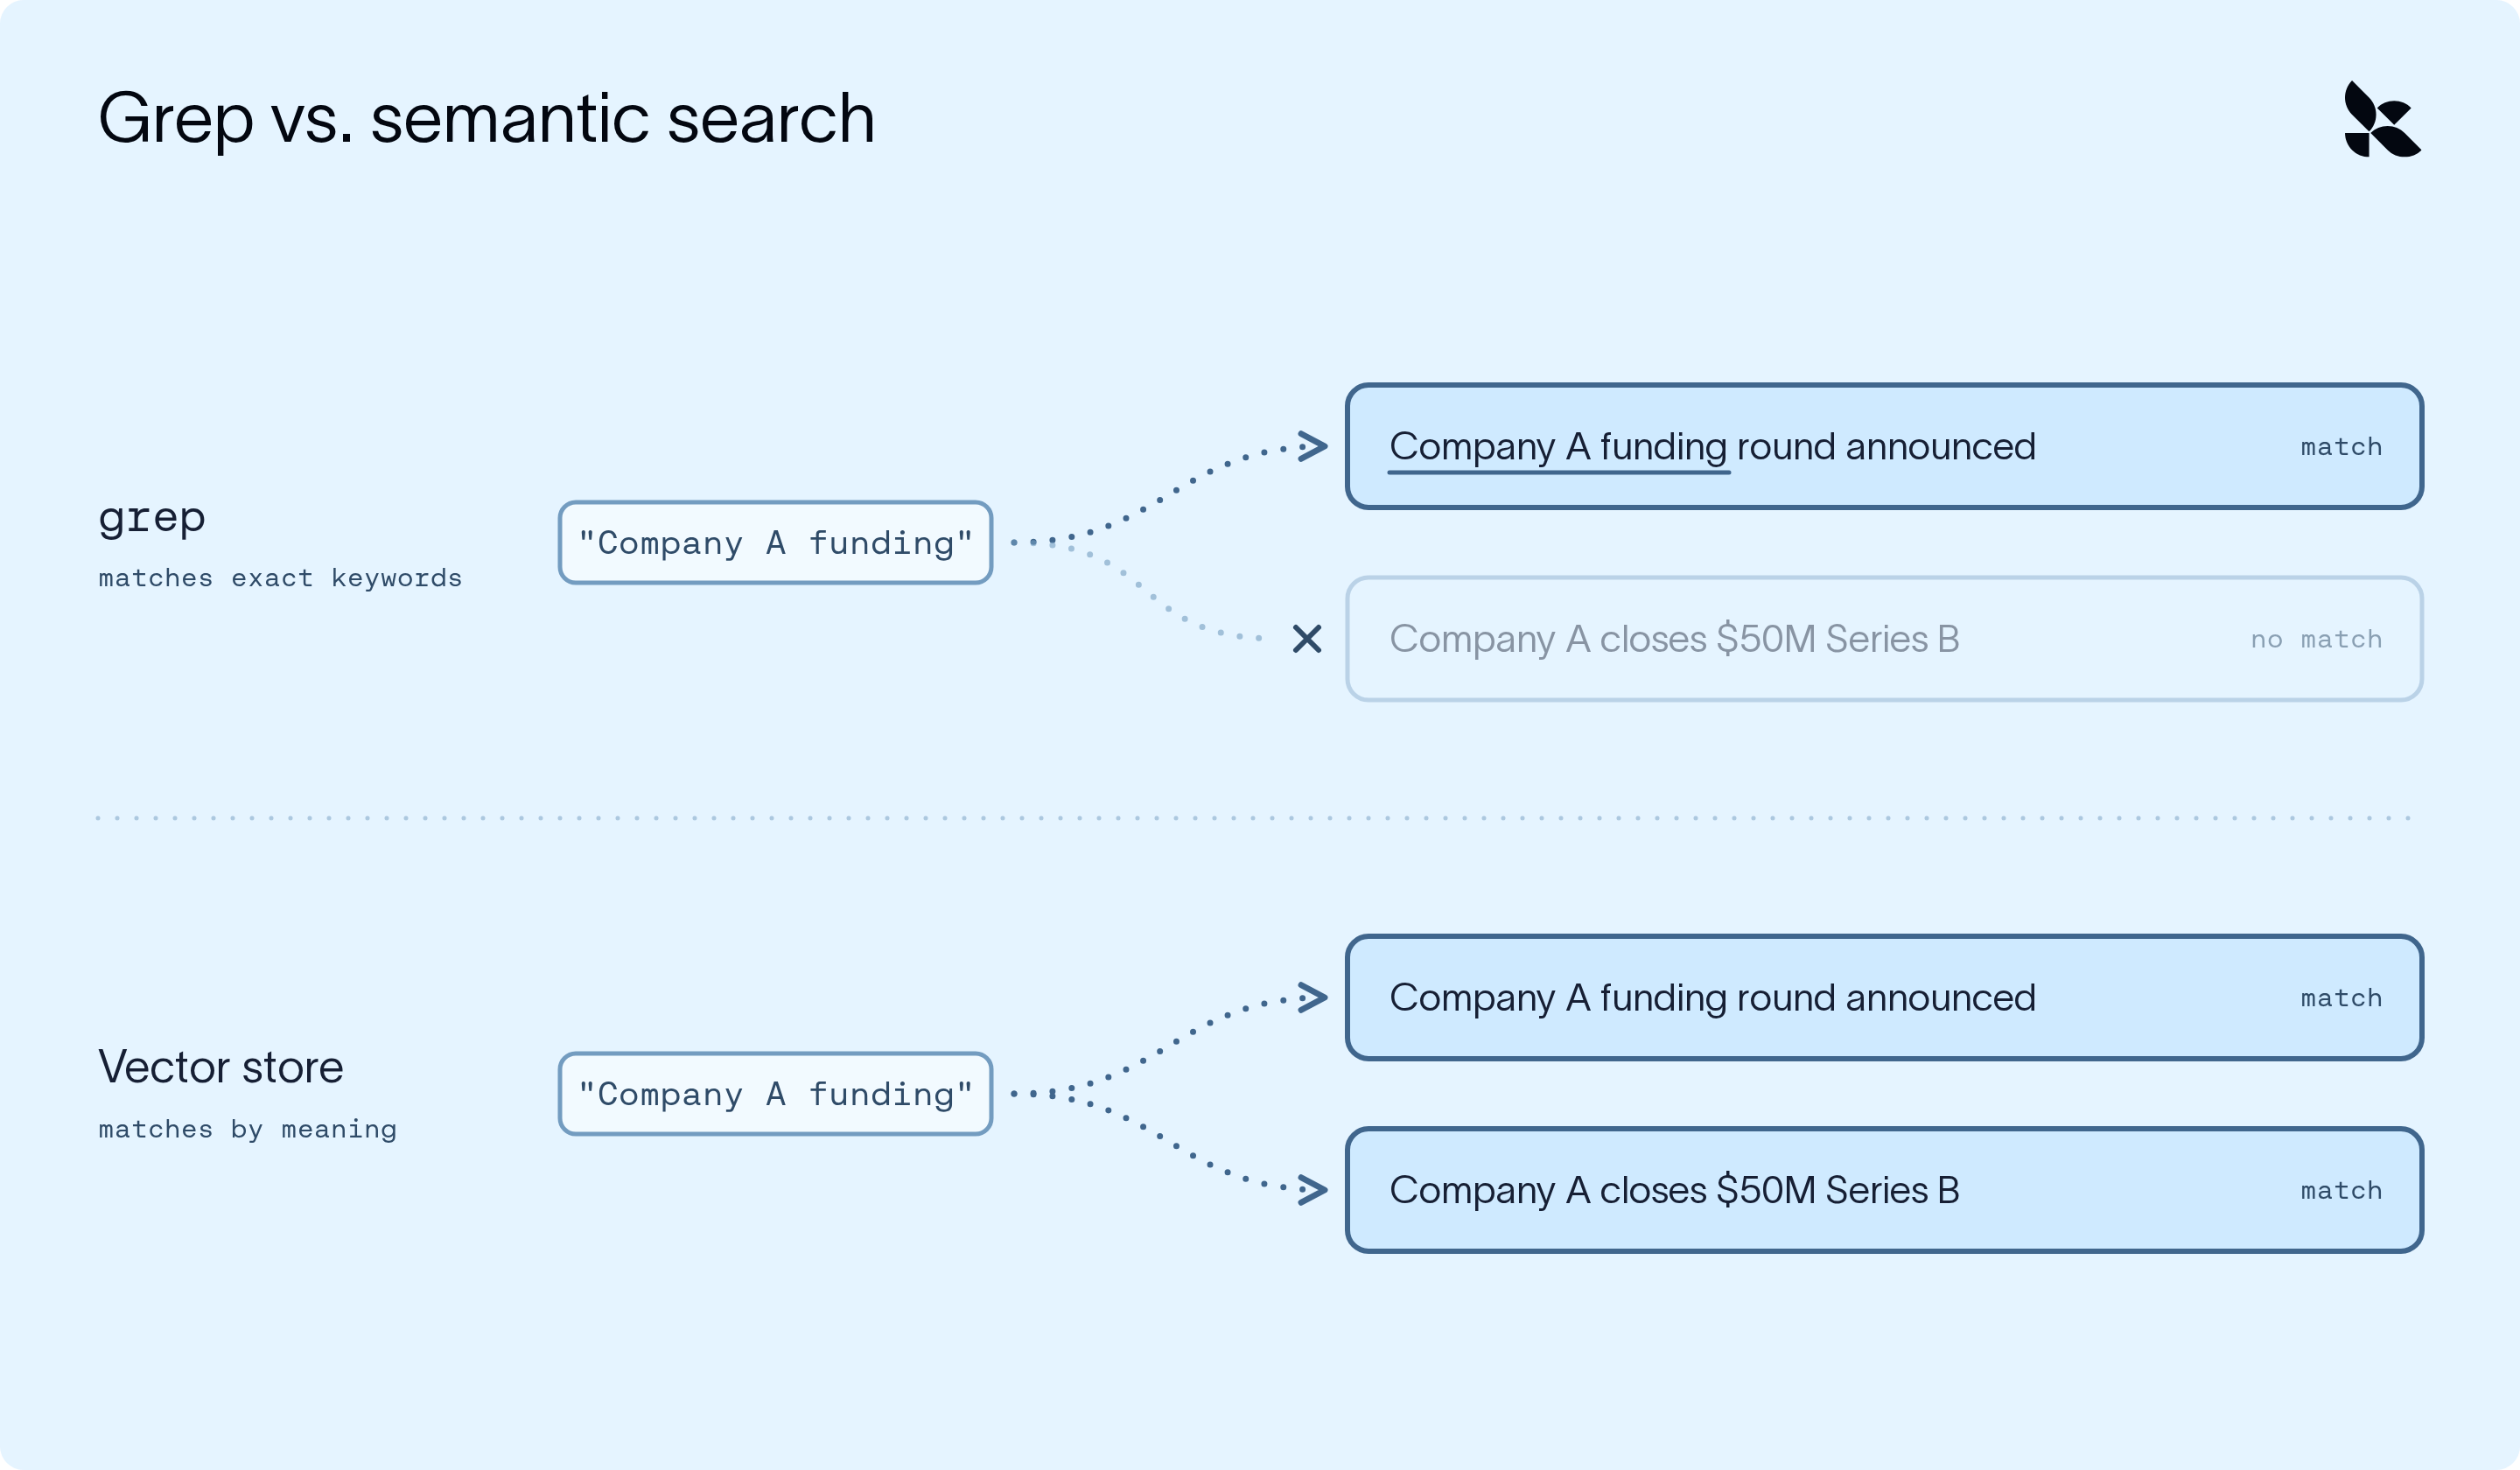
不过,在切换到 semantic search 之前,可以先尝试同义词。Grep 只匹配给定的确切词语,但选择这些词语的 Agent 本身已经知道 "funding" 也可能以 "Series B" 或 "raised" 的形式出现。告诉它在搜索未命中时尝试其他措辞,它就会对每个词各执行一次 grep。对于只有你们团队使用的词语(例如内部产品名称),可以把它们列在 skill 中。当措辞可以预测时,这种方法效果很好。当措辞无法预测时,你就需要 semantic search 了。
retrieval tool 如何进行匹配取决于其背后的数据源。以 vector store 为后端时,它按含义匹配,但 retrieval tool 也可以构建在其他数据源之上:
- 一个 SQL database,用于结构化查询(比如销售数据或客户记录)
- 一个 search API(用于获取网络上的最新信息)
- 一个 MCP server(用于使用他人已构建好的工具,比如文档搜索)
如需深入了解 semantic search 的工作原理,请参阅 LangChain 的指南。
让 agent 自行决定何时搜索
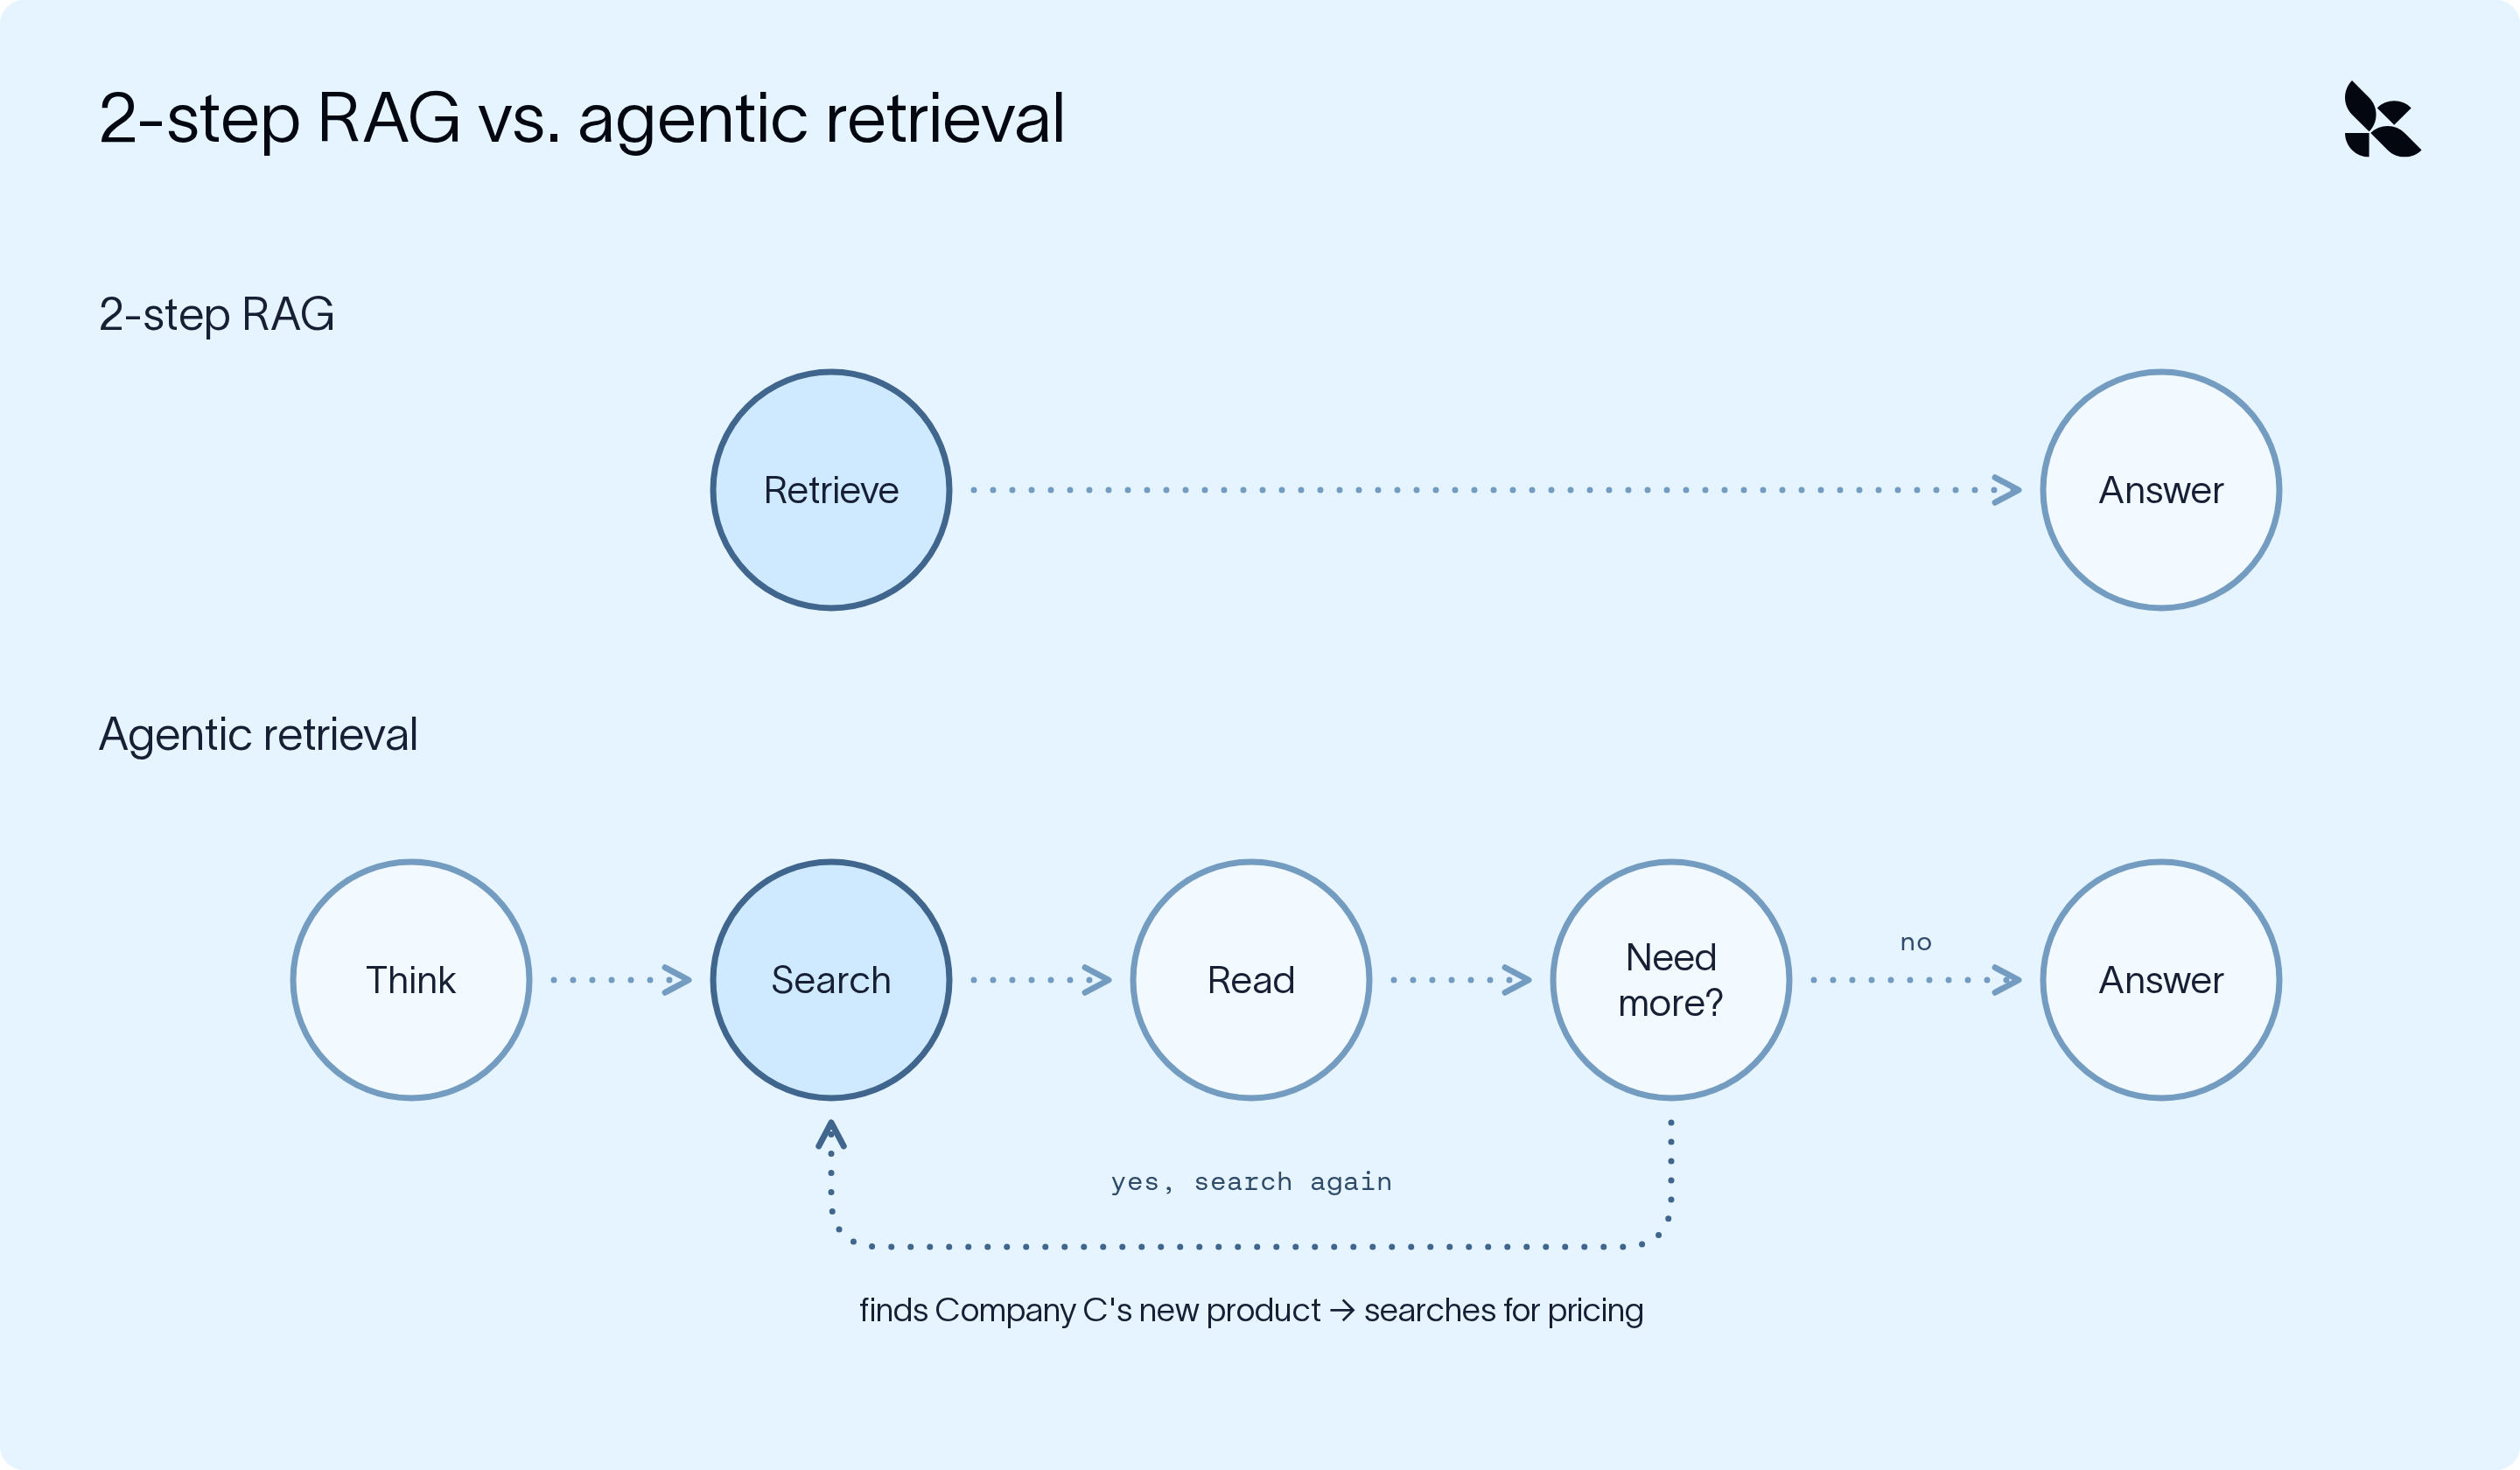
许多 retrieval 方案只在开始时搜索一次,然后直接作答。这对 FAQ 机器人(2-step RAG)有效,但对我们的 agent 却行不通。假设它在研究 Company C 的过程中,发现了一篇关于某个它此前不知道的产品发布的文章,现在它需要该产品的定价信息(而它在一开始根本不可能知道要查找这个)。如果只搜索一次,报告中就会缺失这部分内容。
研究 agent 需要 agentic retrieval(而不是 2-step RAG):由 agent 决定何时搜索、搜索什么,以及是否需要更多信息。使用 Deep Agents 时,默认就是这样工作的:agent 在循环中运行,并可根据需要任意多次调用任何工具。
将你的搜索经验封装为 skill
为了帮助 agent 更好地进行搜索,你可以把搜索经验封装为一个 skill:即针对特定任务的一组指令(比如使用哪个 index、如何组织查询语句、如何格式化引用)。
在任务需要之前,agent 只能看到每个 skill 的名称和简短描述;一旦任务需要,它就会加载完整的指令。这样,冷门的专业知识在需要时可用,而在其余时间不会占用 context(这种技术称为 progressive disclosure)。这里有一个视频讲解。
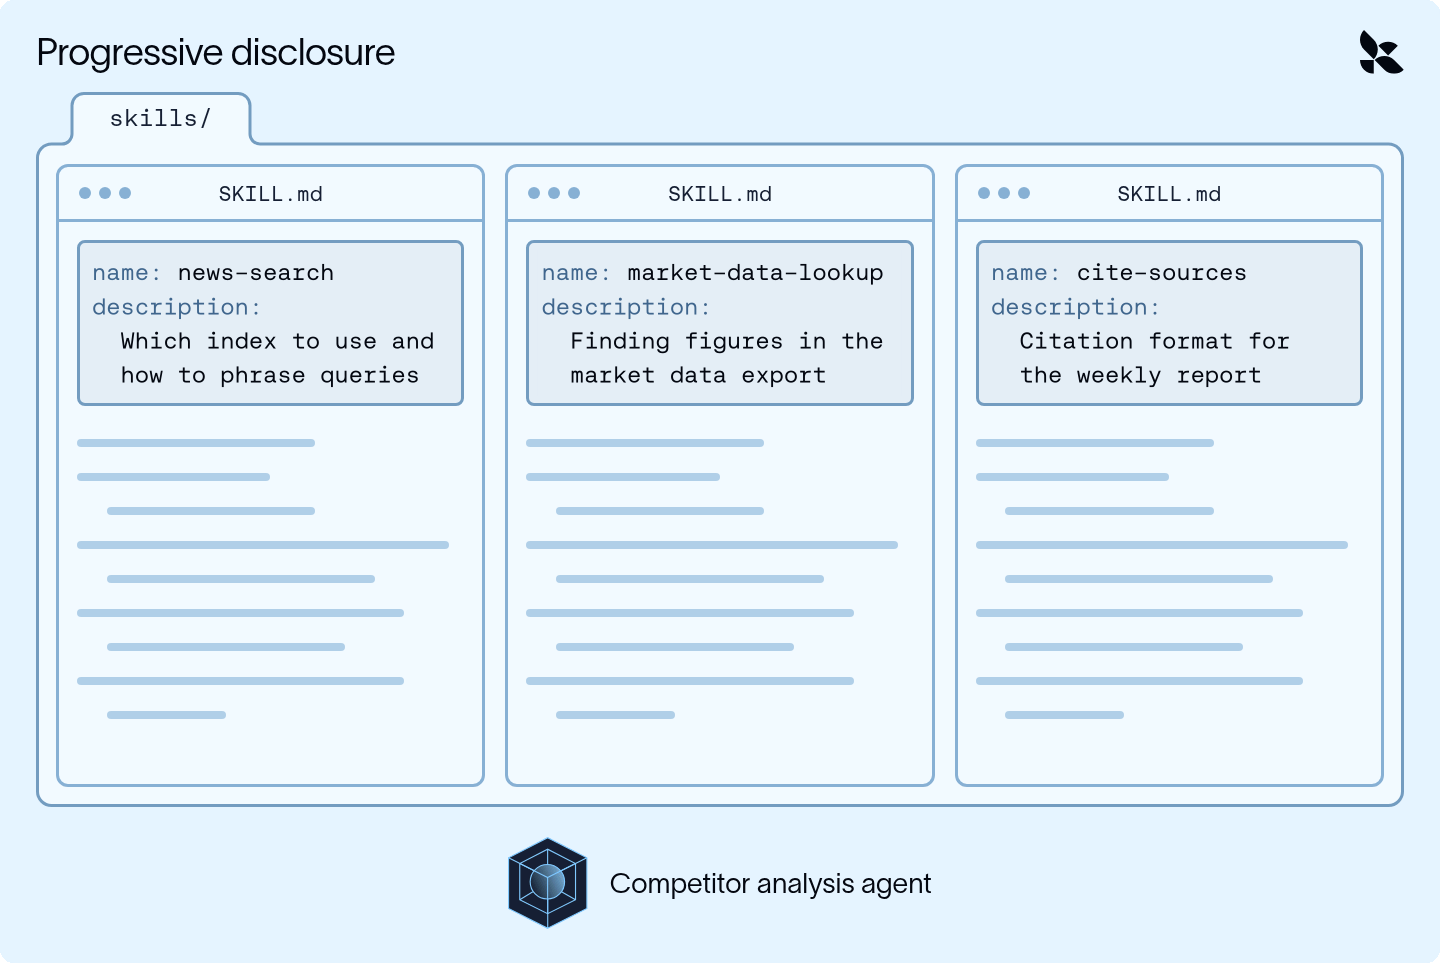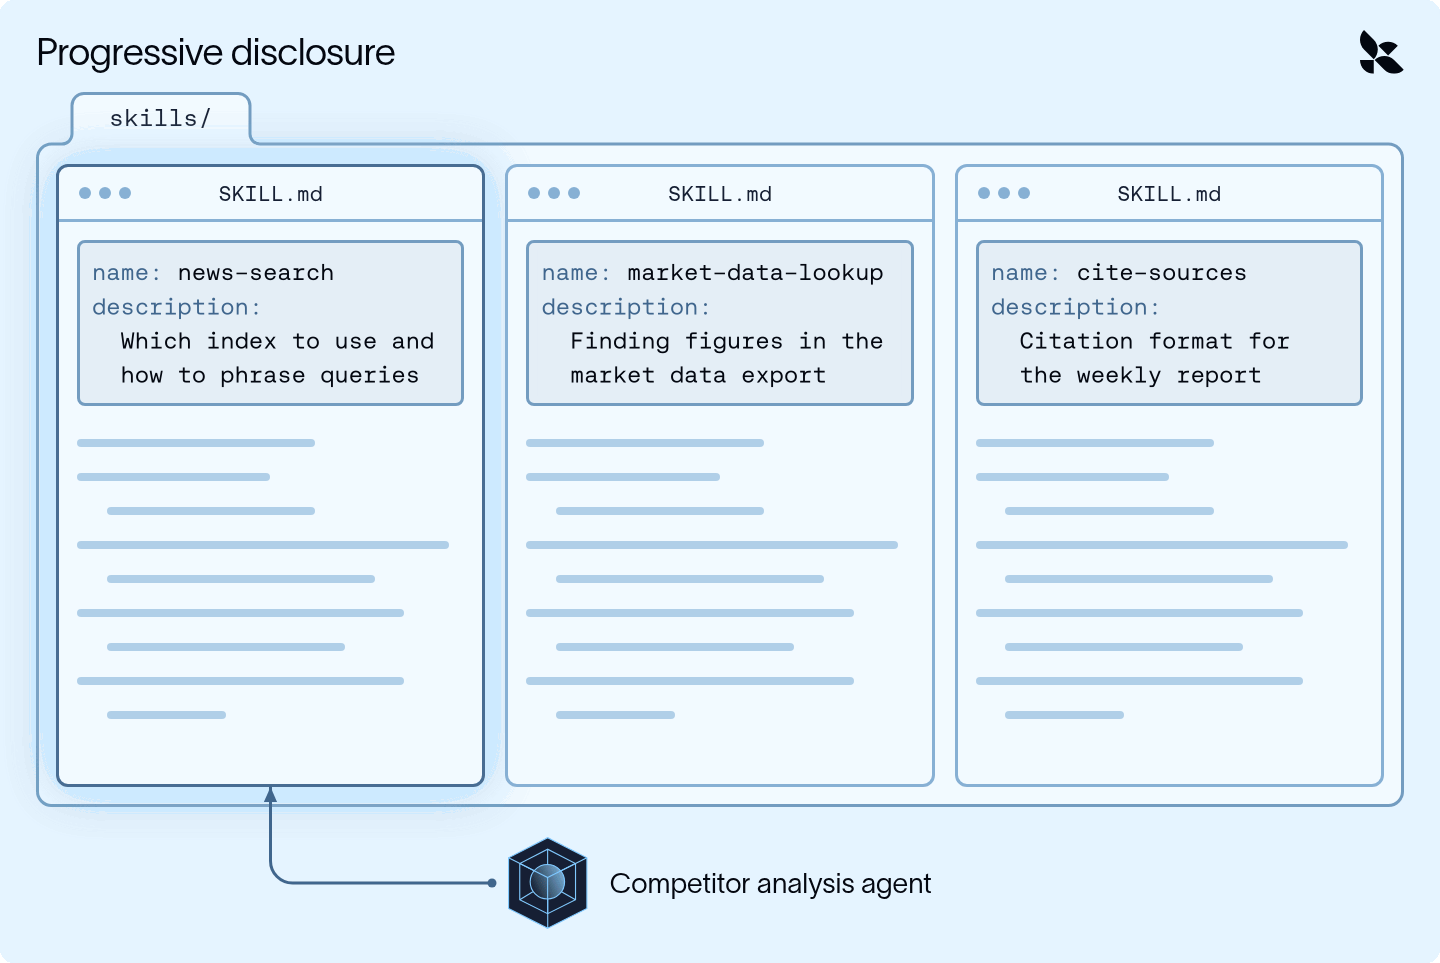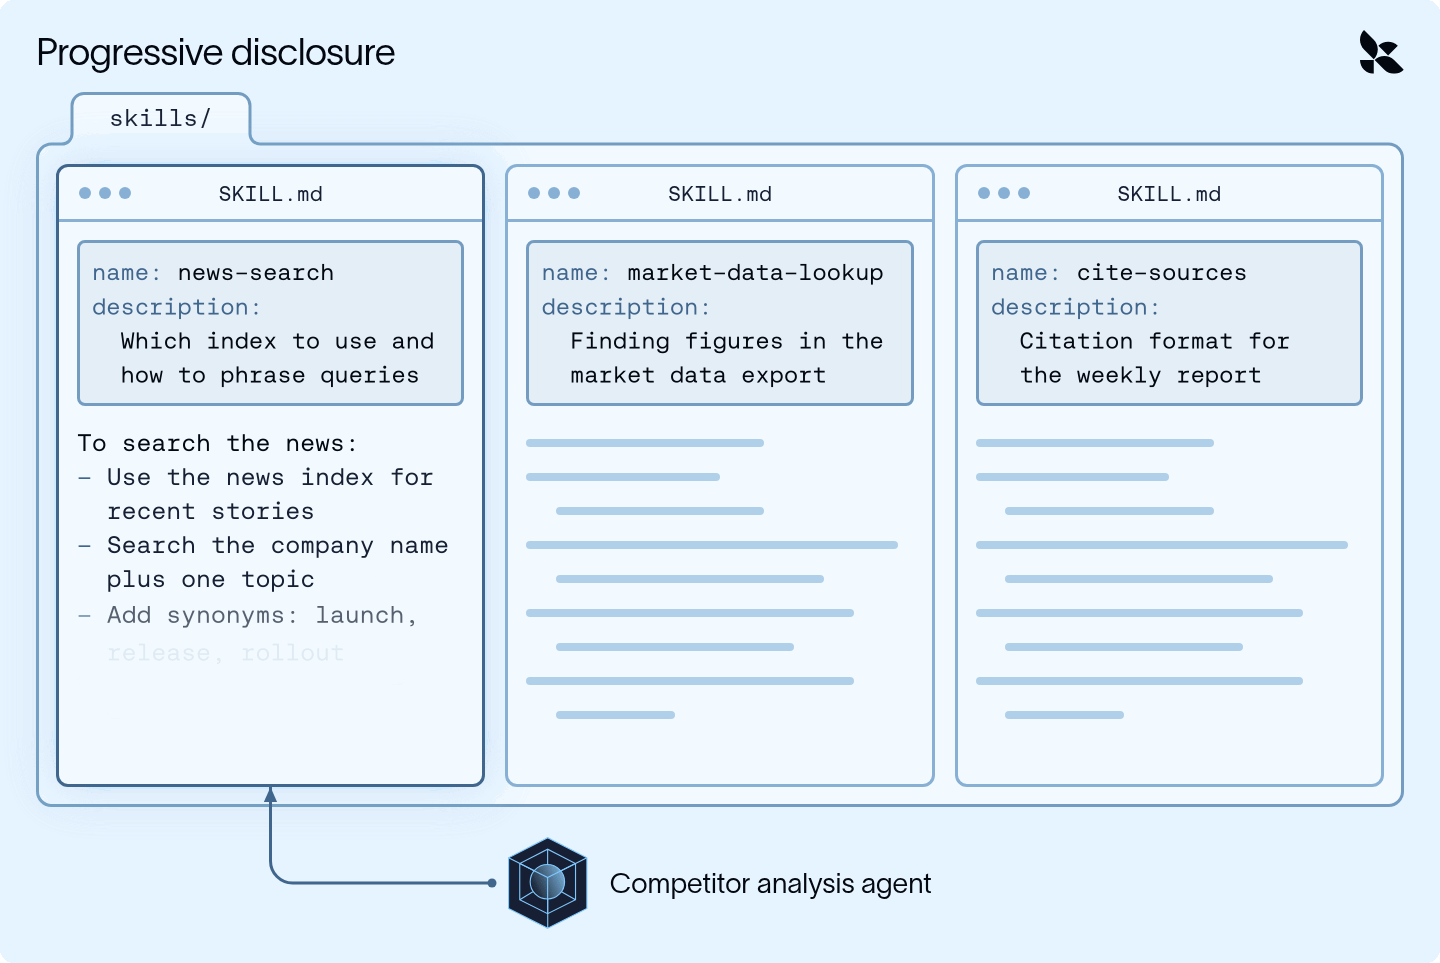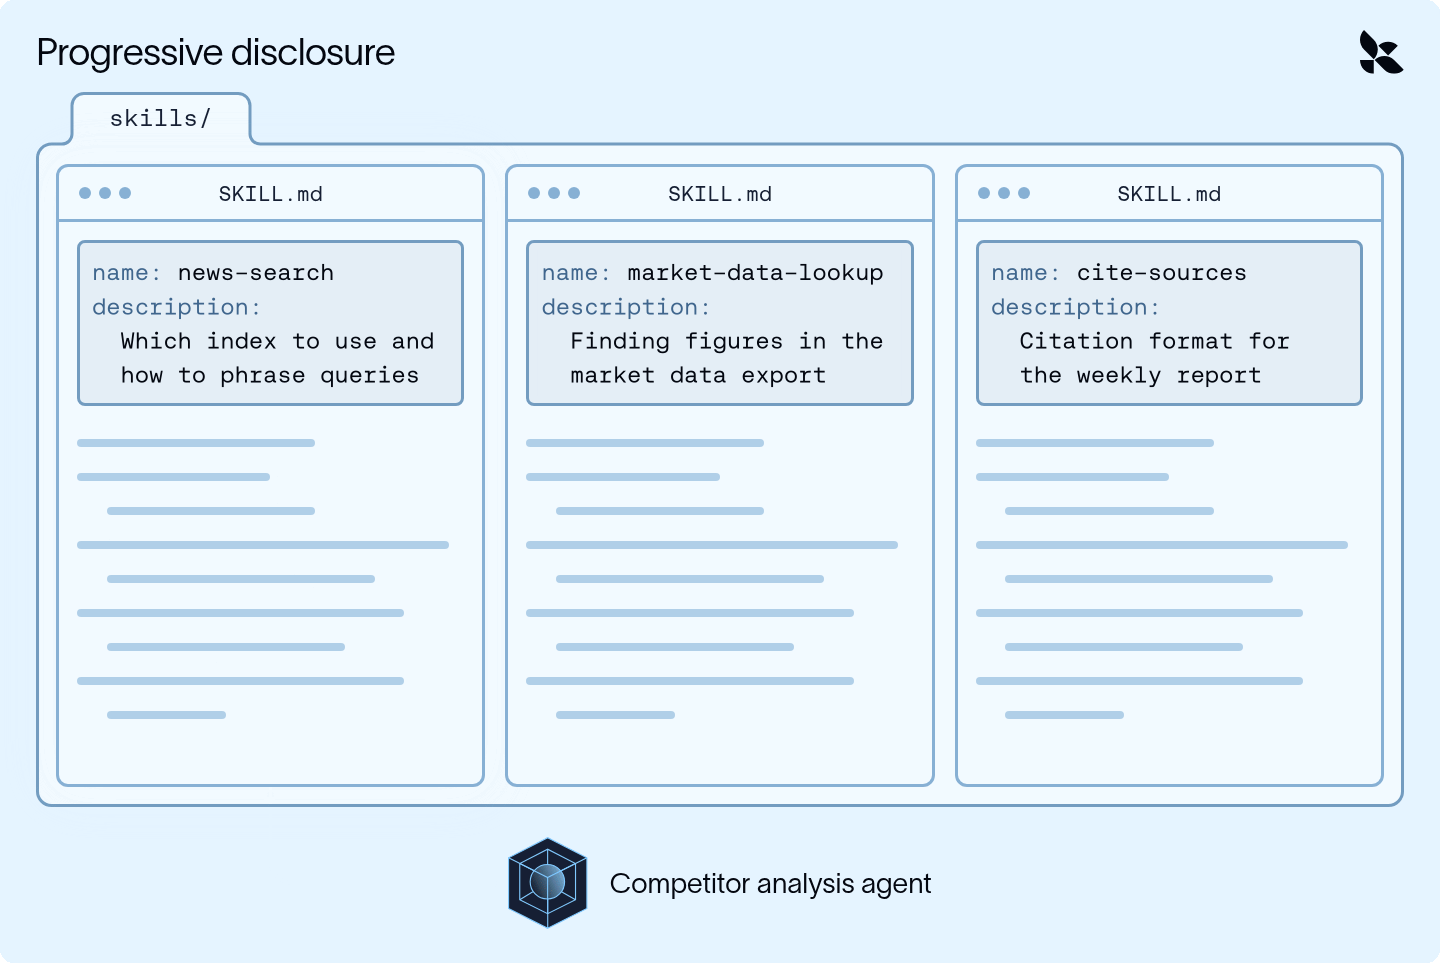
Progressive Disclosure(动画演示)
2. 一次加载过多 context
然而,即便优化了搜索流程,即使是正确的搜索也可能返回过多内容。我们的 agent 只需要市场数据导出文件中的一个数字(Company B 的季度营收),但如果为了找到它而加载全部 40,000 行数据,就会填满它的 context window。我们的 retrieval 工具也有同样的问题:如果每次搜索都把四篇新闻文章直接返回给 model,五家公司下来,数量会迅速累积。
分页读取大型文件
文件系统工具的设计目标是尽可能少地返回内容。read_file 每次读取文件的一页(默认 100 行),agent 可以设置 offset(从哪一行开始)和 limit(读取多少行)来跳转到所需的部分。因此,要查找 Company B 的营收,agent 会先用 grep 搜索,然后只读取匹配位置附近的几行。
让 harness 卸载过大的结果
有时工具返回的内容仍会超出预期。当工具结果过大(超过约 20,000 token)时,harness 会将其保存到 /large_tool_results/ 目录下的一个文件中,并向 agent 提供该文件路径以及一段简短预览(开头和结尾的几行)。然后,agent 可以借助 read_file 的 offset 和 limit 只读取所需的部分。
让你的 retrieval 工具返回文件路径
你可以把同样的思路应用到自己编写的 retrieval 工具上,而不必等到触发大小限制:让它把每个结果写入文件,并只返回路径。这是一种名为 "retrieve, offload, delegate"(检索、卸载、委托)模式的第一部分(LangChain 的 RAG 指南有完整讲解)。
下面是一个简化的检索工具。它执行搜索,把每个结果保存为 agent 的 backend 中的一个文件,并且只返回文件路径列表:
`backend = StateBackend()
@tool def search_news(query: str) -> str: """Search the news archive and save each result to a file.""" docs = vector_store.similarity_search(query, k=4) files = [(f"/retrieved/result_{i}.md", doc.page_content.encode()) for i, doc in enumerate(docs)] backend.upload_files(files) return "Saved results to: " + ", ".join(path for path, _ in files) `
现在主 agent 看到的是四个简短的路径,而不是四篇完整的文章。
3. 无关或过时的上下文
如果结果是错误的结果,再小也无济于事。这四个文件中的任何一个都可能是关于一家名称相似的其他公司,或者是两年前的报道。跑题或过时的文本对模型来说和正确答案一样有说服力,所以目标是把它们完全排除在主 agent 的上下文之外。
让 subagent 过滤结果
然而,主 agent 仍然必须读取这些文件才能知道哪些有用(而且它打开的每一篇跑题文章都会进入它的上下文)。这正是“检索、卸载、委派”模式中“委派”部分的用武之地:由一个 subagent 读取每个检索到的文件,并且只返回关键事实。
- 定义 subagent:description 告诉主 agent 何时使用它(每次调用处理一个文件),system prompt 告诉 subagent 对该文件做什么。
chunk_analyst = { "name": "chunk-analyst", "description": "Analyze one retrieved file. Pass the question and a single path under /retrieved/.", "system_prompt": "Use read_file to read the assigned file. Return the key facts and the source URL.", }
- 为主 agent 提供检索工具和 subagent。传入你在
search_news中使用的同一个 backend,这样 subagent 就能读取该工具保存的文件。
agent = create_deep_agent( model=model, tools=[search_news], backend=backend, # same instance, so read_file can see /retrieved/ subagents=[chunk_analyst], )
现在的流程是:
- 搜索:主 agent 调用
search_news,得到四个路径。 - 委派:它把每个路径发送给一个 chunk-analyst subagent,它们可以并行运行。
- 综合:每个分析器返回一份带有来源的简短摘要。主 agent 将它们整合起来,如果缺少什么就再次搜索。
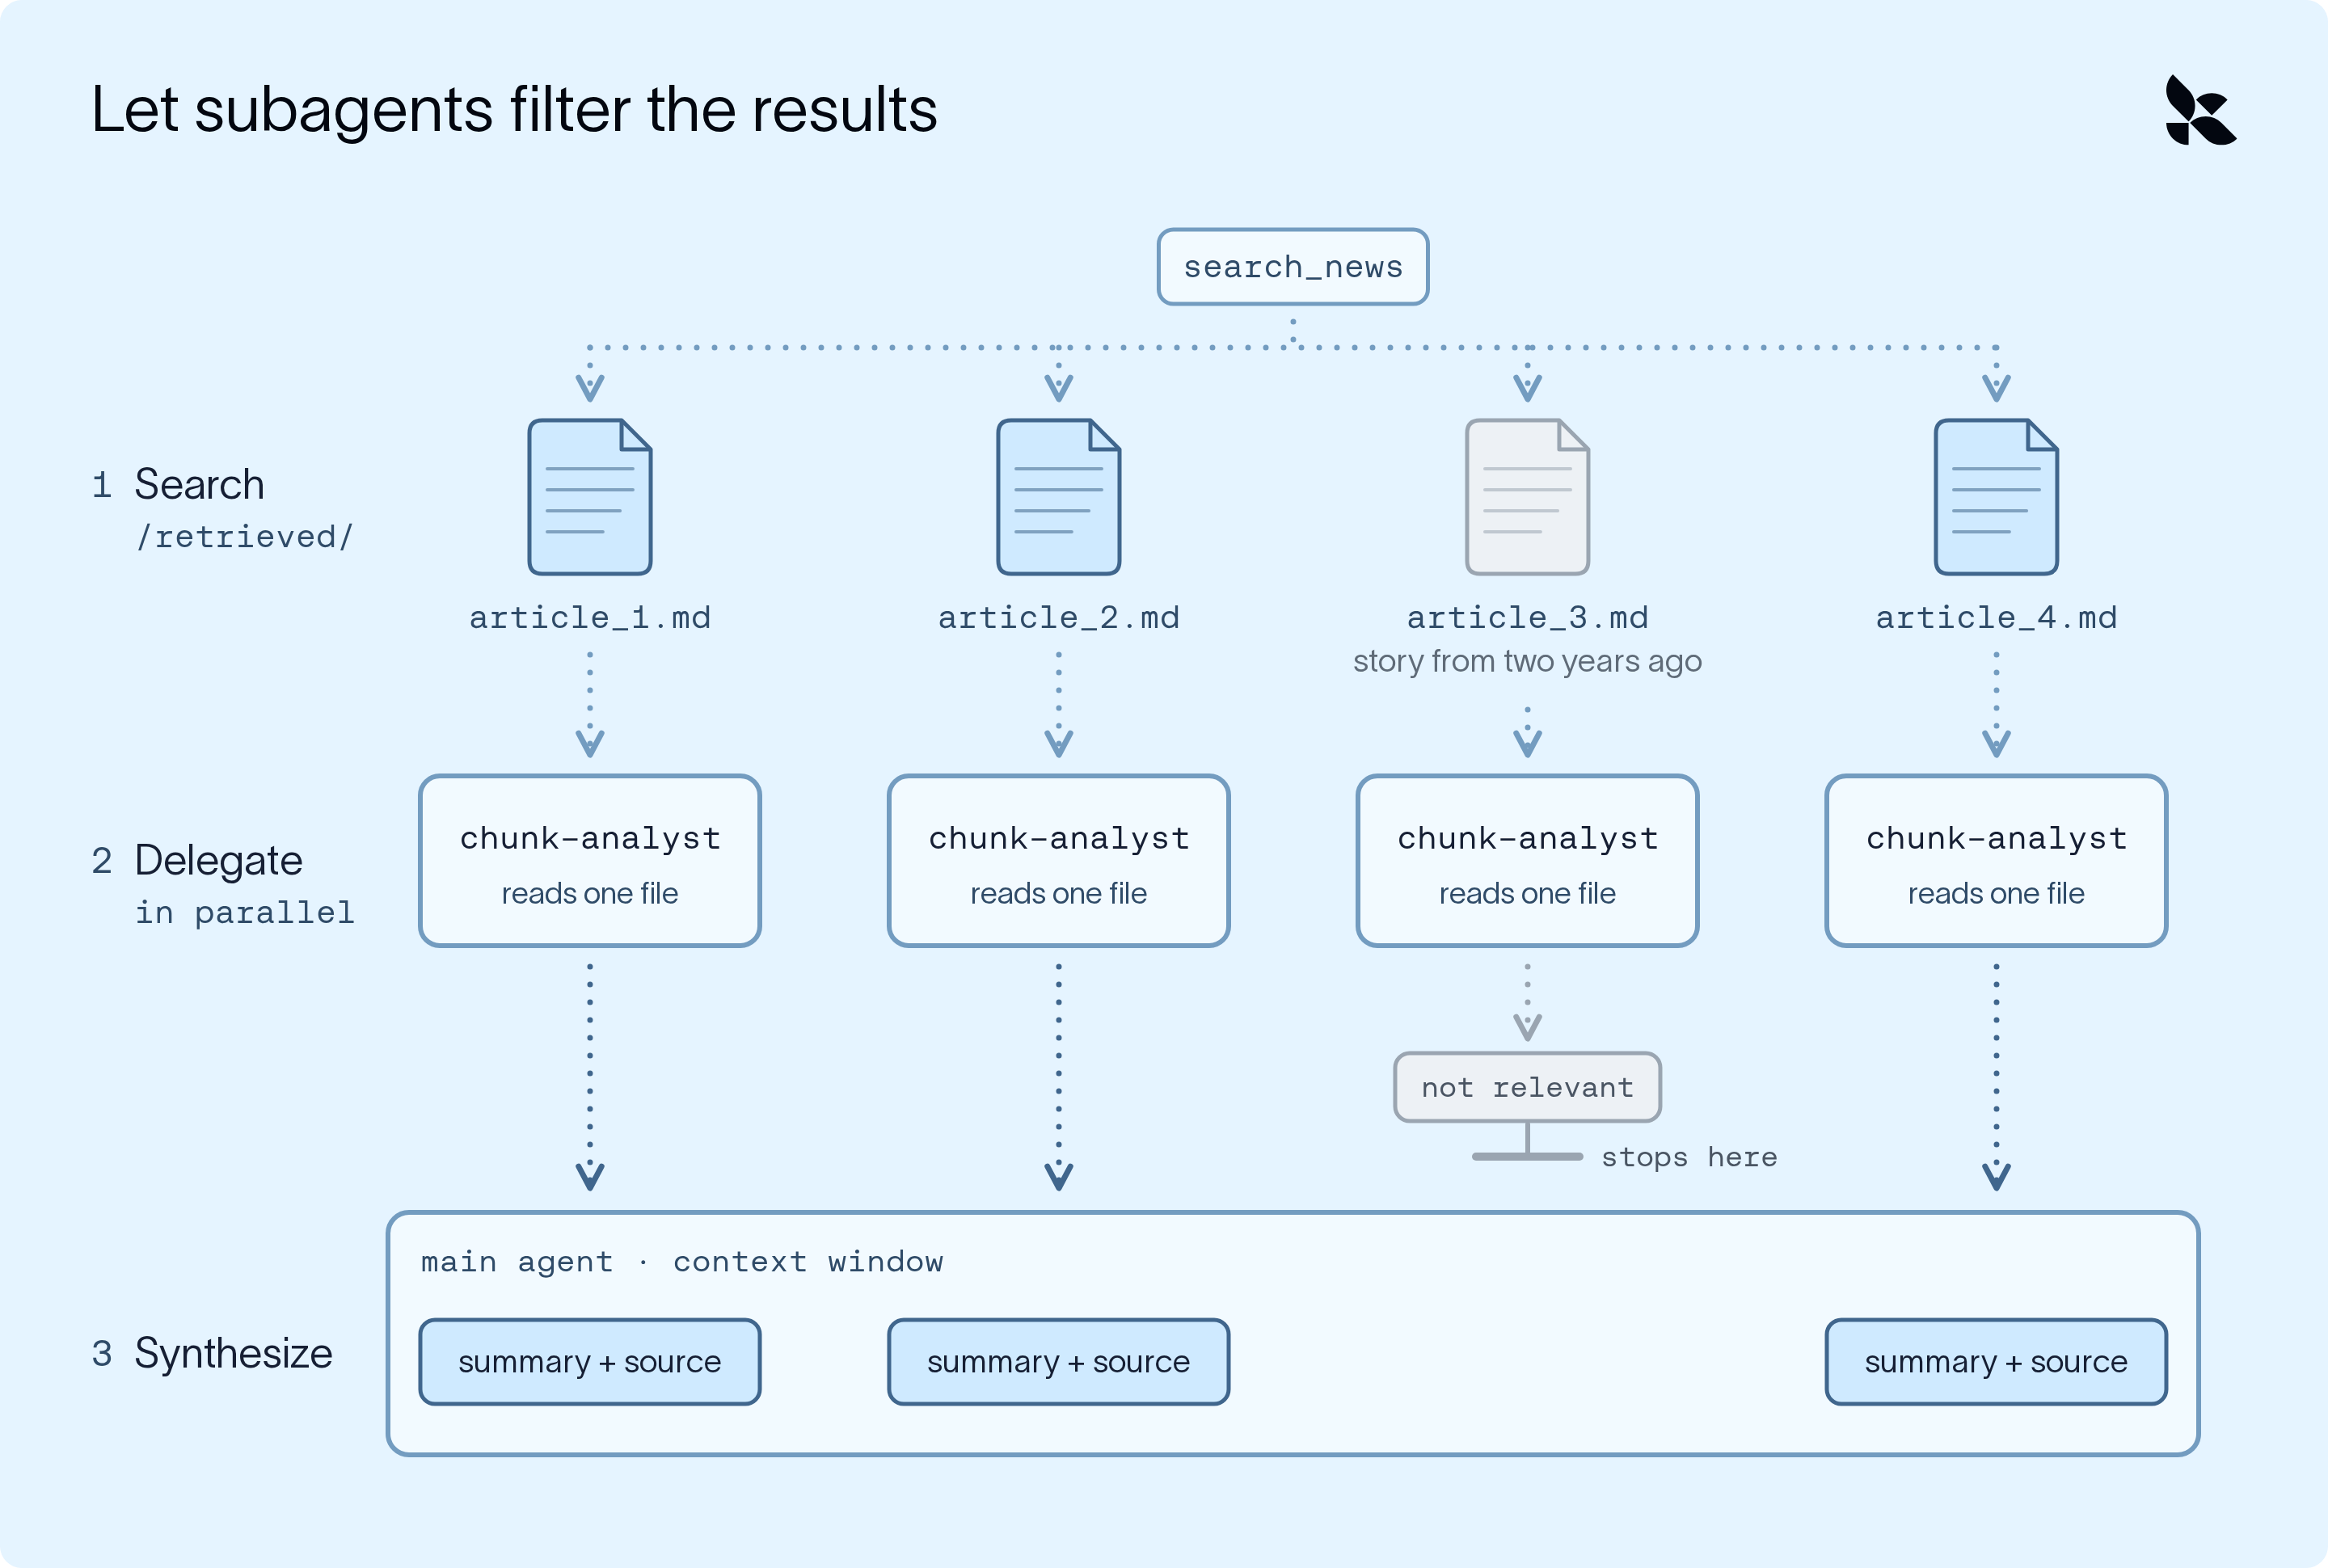
原始结果进入文件,嘈杂的读取工作发生在拥有各自上下文窗口的 subagent 中,而主 agent 只看到结论。任何跑题的内容都留在 subagent 的上下文里,主 agent 的上下文窗口保持清爽!
从最新的来源获取信息
过滤确实能把跑题的结果排除在外,但无法解决结果过时的问题。我们的竞争分析 agent 每周一运行,所以上个月的索引捕捉不到本周的新闻。
一个解决方案:使用搜索 API 或 MCP server 为 agent 提供最新信息(而不是几个月前索引的内容)。如果你的数据带有日期,在检索工具中按日期过滤也能把旧结果排除在外。
有时索引中同时存在文档的旧版和新版,而旧版通常会胜出(旧文档往往更长、更详细,因此排名通常更高)。人类会注意到“最后更新于公元前 12 年”然后跳过它,但在为 vector store 拆分文档时,这个日期通常会丢失。如果你的检索工具能拿到日期,就把它包含在返回的文本中,让模型能够看到。然后让 subagent 在返回关键事实的同时也返回日期,并标记任何看起来过时的内容。
谨慎处理检索到的文本
反过来说,相关且最新的检索结果也可能带来问题!由于检索到的文本是数据而非指令,你检索到的任何内容都可能包含 prompt injection(而且没有任何 prompt 或分隔符策略能完全杜绝这一点)。务必对输出进行验证:检查答案是否引用了你预期的来源,论断是否与来源一致。
需要牢记的检索策略
无论你基于什么 harness 进行构建,以下几点都值得注意:
- 使用能奏效的最高效工具。 如果你知道关键词,grep 比 embedding 查找更高效。把语义搜索留到真正需要的时候再用。
- 分页读取,而非一次性加载。分段读取大文件,而不是一次全部读入。
- 返回指针而非数据本身。把检索到的内容写入文件,并将文件路径交给 Agent。
- 委派阅读任务。让 subagent 负责阅读和总结,主 Agent 只看结论。
- 验证答案有据可依。将答案与检索到的内容进行核对,并把检索到的文本视为不可信内容。
试用一下
uv add deepagents
我在一场 workshop 中讲解过这些内容,见 这里!
检索只是故事的一半:信息如何到达 Agent。当 Agent 随时间推移不断积累信息时,我们该如何管理它的 context window?
想了解更多,请查看:
- 关于 Deep Agents 的 context engineering 的博客
- LangChain Academy 上的 Deep Agents 课程(免费、在线、可自主安排进度)。
相关内容
 Deep Agents概念指南
为什么人类洞见是构建更优 Agent 的战略优势
 Gowri HarishSineha Manivannan2026年11月3日
 8分钟https://www.langchain.com/blog/human-insight-strategic-advantage-agents
 Deep AgentsAgent 架构
我们如何为 Deep Agents 优化浏览器使用
 Sydney Runkle2026年11月3日10分钟https://www.langchain.com/blog/how-we-optimized-browser-use-for-deep-agents
 Deep AgentsAgent 架构部署
托管式 Deep Agents 中的浏览器使用
Sydney Runkle2026年10月29日7分钟https://www.langchain.com/blog/browser-use-in-managed-deep-agents 谢谢!您的提交已被接收!哎呀!提交表单时出了点问题。
看看你的 Agent 到底在做什么
LangSmith 是我们的 Agent 工程平台,帮助开发者调试每一个 Agent 决策、对变更进行 eval,并支持一键部署。 试用 LangSmith预约演示