a16z:模型越便宜,AI 应用越难收高价,怎么办?
原文链接: https://www.a16z.news/p/how-ai-applications-earn-their-premium 来源: www.a16z.news 发现于: 小互 · AI 解读站 · 2026/11/3 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
AI 应用如何赢得溢价
更廉价的智能抬高了 AI 应用的定价门槛
https://substack.com/@tertenTugce Erten2026年11月2日

更低的推理成本可以改善应用公司的利润率,但更强大的模型和更易用的开发工具也可能让应用的某些部分更容易被替代。商业上的关键问题是:随着替代方案的不断改进,客户还会继续为什么付费?
这种风险敞口因产品而异。当客户只需用一个通用模型加上很少的持续投入,就能复现一个应用的核心输出时,这个应用就是脆弱的。这正是当下 AI 应用公司面临的核心之问。定价一直都很重要,但现在格外重要,然而它有时会被忽视或推迟,因为快速增长的 AI 公司不愿正面应对这个问题。
所有 AI 应用公司都需要花时间严格地打造这些显而易见却必不可少的能力,并为它们定价:**领域专长、深度集成、可靠的执行,以及难以获取的上下文。这些都是能让购买变得更具吸引力的定价杠杆。**创始人需要弄清客户真正看重哪些优势,然后强化这些优势并为它们定价。
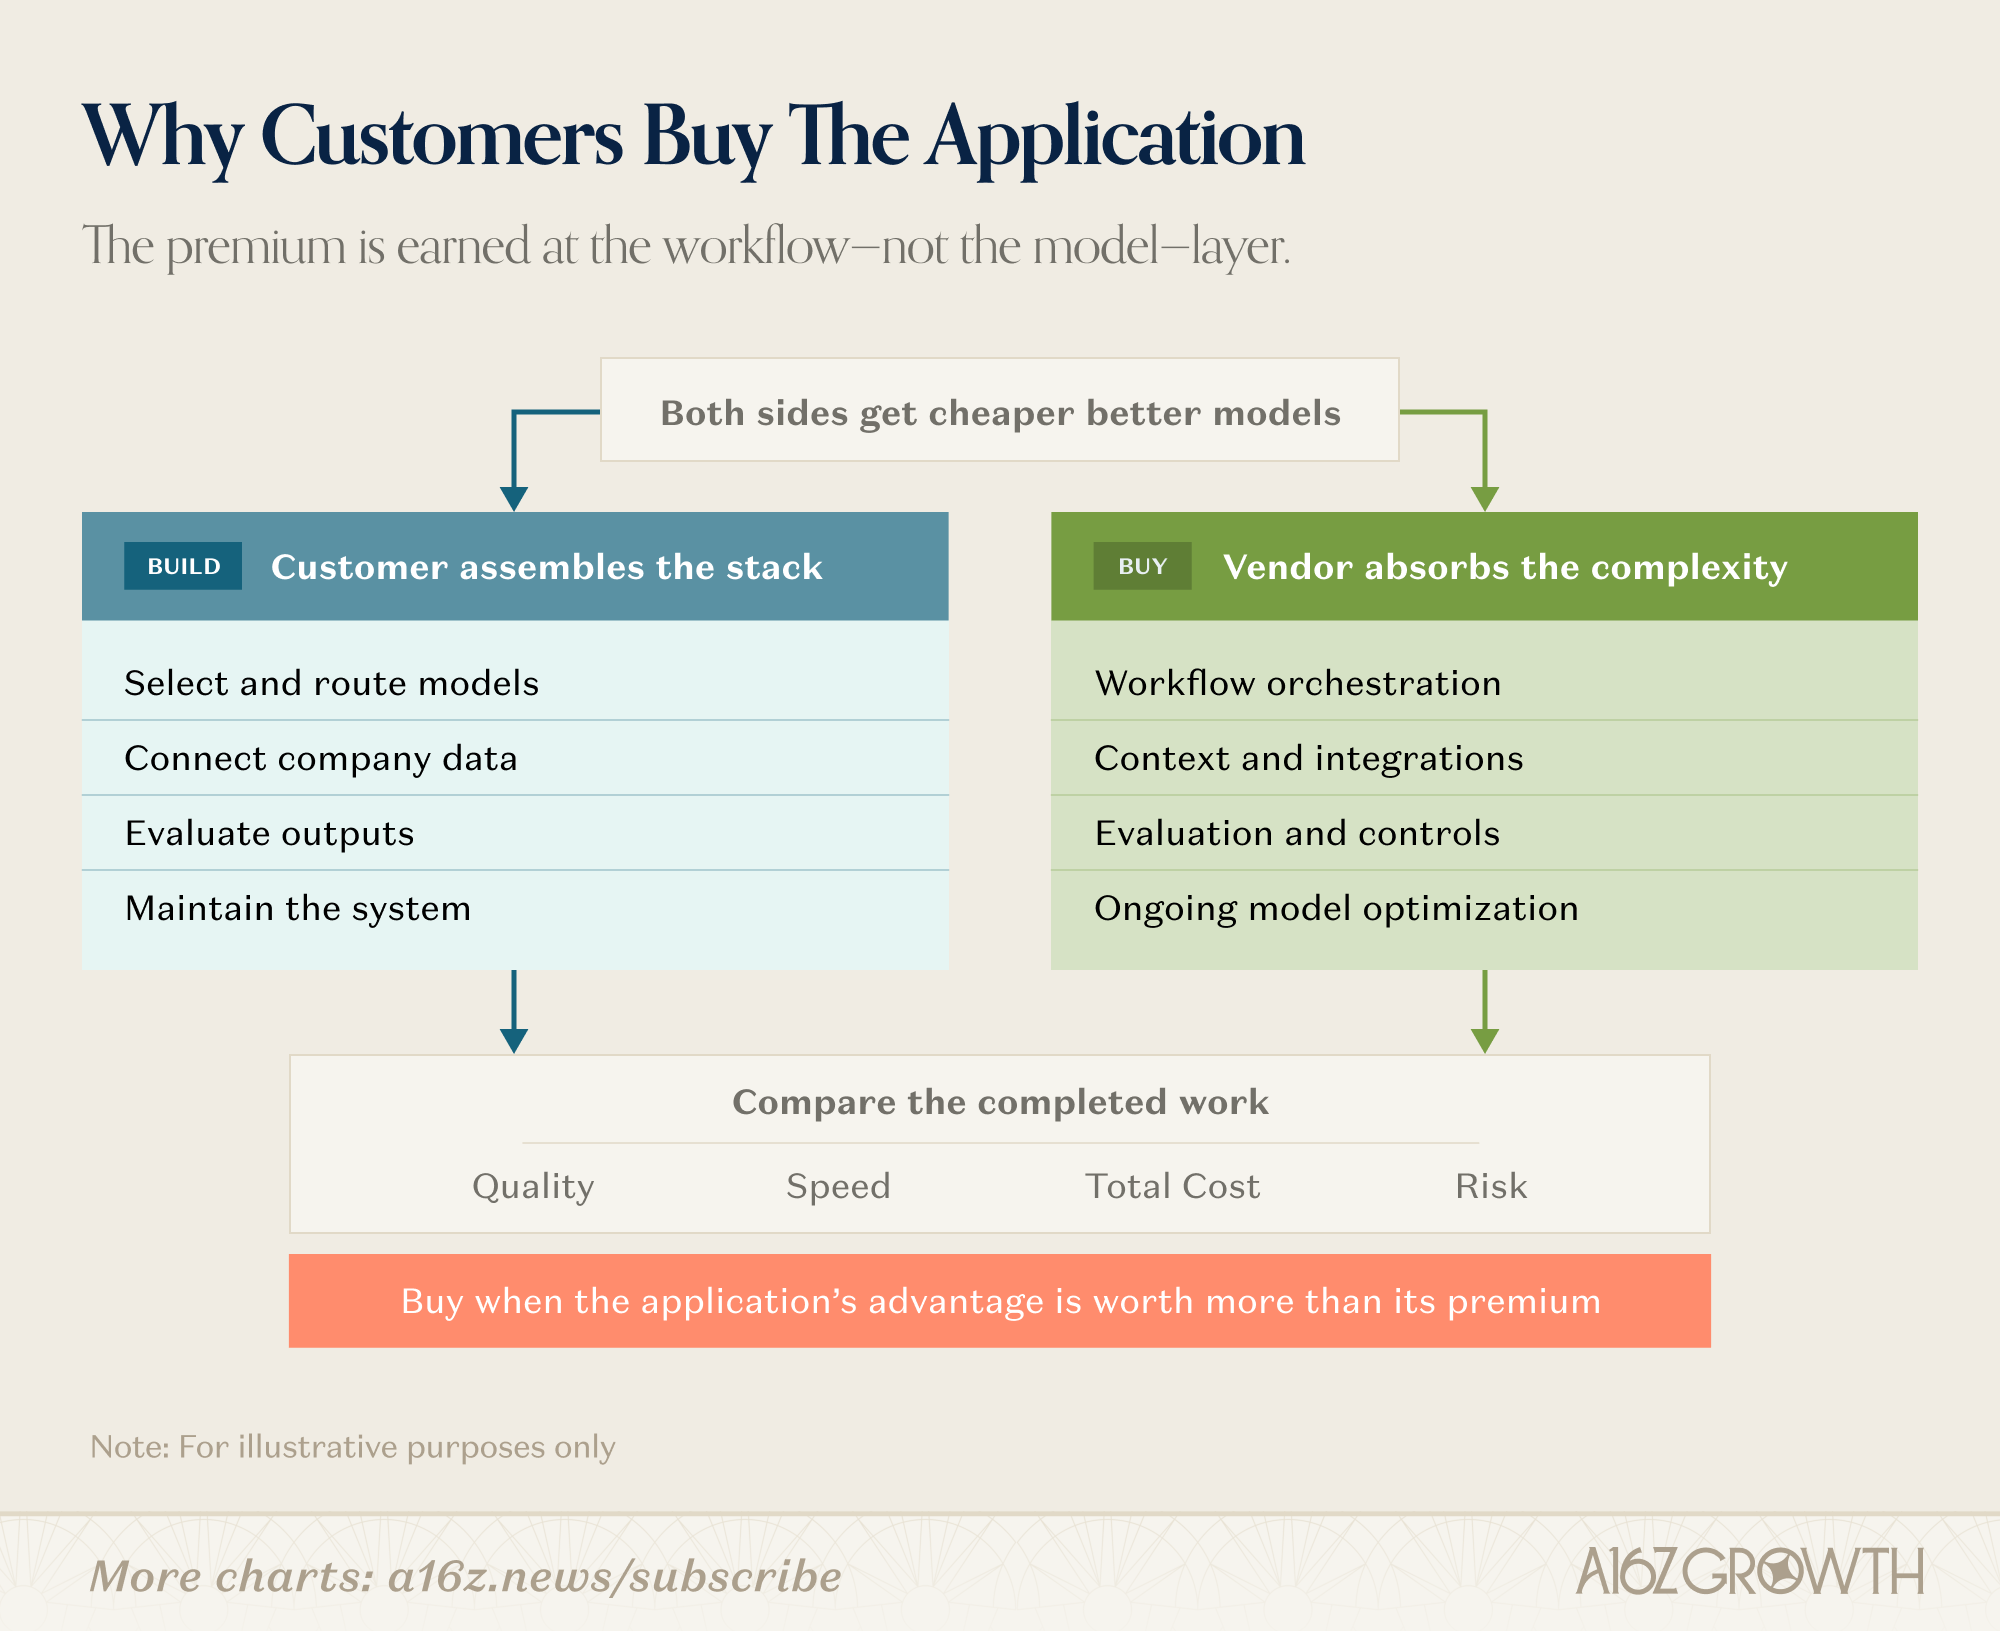
由此形成的自建还是购买(build-versus-buy)测试如下:
Repsol 的法务团队把自建还是购买的问题摆上台面做了直接检验。在一项盲测评估中,他们将 Harvey 与 Microsoft Copilot 以及自研的内部 AI 原型 Lexia 进行了比较。Harvey 的输出质量最高,随后在一场涉及 12 个司法辖区、50 名律师、为期八周的试点中,它在准确性和节省时间上都优于其他方案。Repsol 随后进行了全面部署。Harvey 方面表示,律师们现在每周可节省四到六个小时,整个法务部门的使用率达到了 96%。其收益还延伸到了未来的工作:团队利用 Harvey 识别过往协议中反复出现的异议,并用后备条款改进了合同模板。这个案例说明了一个应用如何通过比可信替代方案更好的执行、可量化的节省,以及把积累的知识转化为可复用指导的能力,来赢得自己的溢价。1
从这一案例和其他例子中,我们总结出持续成功的三条法则:
- 把工作流运营得比客户自己做得更好
- 让租用上下文比重建上下文更便宜
- 先证明价值,再通过定价捕获价值
1. 把工作流运营得比客户自己做得更好。
客户不需要重建你的整个应用,就能削弱你的定价能力。只要把一项高频任务转为内部处理,或者建立一个可信的替代方案,就足以对你的溢价构成挑战。
一家全球性专业服务公司的一位买家告诉我们,如果直接向一个前沿模型发出 prompt 所产出的工作成果,比供应商的生产力工具更好,公司就没有什么理由支付平台溢价。对于敏感项目,该公司建立了一个内部 AI 平台,在客户不允许使用第三方产品时,可以在本地或企业自有设施(on premises)中运行模型。他们还在试验开源代码以及商业应用的替代方案。
要守住溢价,供应商必须在完整工作流中全面超越客户可用的替代方案。在合同审查场景中,这意味着执行公司的法律标准、保持文档内编辑的一致性,并在谈判推进过程中保留上下文。这些要求有助于解释为什么即便客户能够使用强大的模型,专业化应用仍能保持价值。
Harvey 的 Playbook Review 展示了所需具备的执行能力。一个主导 Agent 将审查任务分配给多个专业化 Agent,协调相互冲突的编辑,并检查最终完成的文档。Harvey 依据法律评分标准评估表现,并根据每个任务在质量、速度和成本上的表现选择模型。该系统还会保留审查上下文,使后续请求能够在此前工作的基础上继续。Harvey 还描述了一个更进一步的机会:从律师接受、修改或拒绝的 redline 修订中学习,使未来的审查需要更少的指引。
每一次完成的工作流还能强化评估、验证上下文,并深化针对客户的知识积累。当这种学习能改善下一次的结果时,应用的优势就会随使用而复利式增长。创始人应当衡量累积学习在质量、可靠性和交付成本上带来的收益。
这对创始人意味着什么: 将你暴露程度最高的工作流与客户可信赖的最佳替代方案进行基准对比。把实施、人工审查、失败处理和维护都纳入考量。找出会随每次使用而不断变好的环节。
2. 让租用上下文比重建上下文更便宜。
上下文可以通过独占访问、有价值的预处理,或两者兼有来支撑溢价。客户无法从他处获得的私密观察本身就有价值。对于客户可以自行获取的信息,优势则取决于将其变得准确、及时、可用的成本。
我们交谈过的一家垂直软件公司积累了覆盖约 3,000 家公司的多年专有定价基准数据,并正在探索通过 Model Context Protocol (MCP) server 提供访问,让 AI 系统能够直接查询这些数据。其中的经济逻辑很直白:供应商只需一次性地收集、整理、验证并维护这些信息,然后将成本分摊到众多客户身上。每位客户租用可靠、及时的上下文,其成本低于独自重建和维护同等资源所需的费用。供应商通过消除重复劳动赚取利润;客户则以更低的总成本获得更好的答案。
同样的逻辑也适用于客户自有信息。政策文件、CRM 记录、合同和工作流历史可能本就属于买方,但要使其能够可靠使用,需要进行权限管理、标准化、检索和持续验证。应用可以靠做好这些工作、并利用反馈持续改进上下文,来挣得自己的费用。
这对创始人意味着什么: 弄清客户究竟为访问付费、为预处理付费,还是两者兼有。在同等质量水平下,将你的价格与你为客户省去的工程、验证和维护工作量进行对比。
3. 先证明价值,再定价捕获价值。
更好的执行和可信的上下文创造了溢价的潜力。在我们 2026 年 8 月对 100 位企业 LLM 决策者的调查中,94% 预计 LLM 总支出将会增长,37% 预计其在未来一年至少翻倍。
随着支出增长,客户需要看到这些支出带来了什么:完成了多少工作、质量如何,以及相对于替代方案的总成本是多少。这种证明为确定应用能够就什么收取费用提供了依据。
从客户能够识别的单位入手:一份完成审查的合同、一次解决的客服对话、一项完成的研究任务,或一条完成信息补全的记录。衡量其完整的交付成本,包括检索、模型调用、工具使用、重试、评估和人工审查。在计算每个成功完成单位的成本时,应将失败的尝试计入其中。
接下来展示这项工作的价值。将应用的定价、实施、持续监督以及剩余的人工工作,与它所替代流程的成本和质量进行比较。在内部自建是可信替代方案的情况下,也应将内部自建的开发和维护成本纳入比较。
Decagon 的 Notion 案例研究将这一比较与购买决策联系起来。Notion 曾考虑内部自建,但最终选择了外部方案,以便其团队能专注于核心平台。在评估了质量、集成、安全性和合作伙伴关系后,Notion 选择了 Decagon。已发布的案例报告称,工单解决时间最多改善了 34%。这既为买家提供了选择该应用的理由,也提供了衡量该应用所改进工作的标尺。
一旦你能够展示已完成工作的价值,就应选择一种让你能获取部分该价值的定价模式。你可以基于节省的时间、交付的质量以及客户可用的替代方案来定价,同时确保交付有利可图。
正如 Sarah Wang 和我在《你不是模型。不要按 token 定价》中所论证的,应用应在其能够可靠衡量、归因并捍卫的最高价值层级进行定价。可识别的工作——一份研究简报、一次合同审查或一次支持交互——可以直接定价,也可以通过 credits 打包定价。Credits 是一种货币,而非价值度量指标;它们应映射到客户可以据此进行规划的任务或直观的工作量层级。
可预测性还必须经受住真实工作负载经济性的考验。Clay 的定价备忘录描述了固定的 AI 定价如何对简单工作负载收费过高,同时又使复杂工作负载无利可图。Clay 的应对措施是将 Data Credits 与用于编排的 Actions 分开,对边界更明确的 AI 工作负载保留固定的 credit 定价,而对波动性更大的 reasoning 模型则按实际 token 成本转嫁、不加成。这为客户提供了一种为编排付费的方式,同时将波动的模型输入单独处理。
随着交付成本的下降,这种分离也很重要。当定价与可识别的工作挂钩时,供应商可以通过 routing、caching 或更好的模型来提高利润率、降低价格或包含更多工作。客户可以分享这些收益,而无需跟踪底层模型组合的每一次变化。这种灵活性只有在整体方案相对于客户的替代方案仍然具有吸引力时才有价值。
**这对创始人意味着什么:**衡量已完成工作的全部成本,对照客户的替代方案展示其价值,并选择一个买家能够预测的定价单位。对典型工作流和高成本工作流下的利润率进行建模,然后决定如何分享效率收益,同时保持整体方案的吸引力。
持续赢得溢价。
检验标准是:购买你的应用,是否能在总成本、质量、速度和风险的综合表现上,优于客户最佳的可信替代方案。这一比较既包括你的定价,也包括实施、运营和维护每个选项所需的工作量。
执行、上下文、证明和定价共同强化了购买的理由。可靠的工作和可信的上下文创造优势;清晰的证据使其价值可见;而定价让客户分享效率收益,同时激励供应商不断改进交付。
模型进步会持续改善客户的替代方案。你的优势必须以更快的速度扩大,应用才能持续赢得其溢价。
 本周图表:就业 FUD 正在消退Moses Sternstein·10 月 30 日阅读完整故事
本新闻通讯仅供参考之用,不应被视为法律、商业、投资或税务方面的建议。此外,本内容不构成投资建议,也并非供任何 a16z 基金的投资者或潜在投资者使用。本新闻通讯可能链接到其他网站,或包含来自第三方来源的其他信息——a16z 并未独立核实此类信息,也未对其当前或长期的准确性作出任何陈述。如果本内容包含第三方广告,a16z 并未审阅此类广告,也不为其中的任何广告内容或相关公司背书。文中提及、引用或描述的任何投资或投资组合公司并不代表 a16z 管理的基金工具中的全部投资;完整投资列表请访问 https://a16z.com/investment-list/。其他重要信息请参见 a16z.com/disclosures。您收到本新闻通讯是因为您此前选择了订阅;如果您不想再接收未来的新闻通讯,可以立即取消订阅。 1
关于本文的讨论
https://substack.com/profile/357551611-simon-says?utm_source=commentSimon Says20小时前
我发现本文中的框架与我在 SF Tech Week 期间记录并分析过的观察产生了共鸣,即:为客户构建特权上下文,正是模型实验室留给创业公司去交付客户希望从 AI 中获得的最终结果(OUTCOME)的空白地带。
而如果这套 harness 有以下支撑:1. 高效且准确的 RAG;2. 能提升成功率、降低人工干预率的日志与递归评估(evals);3. 基于成本(包括失败尝试)和可靠性(成功率)学习得出的模型路由,那么这一结果的质量将随着用例的积累而不断提升。
我在我文章的 #How to ride it 这一章节中更深入地探讨了具体实现:
https://simongydsays.substack.com/p/riding-the-exponential-of-ai-what
欢迎提供更多反馈并参与讨论! 回复分享https://substack.com/profile/528224862-nothing-is-accidental?utm_source=commentNothing Is Accidental18小时前
Harvey 报告的每周四到六小时,正是能够敲定定价问题的那个数字,而 Repsol 试点并未说明这一数字是以什么为基准衡量的。如果这些小时中有一部分如今要用于检查 Harvey 的编辑内容,那么实际节省就比表面上看起来要薄。这个数字扣除审核时间了吗? 回复分享还有 7 条评论...
暂无帖子