使用 Amazon Bedrock 和 Spring AI 构建自主 AI Agent
原文链接: https://aws.amazon.com/cn/blogs/machine-learning/build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/ 来源: aws.amazon.com 发现于: 管理台手动提交 说明: 本文由 AIHot汪 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
AI 总结
总结:使用 Amazon Bedrock 和 Spring AI 构建自主 AI Agent
这是一篇 AWS 技术博客(2026年11月11日发布),由 Viquar Khan 和 Mahammadali Saheb 撰写。文章介绍如何利用 Amazon Bedrock(尤其是 AgentCore)与 Spring AI,让 Java 团队在熟悉的 JVM/Spring 生态中构建可生产的自主 AI Agent。
核心背景
- 传统 Prompt-Response 交互已不够,Agent 需要具备 规划(Planning)、工具调用(Tool Use) 和 记忆(Memory) 三大能力,才能自主完成多步骤任务。
- Java 企业团队已有成熟的 CI/CD、运维和 Spring 模式。Spring AI 通过熟悉的依赖注入、自动配置和 Advisor 模式,把 AI 能力无缝融入 JVM。
- Amazon Bedrock AgentCore 提供框架无关、模型无关的生产级基础设施:托管运行时、记忆、浏览器自动化、代码执行、身份管理等。
解决方案概述
文章演示了两个可部署系统(共享同一架构模式):
单 Agent 旅行助手(推荐入门)
- 支持工具调用(天气查询、行程搜索)、流式响应、会话记忆、弹性模式。
- 使用 Spring Boot + Spring AI ChatClient + Bedrock Converse API。
多 Agent 智能文档处理(IDP)系统
- 五个专家 Agent(Lawyer、Mortgage、Insurance、Tax、General)+ 分类器。
- 规则引擎(基于 SpEL)、告警、低置信度人工审核、完整可观测性。
共同架构要点:
- 满足 AgentCore Runtime 契约(
POST /invocations、GET /ping)。 - AgentCore Memory(短期 + 长期记忆:语义、用户偏好、摘要、情景)。
@Tool注解实现工具调用。- 结构化输出映射到 Java Record。
- ARM64 容器镜像(适配 Graviton)。
- 模块化 Terraform 部署。
关键实现模式
- AgentCore Runtime 契约:用
@AgentCoreInvocation注解自动配置端点、JSON/SSE 处理与健康检查。 - 工具调用:
@Tool+@ToolParam,模型自主决定调用时机;支持多模态输入和结构化输出。 - 记忆:通过 Advisor 模式注入短期/长期上下文,支持按用户隔离。
- 规则引擎:在
application.yml中用 SpEL 定义业务规则(ALERT / BLOCK / WARN),支持可插拔告警服务。 - 多 Agent 协作模式:
- Router:按文档类型路由到专家。
- Evaluator:规则引擎评估结果并触发告警/人工审核。
- Parallel Fan-out(可选):并发调用多个专家后聚合。
生产就绪能力
- 弹性:Resilience4j 重试、熔断、超时。
- 十二要素配置:环境变量 +
@ConfigurationProperties,无状态、快速启动。 - 安全与身份:IAM 最小权限、OAuth 2.0 / JWT(如 Cognito)、AgentCore Gateway 限流。
- 负责任 AI:演示版 GuardrailService + 生产推荐使用 Amazon Bedrock Guardrails(内容过滤、拒绝主题、PII 脱敏、接地检查)。
- 可观测性:Micrometer Observation、领域指标、结构化日志、可选 OpenTelemetry → X-Ray。
部署与清理
- 代码仓库:aws-samples/sample-build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai
- 使用 Terraform + 脚本一键部署到 AgentCore Runtime(也支持可选 EKS 路径)。
- AgentCore 按调用计费、可缩至零,主要成本来自 Bedrock Token。
结论与下一步建议
Java 团队无需离开现有技术栈即可构建生产级 Agent。建议后续接入 AgentCore Gateway + MCP、Bedrock Knowledge Bases、Cognito 身份隔离、更完善的 Guardrails,以及 AgentCore Evaluations 做评估闭环。
整体上,这是一篇面向企业 Java 开发者的实用指南,强调用熟悉的 Spring 模式 + AWS 托管能力,把 Agent 从原型快速推向生产。
人工智能
使用 Amazon Bedrock 和 Spring AI 构建自主 AI 智能体
Java 团队已经建立了 JVM 工具链、持续集成和持续交付 (CI/CD) 管道以及运营模式,但将 AI 智能体从原型推向生产环境却充满挑战:智能体框架默认情况下并不能解决可扩展性、治理、安全性和运维问题。Amazon Bedrock 和 Spring AI 填补了这些空白,使 Java 团队能够构建自主 AI 智能体,这些智能体能够进行规划、调用工具和 API,并在多轮对话中保持上下文。Agentic AI(智能体 AI)正超越简单的提示-响应交互,迈向能够执行复杂多步任务的自主系统。
Java 仍然是企业软件中使用最广泛的编程语言之一。团队拥有现有的 CI/CD 管道、运维专业知识以及围绕 JVM 建立的成熟模式。Spring AI 通过熟悉的 Spring 模式(如自动配置、依赖注入和可组合的顾问组件)将 AI 能力引入 JVM。开发者可以使用与构建 REST API、安全性和数据访问相同的惯用方式来构建 AI 智能体。
Amazon Bedrock AgentCore 是一个用于大规模构建、连接和优化智能体的平台,支持任何框架或模型。借助 AgentCore,您可以大规模地构建、部署和运营 AI 智能体。它具有框架无关性和模型无关性:您可以使用首选的智能体框架和基础模型 (FM)。通过 AgentCore,您可以访问所需的生产级基础设施:托管运行时、记忆机制、浏览器自动化、代码执行和身份管理。
在本文中,我们将向您展示如何使用 Spring AI 和 Amazon Bedrock 以及 spring-ai-agentcore 在 Java 中构建自主 AI 智能体。我们将探讨两个系统的关键实现模式。第一个是单智能体旅行助手,它演示了工具调用和记忆功能。第二个是多智能体智能文档处理 (IDP) 系统,展示了专家智能体、规则引擎和警报如何协同工作。
前提条件
要跟随本教程进行操作,您需要以下内容:
- Java – JDK 21(必需)
- Spring Boot – 4.1(包含 Spring AI 2.0 和 spring-ai-agentcore 2.0)
- Maven – 3.9+。
- Node.js – 18+(用于 React 前端)
- Terraform – 1.5+。
- Docker – 包含 Buildx 以支持多架构构建。
- AWS 命令行界面 (AWS CLI) – v2,已配置凭据。
- AWS 账户。
什么使系统成为智能体
聊天完成调用可以生成文本,但它无法决定下一步做什么、访问外部系统或记住昨天发生了什么。智能体可以这样做,因为它结合了三种能力:
- 规划 – 给定一个目标,模型将其分解为步骤,确定优先级,并随着新信息的到来调整计划。
- 工具使用 – 除了生成文本外,模型还可以选择并调用外部函数,如 API、数据库和代码解释器,以在现实世界中采取行动。
- 记忆 – 上下文跨轮次(短期)和跨会话(长期)保持连贯,因此每个决策都建立在之前的基础之上。
检索增强生成 (RAG) 应用程序的工具使用能力有限(仅限检索),但没有规划循环。智能体具备所有这三种能力,在目标导向的循环中运行,直到任务完成或确定无法继续为止。
下图展示了端到端智能体管道中的这些能力,从请求到基于事实的答案。
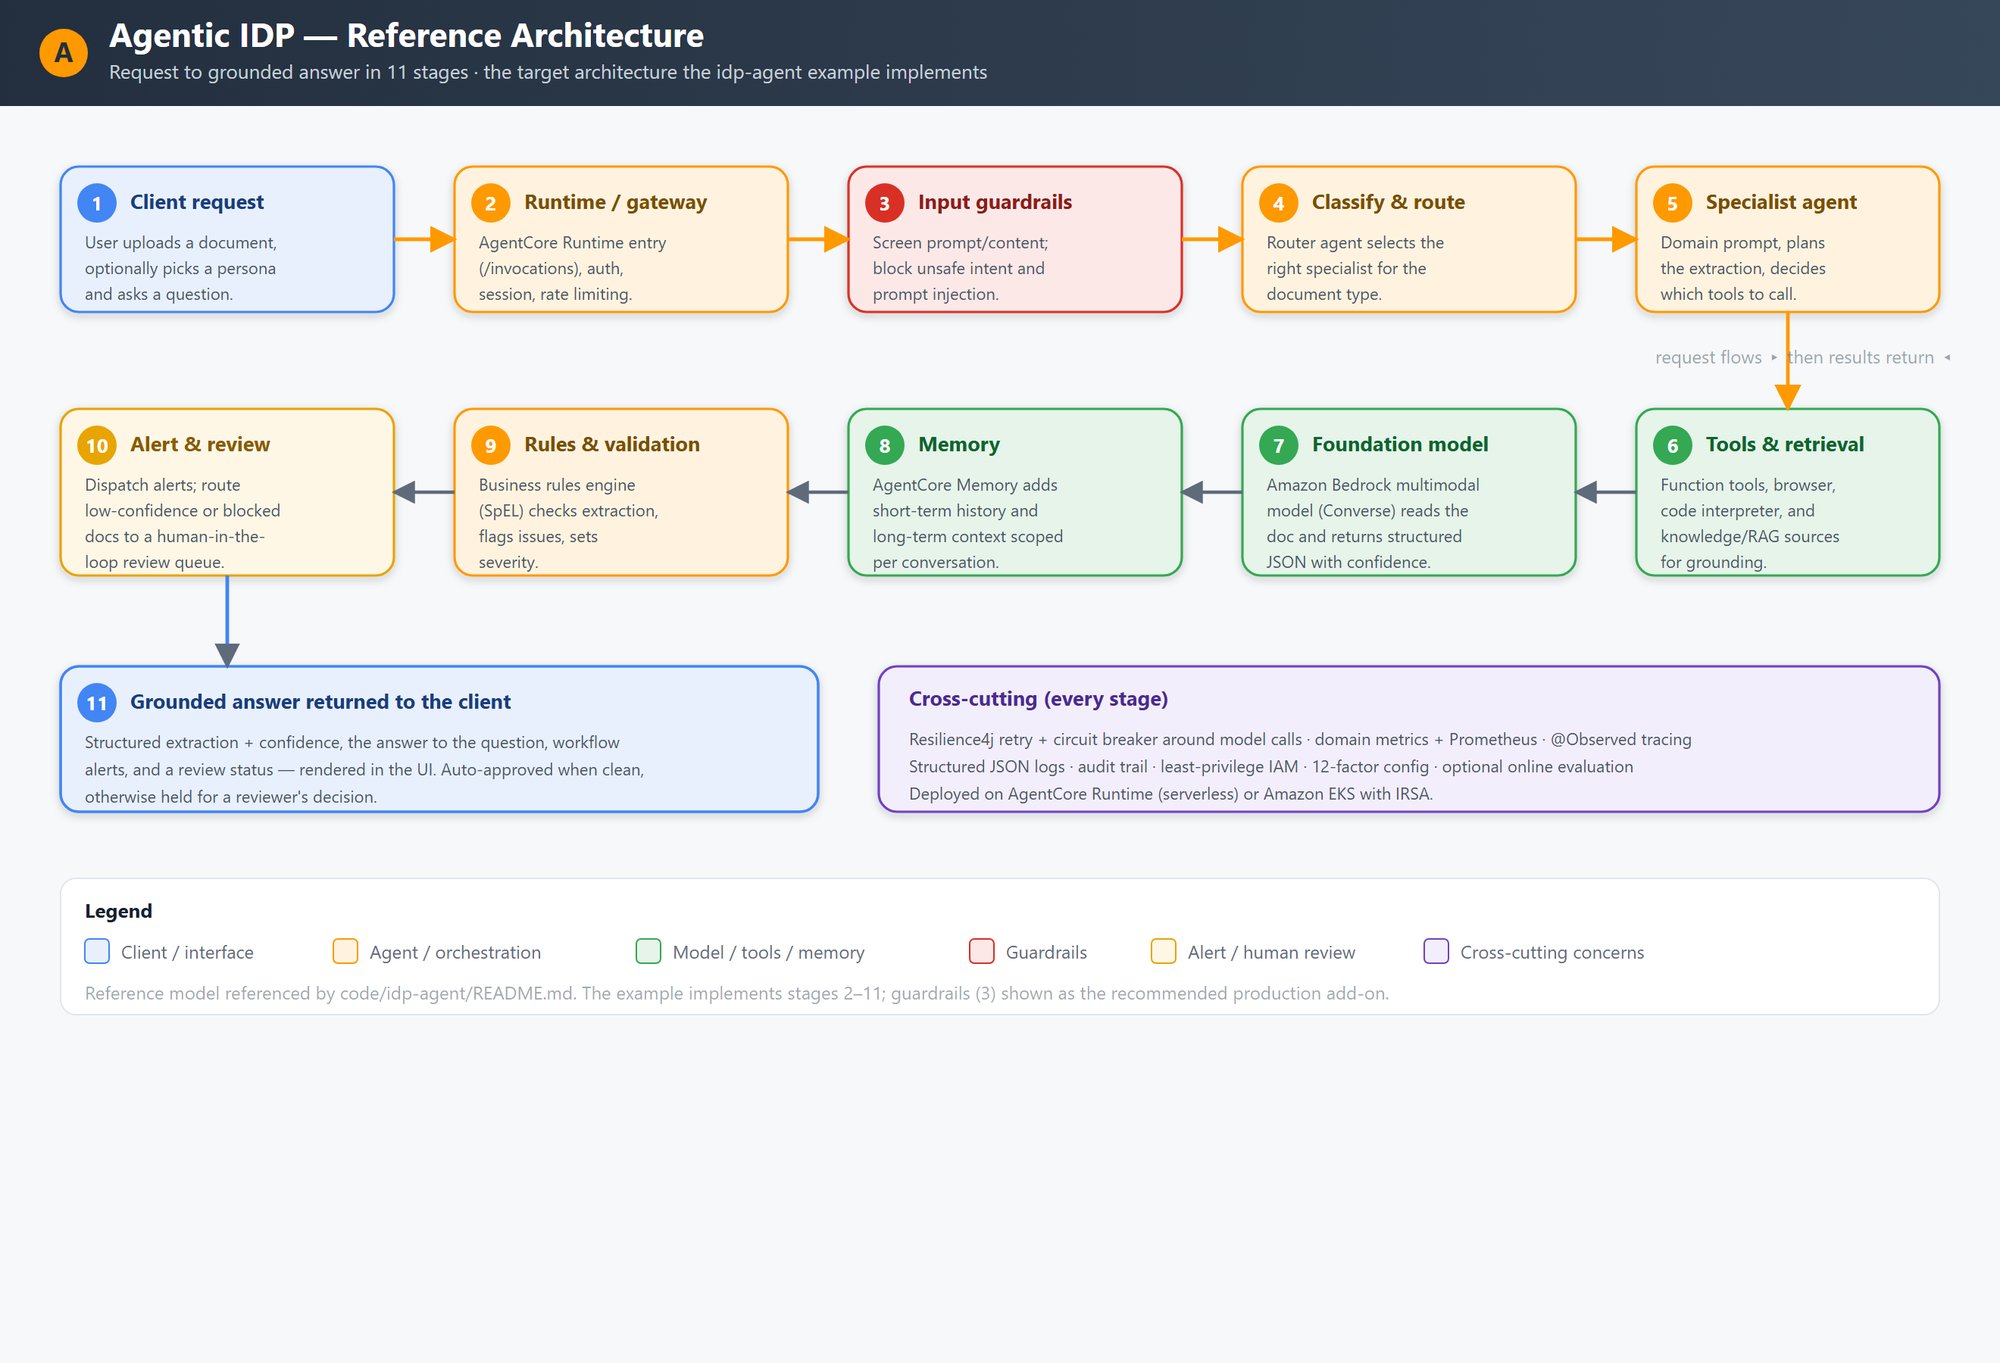
图 1:智能体参考架构。请求流经运行时、护栏、分类器、专家智能体、工具、基础模型、记忆、规则和人工审查,最终生成基于事实的答案,弹性和可观测性作为横切关注点贯穿始终。
该流水线包含 11 个阶段。客户端提交文档和问题。请求首先通过运行时网关进行身份验证和速率限制,然后由输入护栏(guardrails)筛查有害内容。路由器对文档进行分类,并将其路由至专家智能体(Agent)。专家智能体规划其工作流程,并根据需要调用工具、Amazon Bedrock 基础模型、记忆模块和规则引擎。低置信度或被标记的结果在进入人类审核队列后,再将基于事实的答案返回给客户端。弹性、可观测性、日志记录和最小权限 AWS Identity and Access Management (IAM) 策略应用于所有阶段。
解决方案概述
该解决方案由两个共享通用模式的可部署系统组成:
- 旅行智能体(Travel agent) – 一个具有工具调用(天气查询、行程搜索)、流式响应、对话记忆和弹性模式的单一自主智能体。这是推荐的起点。
- IDP 多智能体系统 – 一个具有五个专家智能体(律师、抵押贷款、保险、税务、通用)、规则和流程引擎、警报以及可观测性的智能文档处理平台。这展示了大规模下的生产级模式。
这两个系统共享以下架构:
- 使用 Spring AI ChatClient、Spring AI agentcore 和 Amazon Bedrock Converse API 的 Spring Boot 应用程序。
- AgentCore 运行时,这是 Amazon Bedrock AgentCore 的一项功能,定义了用于托管部署的契约(POST
/invocations,GET/ping)。 - 通过 AgentCore 记忆(Amazon Bedrock AgentCore 的一项功能)实现对话记忆,支持短期和长期上下文。
- 使用带有
@Tool注解的方法进行工具调用。 - 映射到 Java records 的结构化输出。
- 针对 AWS Graviton 优化的 ARM64 容器镜像。
- 用于基础设施配置的模块化 Terraform。
旅行助手是推荐的起点。下图说明了 Spring Boot 智能体如何与 AgentCore 运行时、工具、记忆以及 Amazon Bedrock 上可用的模型进行交互。
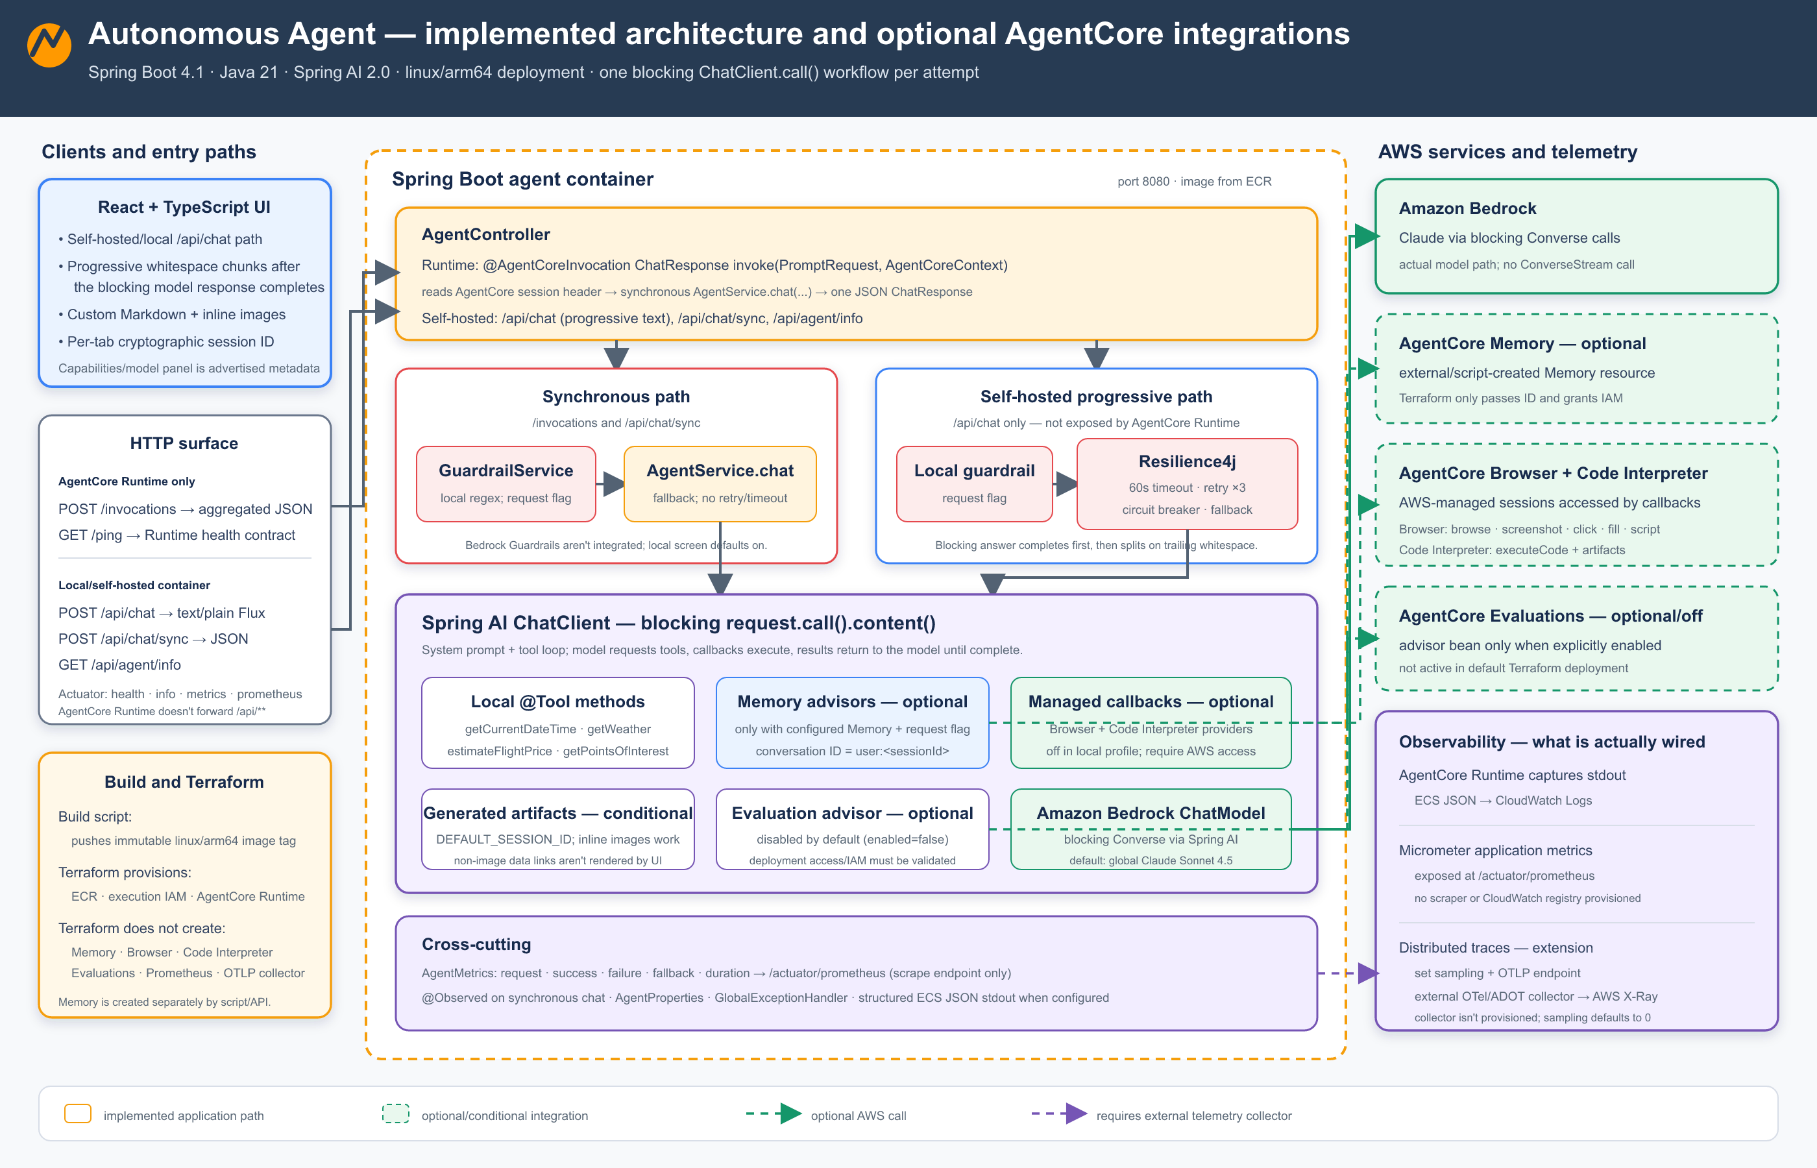
图 2:单智能体旅行助手。Spring Boot 应用程序同时为 React UI 提供 REST 端点和 AgentCore 运行时契约,通过 Converse API 调用 Amazon Bedrock,而工具调用、流式处理和记忆功能则在同一个代码库中运行。
旅行助手运行一个单一的 Spring Boot 应用程序,包含两个入口点,即 AgentCore 运行时所需的 /invocations 和 /ping 契约。Spring AI 通过 Converse API 编排对 Amazon Bedrock 的调用,并在同一进程内本地解析工具调用。服务器发送事件(Server-Sent Events)将生成的 token 流式传输到客户端。AgentCore 记忆提供会话内的短期上下文和跨会话的长期上下文,因此智能体无需外部状态管理即可保留对话历史。
下图显示了 IDP 多智能体系统的架构。
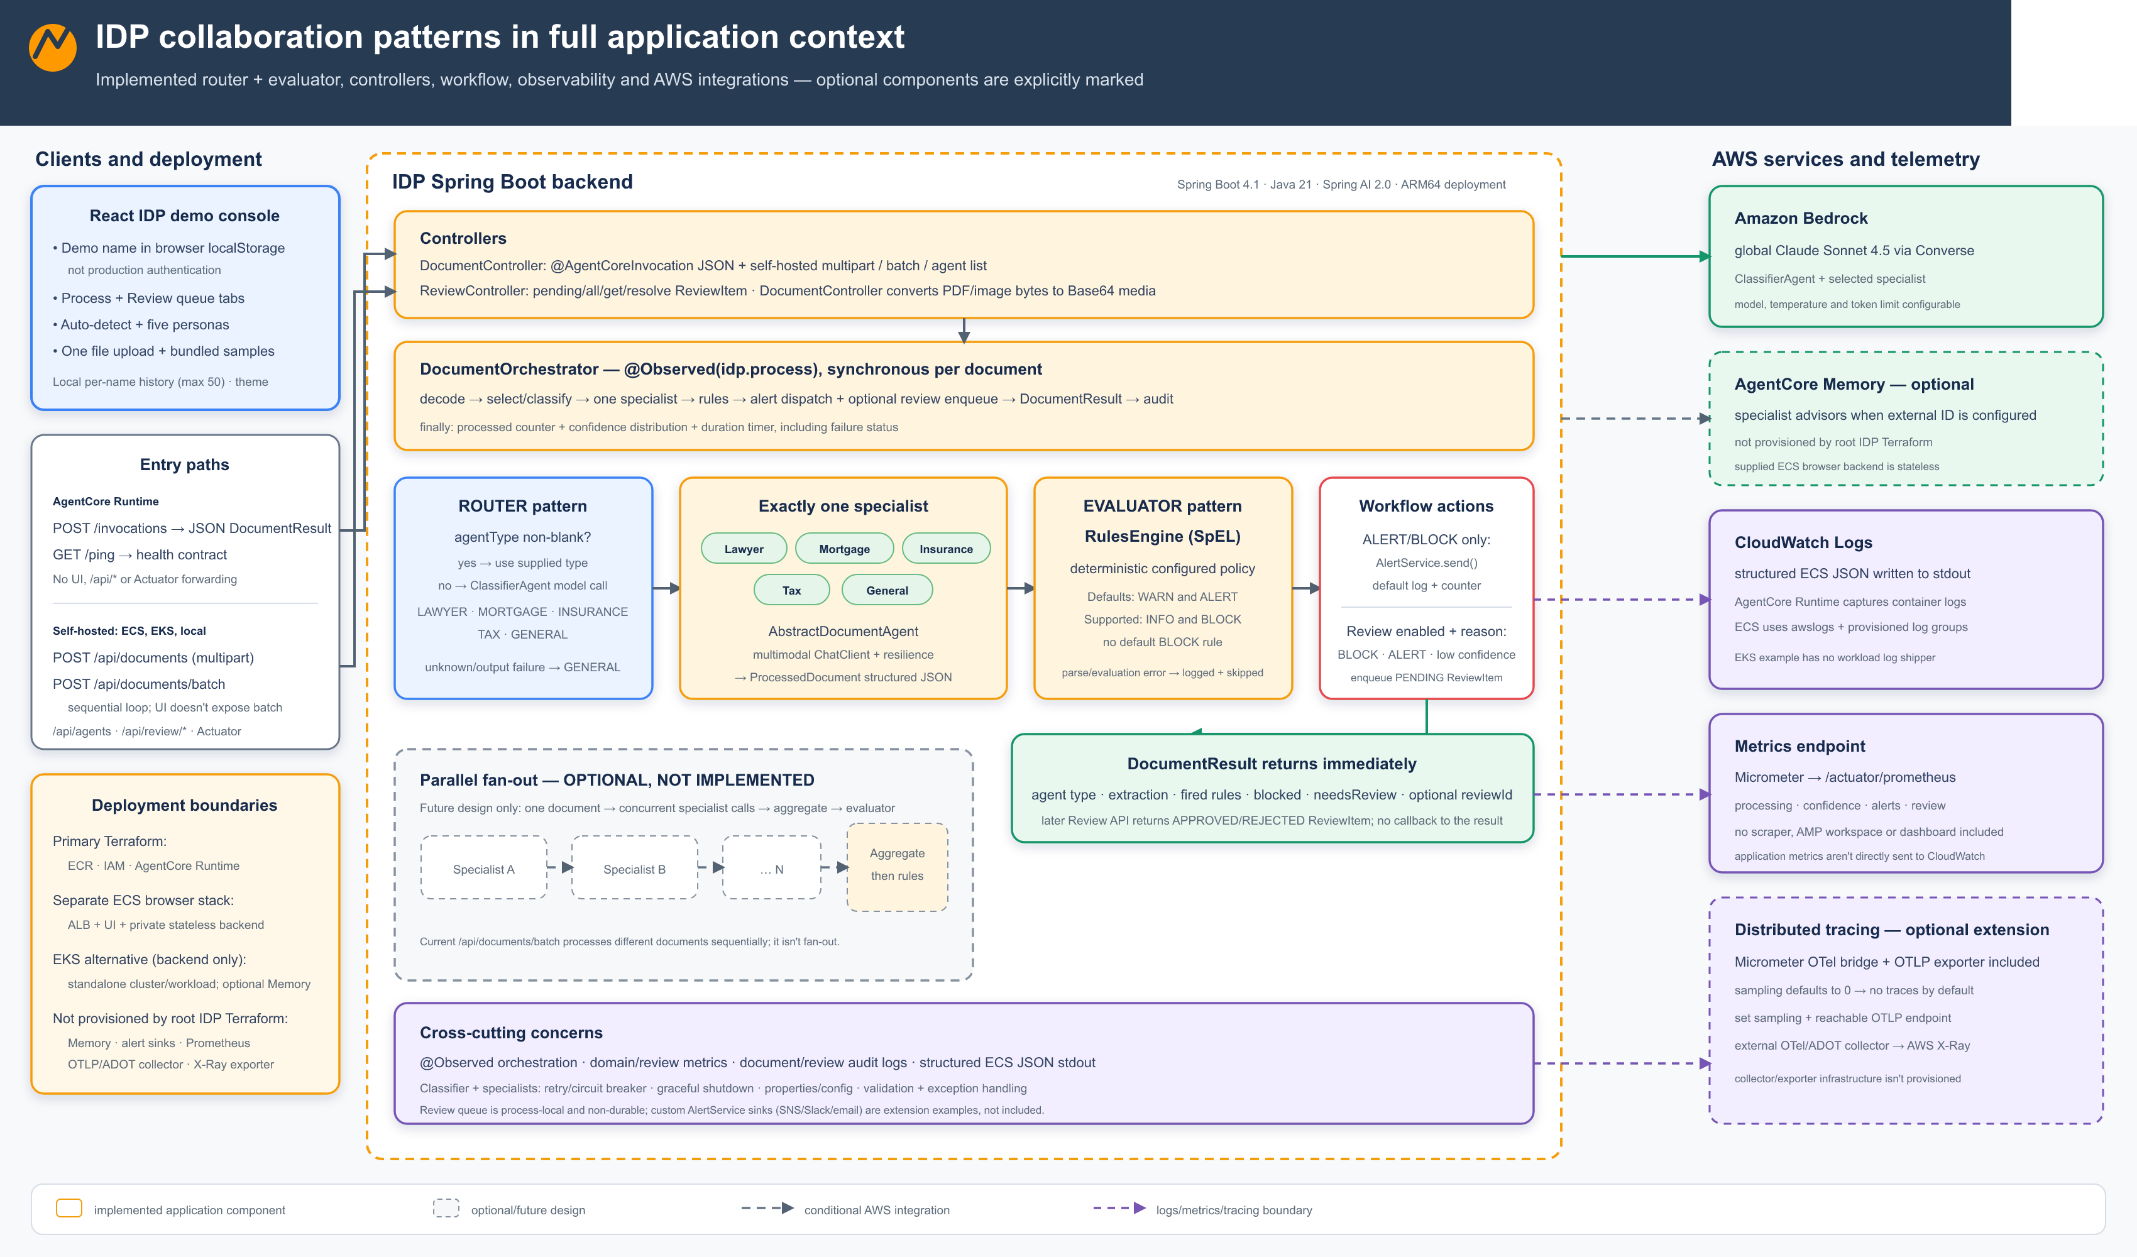
图 3:IDP 多智能体系统架构。专家智能体通过共享的 ChatClient 模式处理文档,结果流经规则引擎和警报服务。
IDP 多智能体系统将文档路由到五个专家智能体(律师、抵押贷款、保险、税务和通用),每个智能体都基于共享的 AbstractDocumentAgent 模板构建。ClassifierAgent 读取每份文档并将其转发给相应的专家。专家使用 Amazon Bedrock 的多模态 Converse API 提取带有置信度分数的结构化 JSON。规则引擎根据 application.yml 中的 Spring Expression Language (SpEL) 表达式对提取结果进行评估。ALERT 或 BLOCK 严重性规则通过 AlertService 进行分发。低置信度的文档进入人工审核。指标、审计跟踪、弹性和可观测性应用于所有阶段。
Agent 协作模式
当多个 Agent 协同工作时,它们的协调方式决定了系统行为。本解决方案使用了三种模式:
以下图表比较了本解决方案中使用的三种协调模式。
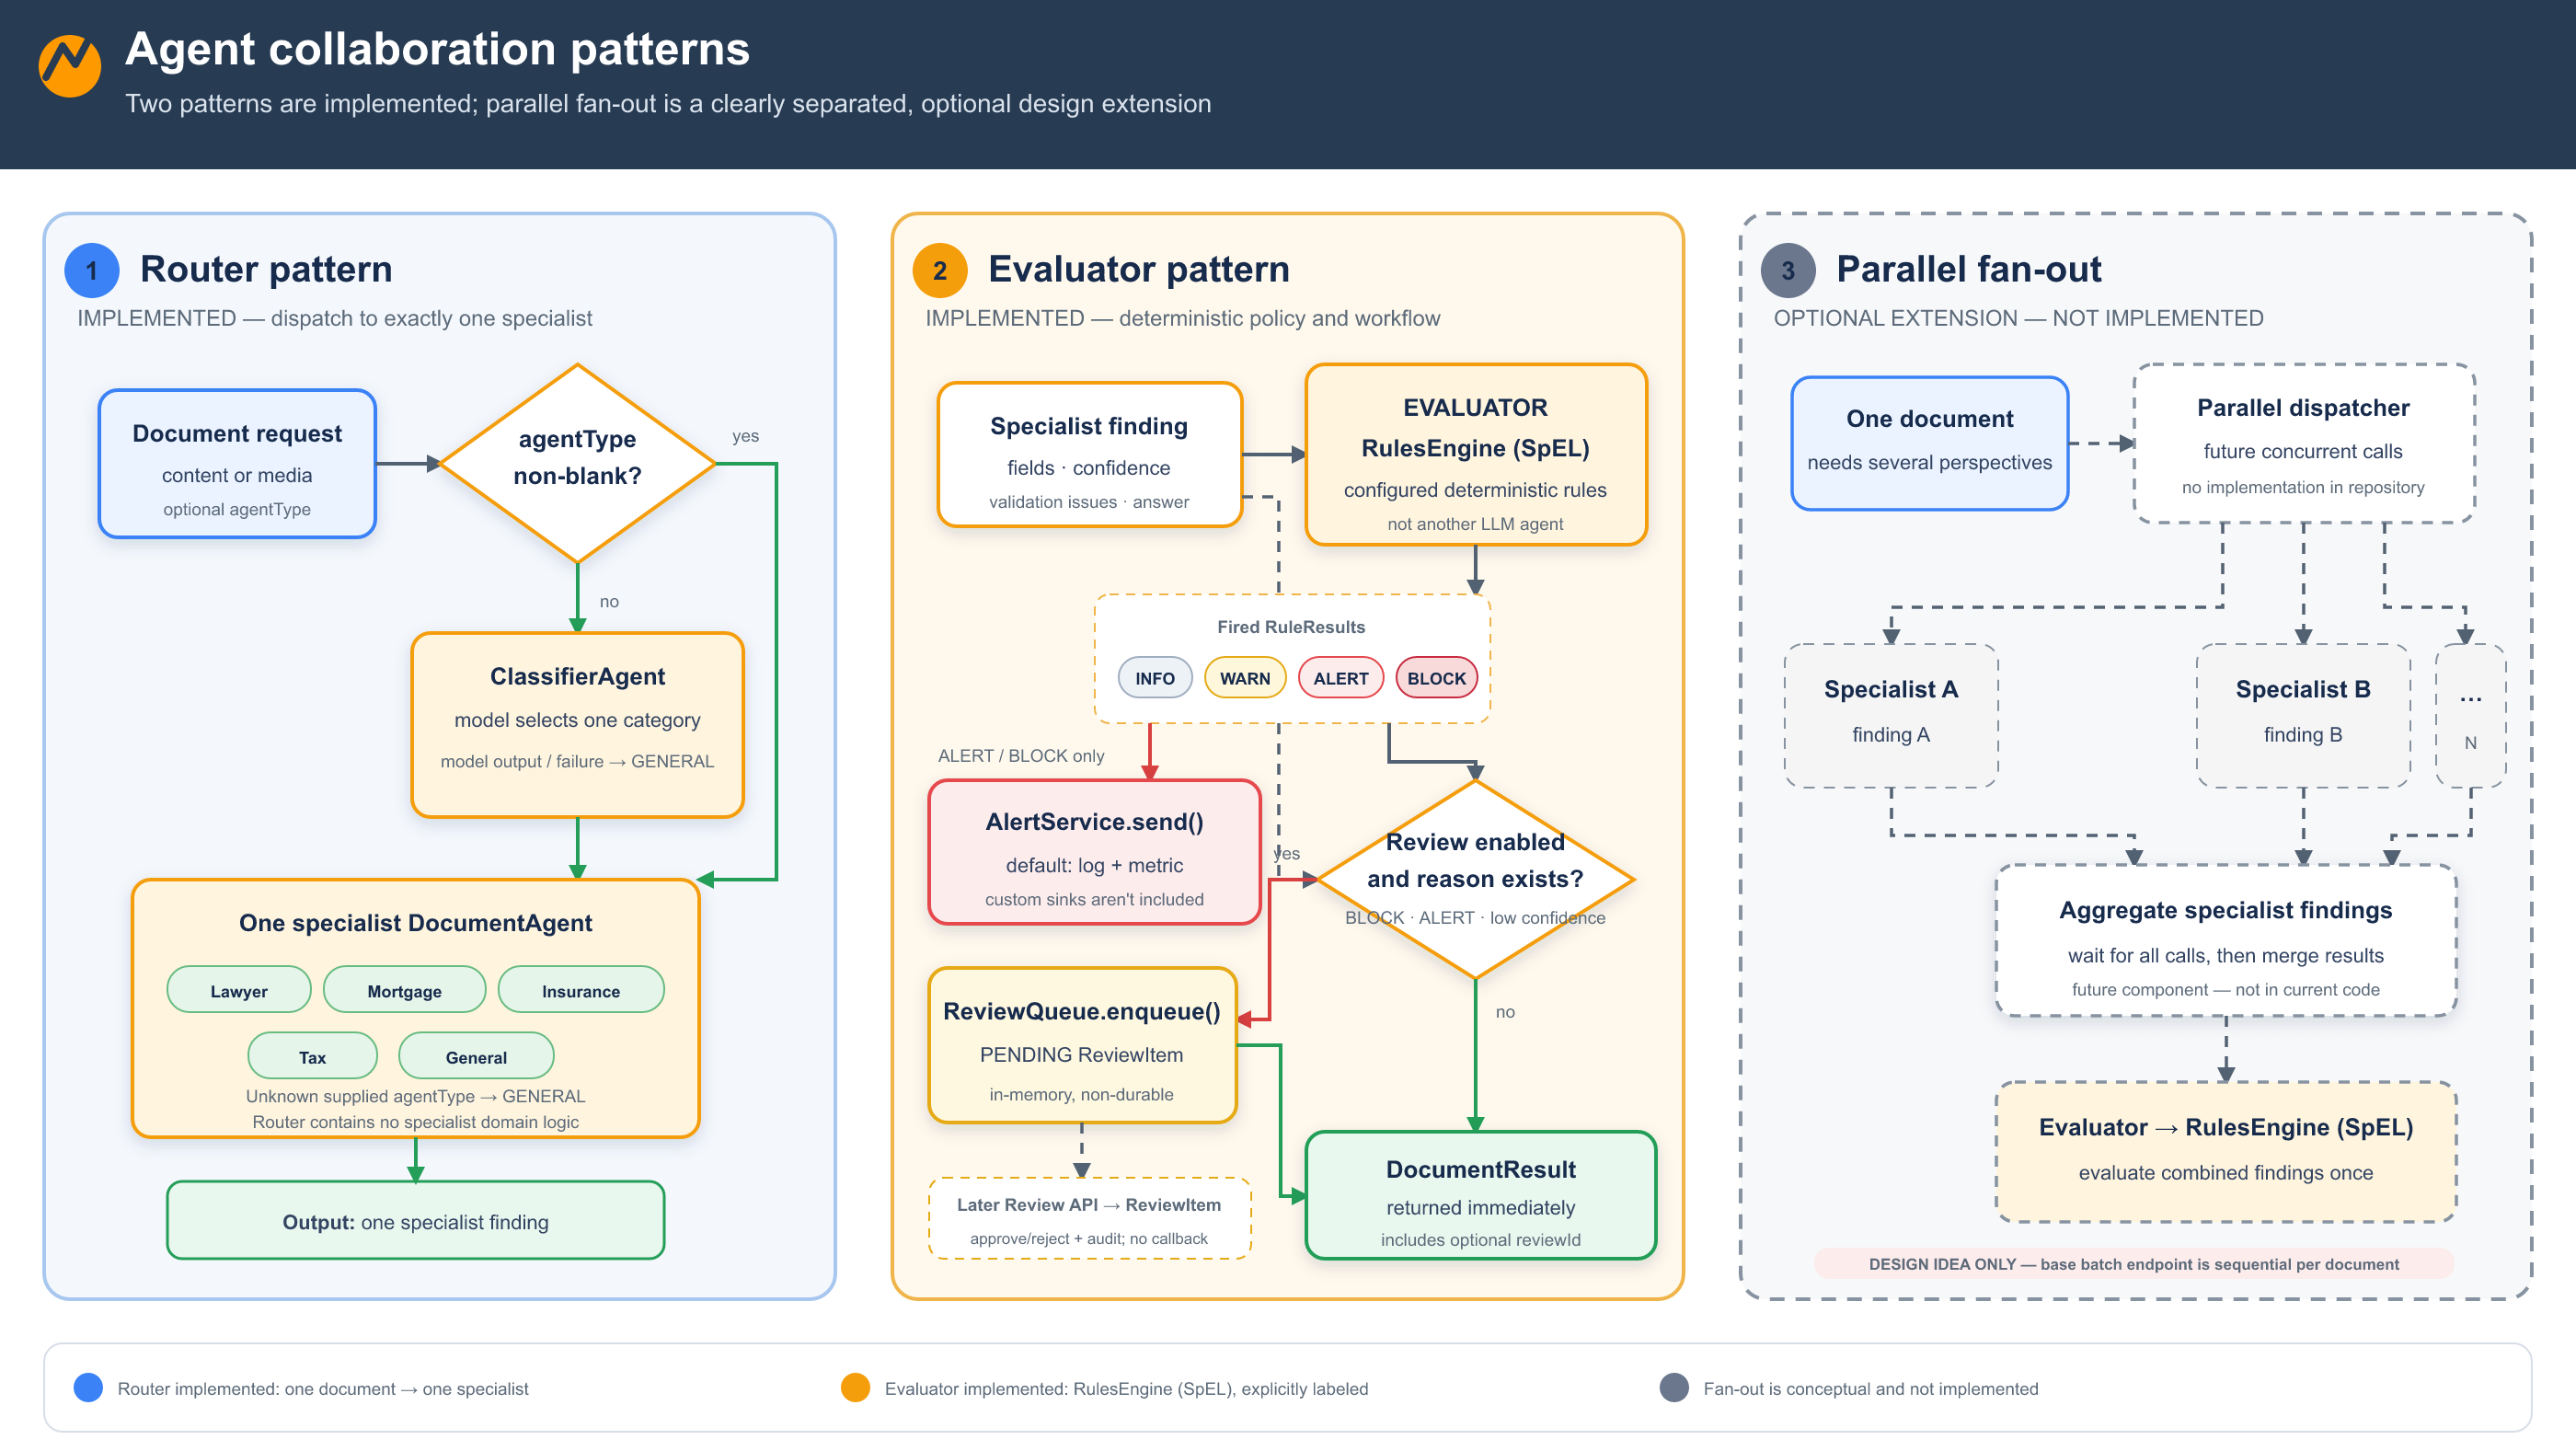
图 4:Agent 协作模式
三种模式并排显示。路由器根据文档类型将每个请求分派给一名专家。评估器将专家的分析结果通过规则引擎,该引擎应用严重程度级别并分派警报或阻止人类审查。并行扇出将单个请求同时发送给多个专家,并在规则引擎运行之前聚合结果。
路由器模式: 一个轻量级的编排器检查传入请求并将其路由到相应的专家。在 IDP 多 Agent 系统中,路由器检查文档类型元数据并将其转发给 Lawyer、Mortgage、Insurance、Tax 或 General Agent。路由器不包含任何领域逻辑。它仅是一个分派层。
并行扇出(可选扩展): 基础实现实现了路由器和评估器模式。批处理端点按顺序处理文档。当文档需要同时从多个视角进行分析时,您可以添加并行扇出作为即插即用扩展。同时向专家分派请求,并在规则引擎运行之前聚合它们的结果。组合分析的墙钟时间随后由最慢的单个 Agent 调用决定,而不是所有调用的总和。
评估器模式: 专家返回分析结果后,规则引擎根据可配置的业务规则评估组合输出。触发 ALERT 或 BLOCK 严重性的规则通过可插拔的 AlertService 分派给人类审查。
逐步指南
以下部分将引导您了解关键实现模式,从 AgentCore 运行时契约开始,逐步介绍工具调用、记忆、弹性和多 Agent 编排。
履行 AgentCore 运行时契约
Amazon Bedrock AgentCore 运行时管理 Agent 的生命周期和扩展。有关当前费率,请参阅 Amazon Bedrock AgentCore 定价和 Amazon Bedrock 定价。运行时将传入请求路由到您的 Agent 并监控其健康状况。您的 Agent 必须公开两个端点:
- POST
/invocations– 接收请求并以 JSON 或 Server-Sent Events (SSE) 流式传输形式返回响应。 - GET
/ping– 报告健康状况(Healthy或HealthyBusy)。长时间运行的任务必须发出忙碌状态信号,否则运行时可能会缩减 Agent 规模。
以下图表展示了 Spring AI 开发者模型如何映射到 AgentCore 运行时、Memory、Browser、Code Interpreter 和 Evaluations。
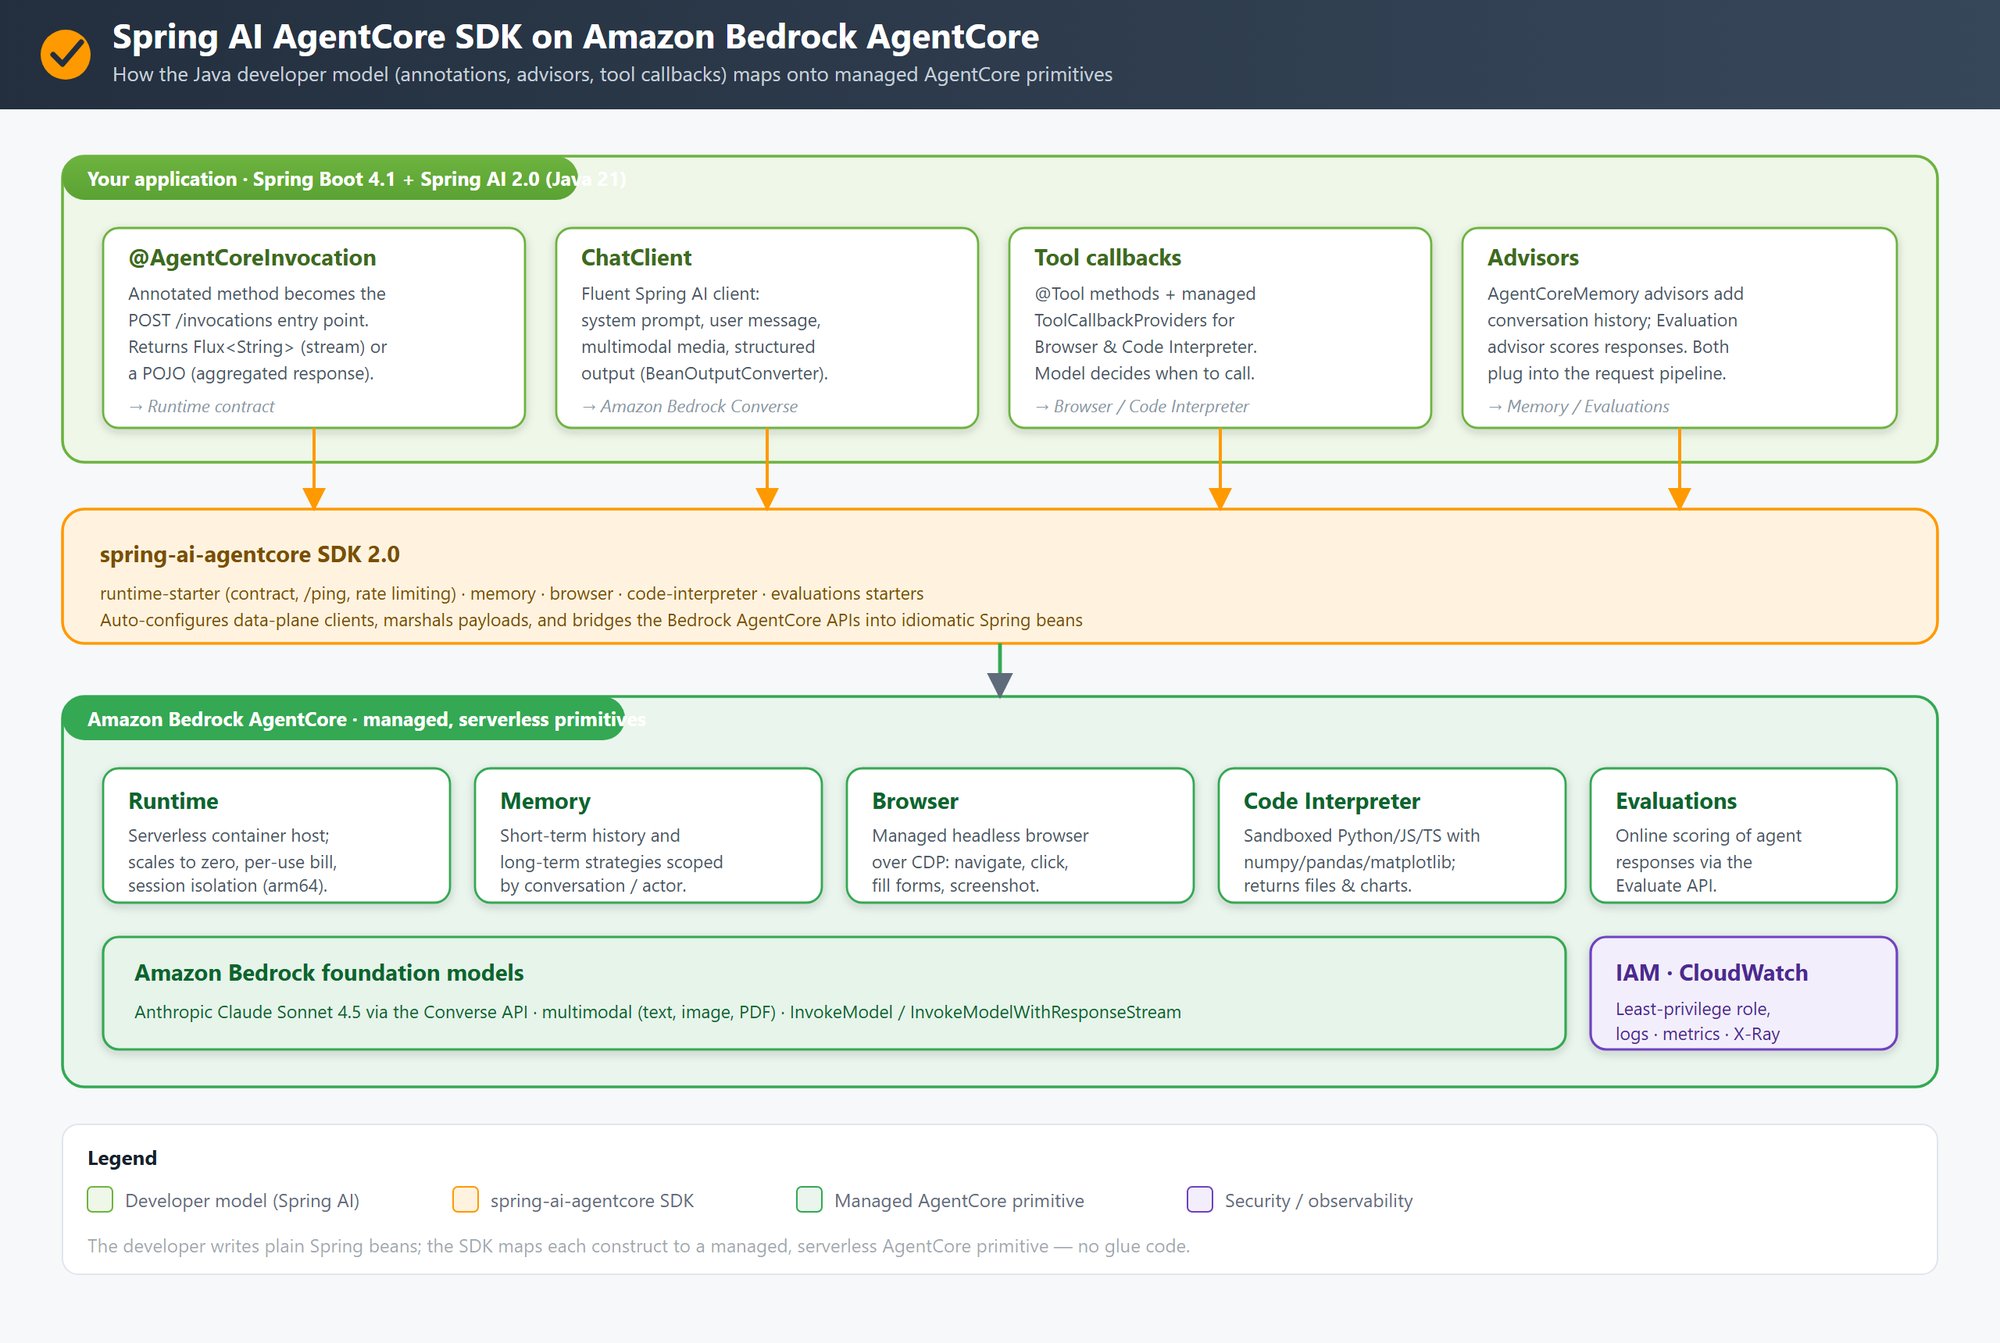
图 5:Amazon Bedrock AgentCore 上的 Spring AI AgentCore SDK。Annotations、ChatClient、工具回调和 advisors 通过 spring-ai-agentcore SDK 映射到 AgentCore 运行时、AgentCore 记忆、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations。
两层通过 spring-ai-agentcore SDK 连接。应用程序层使用 Spring AI 组件:用于端点连接的 @AgentCoreInvocation、用于模型交互的 ChatClient、@Tool 回调以及用于记忆和防护栏的 advisors。基础设施层提供 AgentCore 运行时、AgentCore 记忆、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations,这些都是 Amazon Bedrock AgentCore 的功能。SDK 桥接了这两层,因此开发人员可以编写标准的 Spring AI 代码,而 AgentCore 负责生产环境的基础设施。
借助 Spring AI AgentCore SDK,单个注解即可自动处理此契约:
@Service
public class TravelAgent {
    private final ChatClient chatClient;

    public TravelAgent(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @AgentCoreInvocation
    public Flux<String> chat(PromptRequest request) {
        return chatClient.prompt()
                .user(request.prompt())
                .stream()
                .content();
    }
}
@AgentCoreInvocation 注解会自动配置 /invocations 和 /ping 端点,处理 JSON 序列化,管理流式响应的 SSE 帧,并报告健康状态。同一项目还暴露了用于 React UI 的 REST 端点,因此该代理可以从单一代码库同时服务于 AgentCore 运行时和浏览器。
关于流式传输的说明:前面的最小化示例直接返回模型流,这非常适合聊天 UI。当代理进行多参数工具调用时,请使用阻塞式 call() 组装响应,然后将结果分块以进行流式传输,从而确保工具参数可靠绑定。旅行助手从同一个服务方法同时服务于 AgentCore 运行时和 React UI:
@RestController
public class AgentController {
    private final AgentService agentService;

    public AgentController(AgentService agentService) {
        this.agentService = agentService;
    }

    // 一个注解即可连接 POST /invocations + GET /ping、JSON/SSE 帧以及健康检查。
    @AgentCoreInvocation
    public Flux<String> invoke(PromptRequest request, AgentCoreContext context) {
        String sessionId = context.getHeader(AgentCoreHeaders.SESSION_ID);
        return agentService.streamChat(request.prompt(), sessionId,
                request.guardrailsEnabled(), request.memoryEnabled());
    }

    // 同一应用程序也从相同的代码库服务于 React UI。
    @PostMapping(value = "/api/chat", produces = MediaType.TEXT_PLAIN_VALUE + ";charset=UTF-8")
    public Flux<String> chatStream(@Valid @RequestBody PromptRequest request) {
        return agentService.streamChat(request.prompt(), request.sessionId(),
                request.guardrailsEnabled(), request.memoryEnabled());
    }
}
实现工具调用
借助工具调用,模型可以在推理过程中调用外部函数。在 Spring AI 中,你可以使用 @Tool 注解标记一个方法,模型将决定何时调用它以及使用什么参数:
@Tool(description = "Get a short weather forecast for a city")
public String getWeather(
        @ToolParam(description = "City name") String city) {
    return forecastService.lookup(city);
}
你在 ChatClient 上注册工具,模型决定何时调用它们:
ChatClient chatClient = chatClientBuilder
        .defaultSystem(properties.getSystemPrompt())
        .defaultTools(new DateTimeTools(), new TravelTools())
        .build();
对于结构化输出,请求一个 Java record 类型。对于多模态输入,将媒体附加到用户消息中:
ProcessedDocument review = chatClient.prompt()
        .system(personaSystemPrompt)
        .user(u -> u.text(question).media(mimeType, fileResource))
        .call()
        .entity(ProcessedDocument.class);
注意: 我们在 Amazon Bedrock 上使用 Anthropic Claude Sonnet 4.5 验证了此示例。Spring AI 会将 record 的模式添加到提示中,并将回复解析回 Java 类型。其他模型系列的行为可能会有所不同,因此请参阅 Spring AI 结构化输出文档和 Amazon Bedrock 文档以获取当前支持情况。这是尽力而为的,意味着模型偶尔可能会返回与模式不匹配的输出。为了获得更严格的结果,请使用具有原生模式强制执行功能的提供商,或使用 Spring AI 验证和重试机制。
模型将工具定义作为上下文的一部分接收,推理何时调用工具有助于满足用户请求,并返回结构化的工具调用响应。Spring AI 拦截此响应,调用注解方法,并将结果反馈给模型以进行进一步推理。
添加对话记忆
现实世界中的智能体必须记住用户在对话早期所说的内容(工作记忆)以及随时间推移所学到的内容(持久记忆)。Spring AI AgentCore SDK 通过顾问模式(advisor pattern)与 AgentCore 记忆集成:拦截器在提示到达模型之前,通过添加上下文来丰富提示。
chatClient.prompt()
        .advisors(agentCoreMemory.advisors)
        .advisors(a -> a.param(
                ChatMemory.CONVERSATION_ID, "user:" + sessionId))
        .user(prompt)
        .stream()
        .content();
会话 ID 以 actor:session 的形式成为对话 ID,因此每个用户的历史记录保持隔离。对于面向用户的部署,应从经过验证的 OAuth 2.0 (JWT) 身份中派生 actor,而不是使用客户端提供的值,以防止用户访问彼此的历史记录。
此外,AgentCore 记忆提供长期记忆支持,采用以下策略来识别和捕获对话中的关键见解:
- 语义(Semantic) – 关于用户的事实信息(例如,“用户在金融行业工作”)
- 用户偏好(User preference) – 明确的设置和选择(例如,“首选公制单位”)
- 摘要(Summary) – 浓缩的对话历史,以实现跨会话的连续性。
- 情景记忆(Episodic) – 过去的交互和吸取的教训。
长期记忆提取是异步且可选的。在创建记忆时,你可以选择启用哪些策略,AgentCore 会在每次对话后在后台提取和整理记录,因此绝不会阻塞智能体的响应。根据工作负载选择策略:对于旅行助手,使用用户偏好以记住单位和座位选择;当会话跨越多个回合时,使用摘要;当智能体应重用过去任务的教训时,使用情景记忆。使用语义记忆来保留关于用户的持久事实。
配置规则引擎
阅读文档只是工作的一半。对其发现的内容采取行动是另一半。IDP 多智能体系统包含一个规则引擎,以便操作员无需触碰代码即可添加业务检查。这是一个进程内规则评估器,它将 SpEL 条件应用于提取结果,而不是像 AWS Step Functions 这样的工作流编排服务。规则存储在 application.yml 中,每个条件都是一个 SpEL 表达式,针对提取结果进行评估:
idp:
  review:
    enabled: ${REVIEW_ENABLED:true}
    confidence-threshold: ${REVIEW_CONFIDENCE_THRESHOLD:0.7}
    rules:
      - id: legal-unsigned
        agentType: LAWYER
        condition: "field('signaturePresent') == 'false' || missing('signaturePresent')"
        severity: ALERT
        message: "Document appears unsigned; get all parties to sign before relying on it."
      - id: mortgage-high-dti
        agentType: MORTGAGE
        condition: "field('dtiRatio') != '' && T(java.lang.Double).parseDouble(field('dtiRatio')) > 0.43"
        severity: WARN
        message: "Debt-to-income ratio exceeds 0.43; likely needs manual underwriting."
      - id: low-confidence
        agentType: ALL
        condition: "confidence < 0.6"
        severity: WARN
        message: "Low extraction confidence; consider human verification."
严重性级别控制引擎的行为。INFO 和 WARN 会被记录日志,而 ALERT 则通过可插拔的 AlertService 进行分发。默认情况下会记录日志并发出指标,但你可以通过提供自己的 Bean 来替换为 Amazon Simple Notification Service (Amazon SNS)、Slack 或电子邮件。BLOCK 会将文档挂起以供人工审核。由于规则是操作员配置而非最终用户输入,因此它们提供了一个安全且可审计的扩展点。添加新工作流只是配置更改,无需部署。
评估器模式由规则引擎和可插拔的 AlertService 实现。默认实现会记录警报并发出指标。你可以提供自己的 Bean 以路由到 Amazon SNS、Slack 或电子邮件:
public class LoggingAlertService implements AlertService {
    @Override
    public void send(RuleResult result, AgentType agentType, ProcessedDocument document) {
        registry.counter("idp.alerts.sent",
                "severity", result.severity().name(), "type", agentType.name()).increment();
        logger.warn("ALERT [{}] rule={} type={} message=\"{}\"",
                result.severity(), result.ruleId(), agentType, result.message());
    }
}
生产就绪模式
以下模式解决了原型通常忽略的常见生产需求。
弹性
每次模型调用都使用 Resilience4j 重试机制(带有指数退避)、电路断路器(当模型调用反复失败或超时时快速失败)以及超时设置。流式路径会发出回退消息,而不是原始错误。当流量超过你的账户和 Region 服务配额时,AgentCore 运行时返回 HTTP 429,重试机制会处理此情况。有关当前限制,请参阅 Amazon Bedrock AgentCore 配额文档。
十二因素配置
每个可配置值(Region、模型 ID、内存 ID、超时时间、速率限制、系统提示)都是绑定到类型化 @ConfigurationProperties 类的环境变量。该应用程序是无状态的,启动速度快,在缩容时会排空进行中的交互,并以一个不可变的 ARM64 镜像发布,从开发环境到生产环境保持不变。
安全与身份
Agentcore 运行时默认使用 AWS Identity and Access Management (IAM) 认证。对于面向用户的 Agent,添加 OAuth 2.0 (JWT) 授权器(例如 Amazon Cognito),并从经过验证的身份中派生内存参与者 ID(actorId)。IAM 执行角色遵循最小权限原则:
- Amazon Elastic Container Registry (Amazon ECR) 拉取。
- 受限的 Amazon CloudWatch Logs 和 AWS X-Ray。
- Amazon Bedrock InvokeModel 操作。
- 用于 Agent 工作负载身份的受限工作负载访问令牌(
GetWorkloadAccessTokenForJWT)。 - 限制为特定 Memory 资源 ARN 的 AgentCore 内存操作。
AgentCore Gateway 是 Amazon Bedrock AgentCore 的一项功能,它强制执行入站认证(充当 OAuth 2.0 资源服务器,通过 Cognito、Okta、Auth0 或你自己的 OIDC 提供商验证 JWT 持有者令牌),并支持在网关层进行可配置的速率限制。速率限制默认是“故障开放”的,因此它们应作为你核心安全控制的补充,而不是替代。
负责任的 AI 控制
采取现实世界操作的自主 Agent 需要将安全控制作为首要关注点。示例代码提供了一个轻量级进程内预检查 GuardrailService 的占位演示。该服务根据 guardrailsEnabled 标志按请求切换,用于筛查不允许的意图和提示注入。生产部署使用 Amazon Bedrock Guardrails 作为应用于每个请求的标准控制措施,而不是按请求切换。
为了将演示服务升级为生产版本,请在 Agent 前端使用 Amazon Bedrock Guardrails。Guardrails 在模型调用之外应用可配置的策略,涵盖输入和输出:
- 内容过滤。基于针对提示和响应的可配置阈值,阻止有害或不相关的内容。
- 禁止主题。防止 Agent 与你定义为范围之外的主题进行交互。
- 敏感信息过滤器。检测和屏蔽提示和响应中的个人身份信息 (PII),支持 GDPR 和 HIPAA 等要求。
对于检索外部知识的 Agent,启用接地检查(grounding checks),以便在 Agent 使用具有现实世界副作用的工具调用之前降低幻觉风险。
要将 Bedrock Guardrails 集成到 Spring AI 中,请实现 CallAdvisor 和 StreamAdvisor 函数以调用 ApplyGuardrail API,并将其注册到 ChatClient 的 defaultAdvisors 上。由于策略位于 Guardrail 中,安全团队可以独立于应用程序发布周期来更新过滤器。
可观测性
该示例使用 Micrometer Observation API(@Observed)进行仪器化,生成计时器,当添加跟踪桥接器(OTLP 到 AWS X-Ray)时,这些计时器会成为分布式跟踪跨度。系统会发出领域指标:
idp.documents.processed{type,status}
idp.extraction.confidence{type}
idp.alerts.sent{severity,type}
idp.processing.duration{type}
这些指标通过 /actuator/prometheus 暴露。应用程序还会向标准输出发出结构化 JSON 日志,Amazon Bedrock AgentCore 运行时将其捕获到 Amazon CloudWatch Logs 中。
本文未实现的可选扩展:示例包含了 Micrometer OpenTelemetry 桥接器和 OTLP 导出器依赖项,但本文的部署并未配置 OpenTelemetry collector 或启用跟踪采样。您可以通过设置非零 TRACING_SAMPLING 值、将 OTLP_TRACES_ENDPOINT 指向 OpenTelemetry 或 AWS Distro for OpenTelemetry collector,并配置 collector 将跟踪转发到 AWS X-Ray,来添加分布式跟踪。
本文未实现的可选扩展:示例未实现自动评估或优化反馈循环。您可以通过持久化应用程序指标、跟踪、审计事件和人工审查结果作为评估数据集来添加此功能。然后,AgentCore 评估或单独的评估管道可以将版本化的提示词、模型、工具和路由规则与质量、安全性、延迟和成本阈值进行比较。仅在评估和人工批准后提升更改。
部署解决方案
此 GitHub 仓库 包含两个 AI 智能体应用程序,展示了自主 AI 的不同用例。本指南向您展示如何使用 Amazon Bedrock AgentCore 运行时将它们部署到 AWS。
以下图表展示了部署架构:一个通过模块化 Terraform 提升到 AgentCore 运行时的单个 Arm64 镜像,以及可选的 Amazon Elastic Kubernetes Service (Amazon EKS) 路径。
可选:在 Amazon EKS 上运行。 已经标准化使用 Kubernetes 的团队可以在 Amazon EKS 上运行相同的 Arm64 镜像,使用其现有的集群进行扩展,并通过 IAM Roles for Service Accounts (IRSA) 对 /ping 端点进行健康检查,从而获得对 Amazon Bedrock 和 AgentCore 内存的受限、最小权限的 Pod 级访问权限。容器是相同的,因此应用程序中没有任何更改。
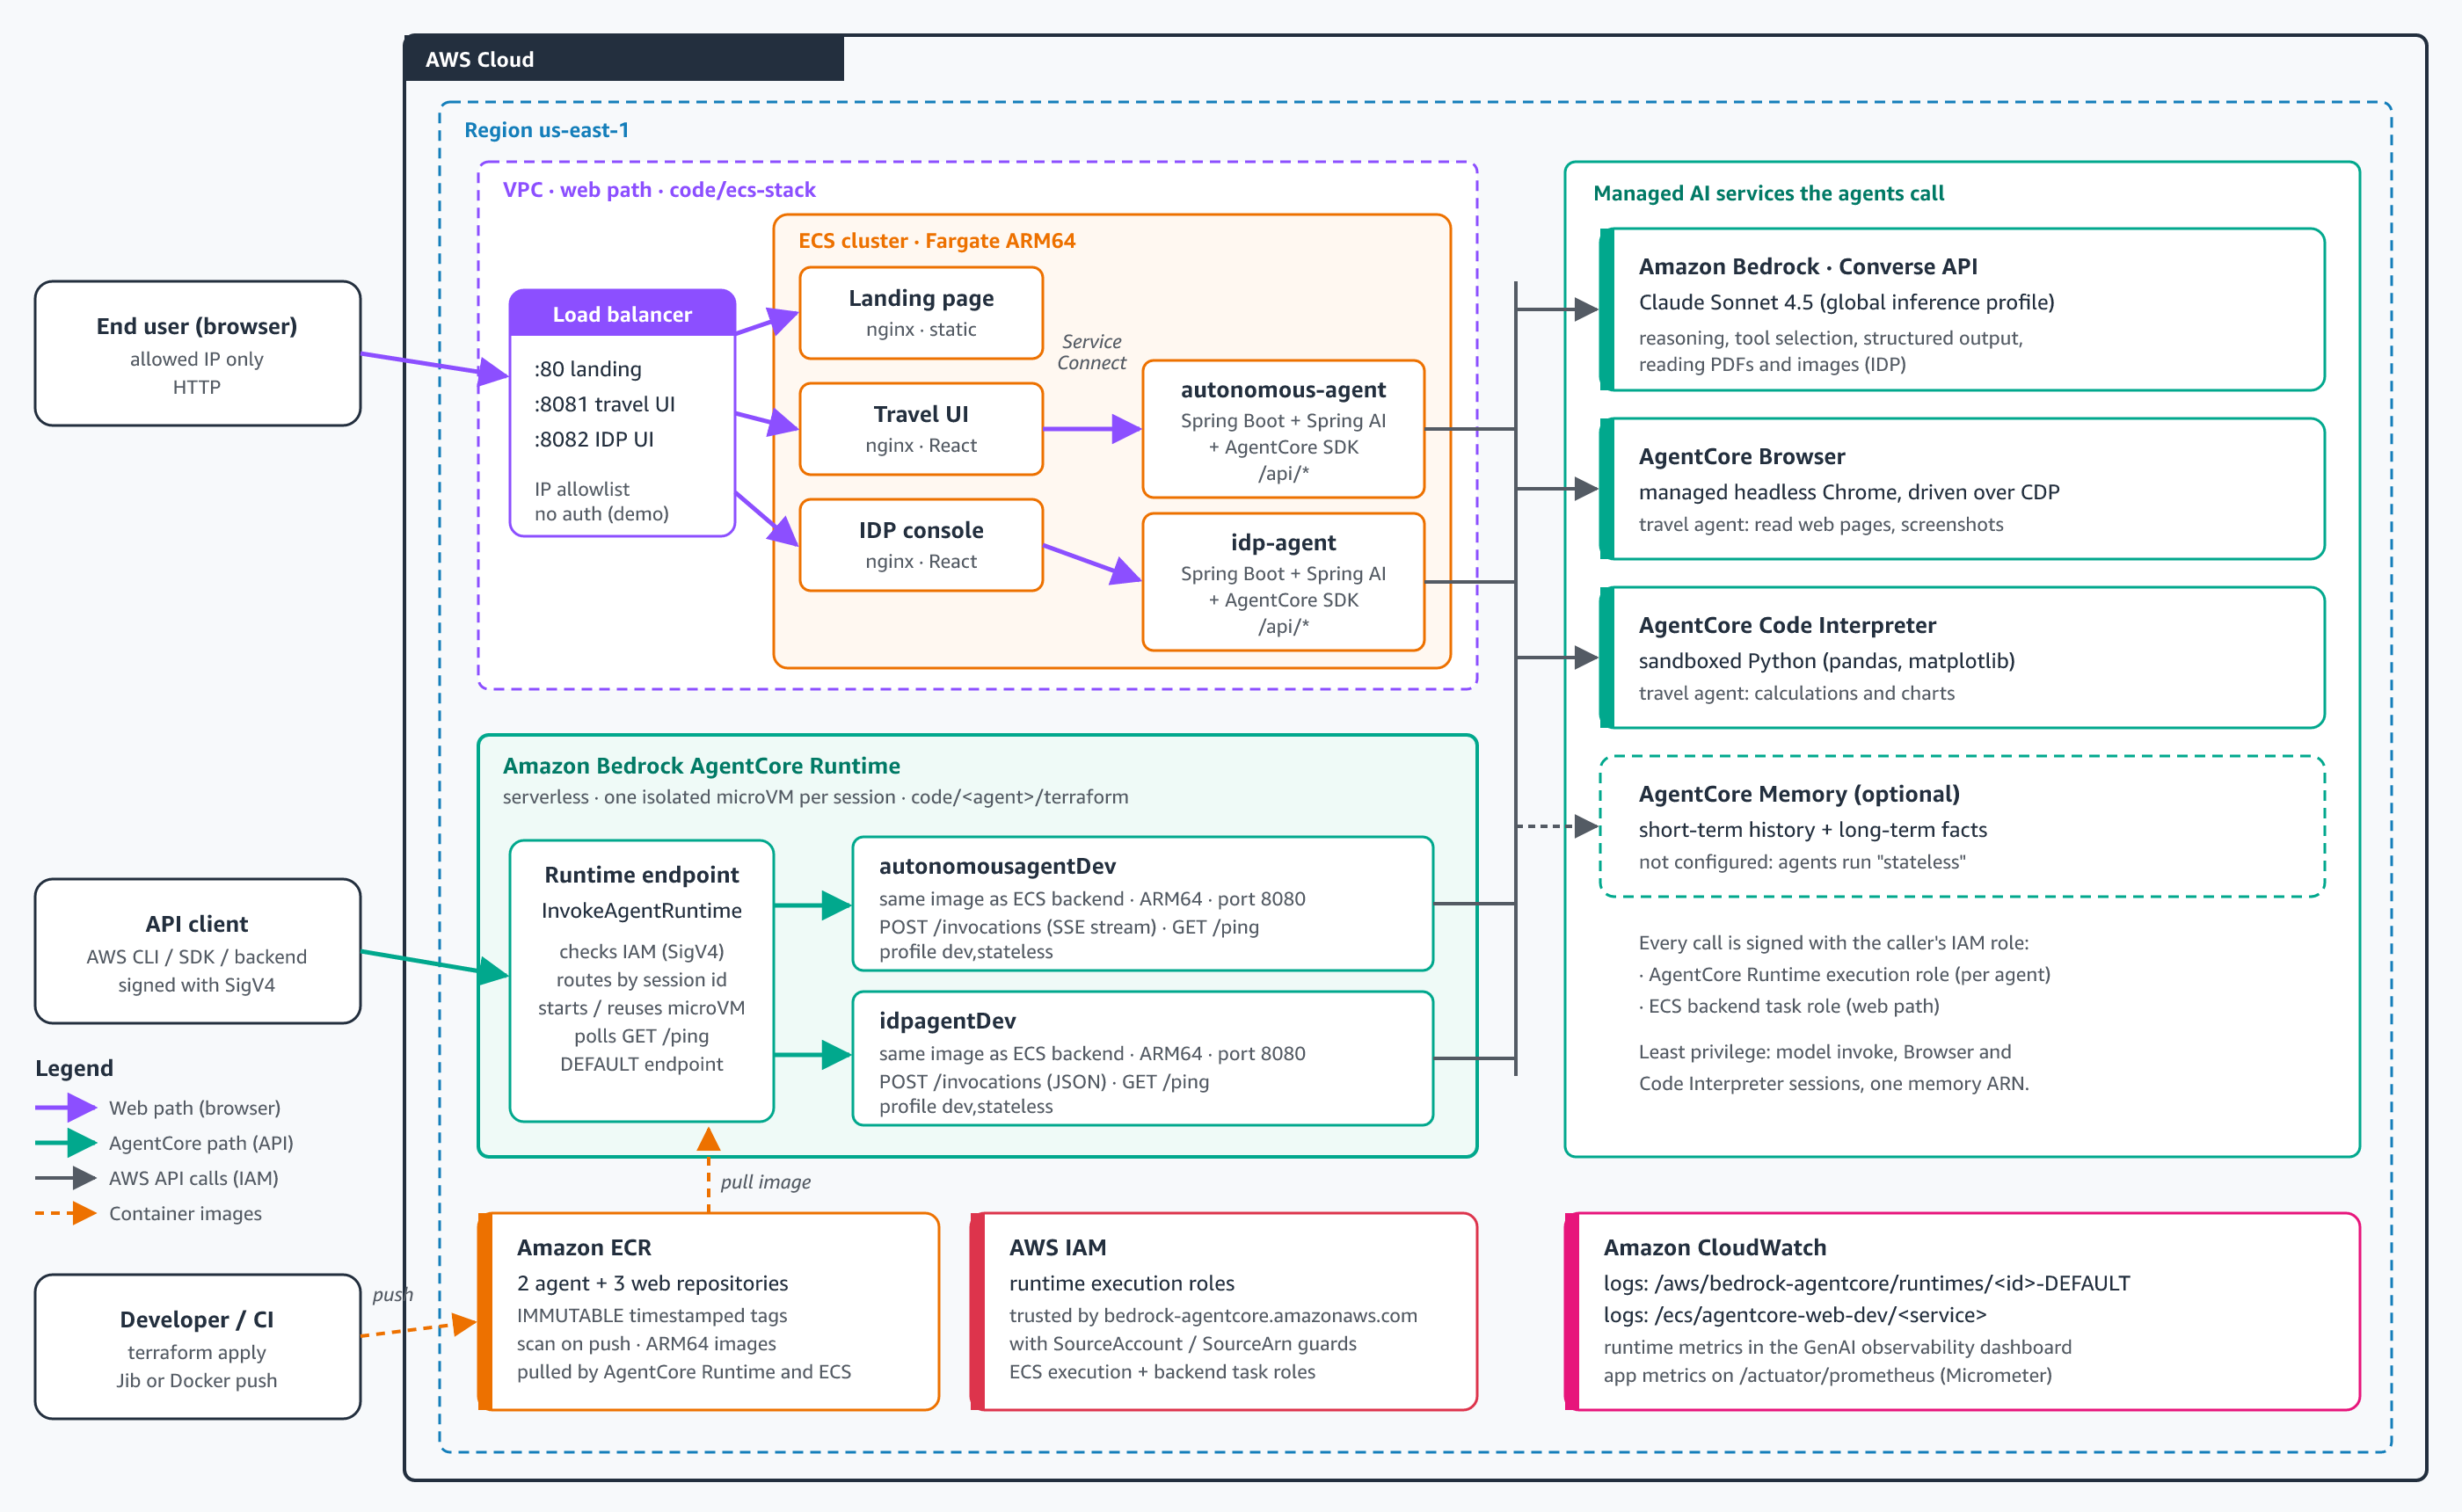
图 6:部署架构。模块化 Terraform 配置 Amazon ECR、最小权限 IAM 执行角色和 Bedrock AgentCore 运行时,并提供可选的 Amazon EKS 和 IRSA 路径,复用相同的 Arm64 镜像。
三个阶段:构建和发布、Terraform 以及在 AWS 上运行。CI 流水线将应用程序打包为 linux/arm64 镜像,并使用不可变标签将其推送到 Amazon ECR。三个 Terraform 模块配置 ECR 仓库、最小权限 IAM 执行角色和 AgentCore 运行时。智能体在 AgentCore 运行时上无服务器运行,调用 Amazon Bedrock 和 AgentCore 内存。可选的 Amazon EKS 路径复用相同的镜像,并使用 IRSA 提供受限的 Pod 级凭据。
请按照以下步骤部署任一应用程序。
步骤 1:克隆仓库
打开终端并运行:
git clone https://github.com/aws-samples/sample-build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai.git
步骤 2:导航到您要部署的代理所在的目录
部署自主代理 (autonomous agent):
cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/autonomous-agent部署 IDP 多代理系统:
cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/idp-agent
步骤 3:配置 Terraform 变量
在部署基础设施之前,请在 terraform 目录中的 terraform.tfvars 文件中配置您的 Terraform 变量。
基本配置
该解决方案对大多数设置使用默认值,但您可以在 terraform.tfvars 文件中自定义以下内容:
- AWS Region:资源部署的 AWS 区域。
- Environment:用于资源命名的环境 ID(例如
dev或prod)。 bedrock_model:Amazon Bedrock 基础模型(例如:global.anthropic.claude-sonnet-4-5-20250929-v1:0)。有关按区域划分的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型。
步骤 4:运行部署脚本
对于 Linux/macOS:
./scripts/deploy.sh dev
对于 Windows PowerShell:
.\scripts\deploy.ps1 dev
部署脚本执行以下操作:
- 创建 Amazon ECR 存储库。
- 构建 Java 应用程序。
- 创建并推送 Docker 容器镜像。
- 创建 IAM 执行角色。
- 部署 AgentCore 运行时。
步骤 5:运行应用程序
部署完成后,您可以使用以下命令运行应用程序。
对于 Linux/macOS:
./scripts/run.sh dev
对于 Windows PowerShell:
.\scripts\run.ps1 dev
清理资源
AgentCore 运行时支持缩容至零,并按每次调用计费,因此空闲代理的成本几乎为零。您的主要可变成本是 Amazon Bedrock token 使用量,以及少量的 Amazon CloudWatch 和 Amazon ECR 存储费用。有关当前费率,请参阅 Amazon Bedrock AgentCore 定价和 Amazon Bedrock 定价。为避免产生未来费用,请在完成后销毁基础设施:
对于 Linux/macOS:
./scripts/cleanup.sh dev
对于 Windows PowerShell:
.\scripts\cleanup.ps1 dev
使用 AWS CLI 删除不再需要的任何 AgentCore 内存资源和 Amazon ECR 镜像。
结论
在本文中,我们学习了如何使用 Spring AI 和 Amazon Bedrock 在 Java 中构建自主 AI 代理。我们介绍了将模型转变为代理的三种能力:规划 (planning)、工具使用 (tool use) 和记忆 (memory)。我们还展示了 Amazon Bedrock AgentCore 服务如何将代理推向生产环境。Spring AI AgentCore SDK 通过注解和熟悉的 ChatClient 将这些能力映射到惯用的 Spring 框架中。最后,我们概述了多代理协作的架构模式,包括路由器模式 (router pattern)、由规则引擎实现的评估器模式 (evaluator pattern),以及作为可选扩展的并行扇出 (parallel fan-out)。
对于 Java 团队的关键要点是:您无需离开现有环境即可构建生产级代理。您已经信任的模式(依赖注入、配置属性、顾问 (advisors)、Actuator、Micrometer)可以直接应用于代理领域。AgentCore 提供了生产环境所需的运行时、记忆、身份和治理功能。
作为后续步骤,请考虑以下内容:
- 通过 AgentCore Gateway 和 Model Context Protocol (MCP) 连接企业系统。
- 添加 Amazon Bedrock Knowledge Bases(完全托管的 RAG 功能)以及网络搜索功能,使 Agent 能够基于您的数据进行推理。
- 实现 Amazon Cognito JWT 身份验证,并支持按用户隔离的内存。
- 自定义 Amazon Bedrock Guardrails 策略:添加特定领域的禁用主题,收紧内容过滤阈值,并启用针对您的知识来源优化的 grounding 检查。
- 使用 AgentCore Evaluations 对生产环境中的 trace 进行评分,并在审查后推动 prompt 或模型的变更。
这些都是在您在此处构建的基础之上的增量式增强,而非重写。