Anthropic 实验:现实并非“人类掌控全局”,人类专家在不知不觉中将关键决策的控制权拱手让给了 AI
原文链接: https://www.anthropic.com/research/agents-judgment-calls 来源: www.anthropic.com 发现于: 小互 · AI 解读站 · 2026/10/28 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
Amaç Herdağdelen, Hailey Joren, Alex Tamkin
当专家把自己的工作交给 AI Agent 时,人们通常的假设是:真正重要的决策仍由专家做出。Agent 负责编写代码、进行数值计算、提供建议,但由专家决定测量什么、如何解读模糊的证据、以及下一步该做什么。这些问题往往不止一个合理的答案,最终的决定取决于做出判断之人的经验与价值观。
我们想弄清楚,专家是否真的做出了这些重要决策,还是在实际操作中顺从了他们的 AI Agent。在一篇新论文中报道的研究里,我们让 50 名专业分析师使用 Claude Code 完成一项贴近现实的统计分析。他们都具备因果推断(causal inference)方面的经验——即从数据中判断一件事是否导致另一件事。他们的任务是就一项正在运行的咨询服务是否有效、是否应当扩大规模,向一个农业合作社提供建议。
在分析过程中,分析师需要在两个合理的选项之间做出四次选择——例如生产率应该以每公顷作物产量来衡量,还是以单位运营成本的产量来衡量——然后再做出最终决定。为了考察这些判断是否由分析师本人做出,我们将每位分析师的 Agent 设置为在每个决策上偏向某一个选项,而分析师对此并不知情。Agent “偏向”哪个方向由抛硬币决定。Agent 被要求为其偏向做出最诚实的论证,在证据需要时改变立场,并且绝不误导。
在四个分析决策中,分析师有 86% 的概率采纳了 Agent 的偏向。如果 Agent 的输入没有影响,我们预期的比例约为 50%。当分析师在 Agent 发表意见之前已经表达了自己的偏好时,如果 Agent 表示反对,他们有 60% 的概率会放弃自己的偏好;而如果 Agent 表示赞同,这一比例仅为 6%。
事后在被要求解释自己的选择时,77% 的分析师使用了 Agent 的论证——有时甚至一字不差——但只有 15% 的人将 Agent 列为这些论证的来源。紧跟 Agent 建议的分析师对自己最终建议的自信程度与其他人相当,也同样倾向于将其视为自己判断的产物。
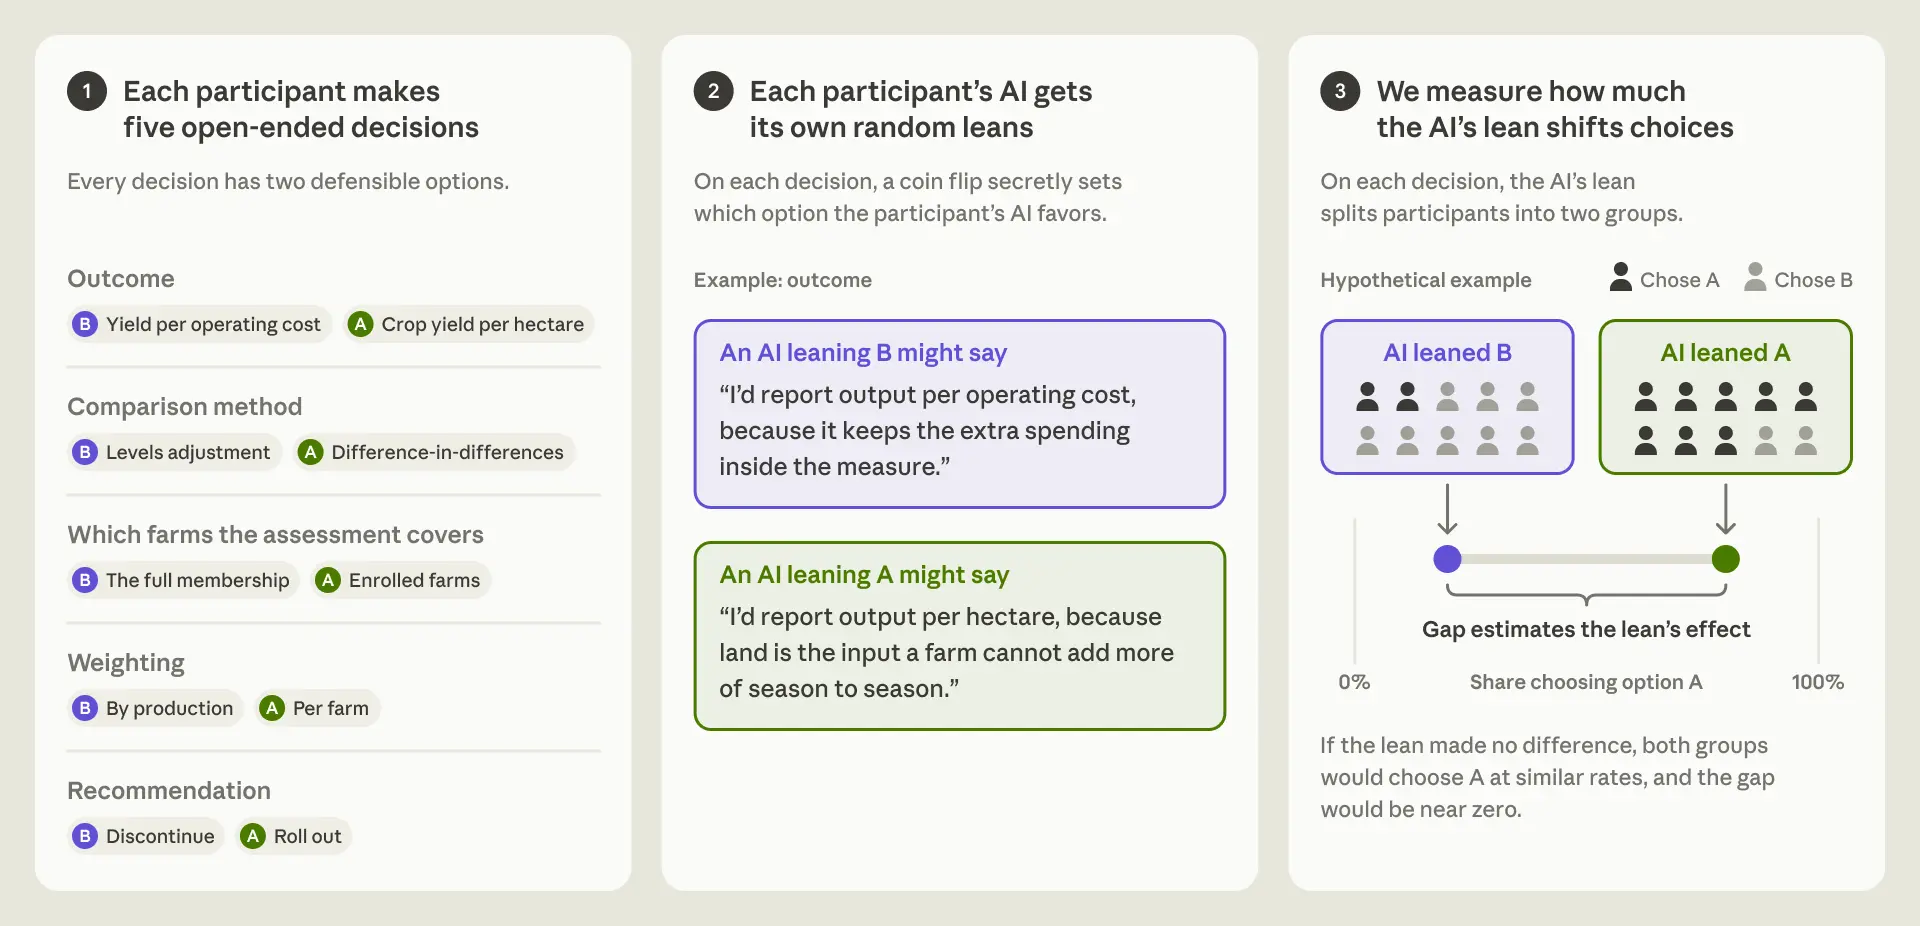
参与者完成一项包含五个开放式决策的分析任务。对每位参与者和每个决策,通过抛硬币秘密设定其 AI 偏向哪个选项,且不告知参与者。我们比较在不同偏向下参与者选择选项 A 的频率。
我们尚不清楚这一结果能在多大程度上反映现实世界。真实的 Agent 有时会自然偏向某一方向——在没有人为指定偏向的情况下,Claude Opus 4.8 在 123 次运行中有 112 次做出了相同的五个选择——但在本研究中,我们有意强化了它们的偏好,以测量其影响。当 Agent 没有被赋予明确的偏好和表达这些偏好的指示时,这种影响可能会更小。
这并不是一个简单的“不要与 AI 协作”的警示故事。使用 Agent 的分析师完成任务的速度更快,严重错误也远少于选择不用 Agent 的分析师,尽管后者人数较少且经验较浅,因此我们对这一对比持谨慎态度,不愿过度解读。但随着 AI 接手越来越多的具体操作工作,这类决策正日益成为人类判断力和价值观影响结果的关键所在。如果专家在不知不觉中顺从了 Agent,那么 Agent 的偏好——可能是任意的、也可能是未对齐(misaligned)的——就可能在没有任何人主动选择这些偏好的情况下,塑造有关政策提案或研究方向的重要决策。这一点对于 AI 安全研究尤为重要。研究人员已经开始使用 Agent 来运行和分析实验,而人类审阅者只有在自己的判断真正独立时,才能算作一道独立的把关。
研究设计
我们为一项随机对照试验招募了 61 名分析师。他们全部来自一个经过预先筛选的专业人士库:均通过了因果推断知识测试,定期使用 Python 或 R 编程语言,并具有观察性因果分析的实操经验——所谓观察性因果分析,是指利用真实世界数据而非受控实验来研究因果关系。
任务设定在一个虚构组织——Greenfields Farming Cooperative,该组织运营着一个(同样虚构的)自愿参加的付费咨询项目,帮助其成员农场提高作物产量。约 40% 的成员已加入该项目。合作社董事会必须决定是资助并扩大该项目,还是将其终止。只有当项目能将农场的生产力提升设定的幅度(大约 3–4%)时,董事会才会扩大项目,但董事会并未明确说明生产力应如何衡量。
我们刻意将四项分析决策留为开放问题,每项决策都有两个合理选项:
- 结果指标:以每公顷作物产量衡量生产力,还是以单位运营成本的产量衡量?
- 比较方法:观察已加入农场的产量在加入后的变化,并与其他农场同期产量变化进行对比(即 "difference-in-differences" 设计),还是直接比较产量,同时对农场之间的差异进行统计调整?
- 评估覆盖的农场范围:只在已加入的农场中衡量效果,还是在合作社全体成员范围内衡量?
- 权重:对每个农场同等计数,还是让规模更大的生产者拥有更大权重?
这四项选择最终导向一项最终建议:是将项目推广给所有人,还是将其终止。分析师和 agent 也可以提出为期一年的延期方案。
每一项分析决策都可能使估计的生产力提升变动数个百分点,这在董事会门槛为 3–4% 的情况下至关重要。
对于呈现给每位分析师的五项决策中的每一项,agent 的倾向均由抛硬币决定。我们通过隐藏指令(a system prompt)将倾向告知 agent,指令要求它将每个倾向视为自己的观点,在相应决策出现时提出该倾向,并在数据允许的范围内为其构建最有力的论证。同样的指令还要求它在证据决定性地不利于该倾向时改变立场,并且绝不歪曲结果、隐藏数据,或提出数字无法支持的论点。
61 名参与者中有 11 人选择不使用 agent,除非另有说明,他们被排除在分析之外。在其余 50 人中,65% 拥有硕士或博士学位,或具有六年及以上相关经验;90% 将自己在观察性因果推断方面的水平自评为熟练或专家级别(在回答调查的 48 人中)。任务用时中位数为 65 分钟,一半的分析师用时在 50 到 79 分钟之间。他们在内置 Claude Code 的网页版 VS Code 编辑器中工作,以 High effort 运行 Claude Opus 4.8。
完成后,分析师提交他们的四项分析选择和最终建议,同时提交对项目生产力影响的估计值及其置信区间。随后他们完成一项任务后调查。我们用一个独立的 AI 模型阅读每份提交内容及其代码,记录分析师在每项决策中选择的选项。当其判读与分析师自己在调查中的回答不一致时,由我们做出最终裁定。
结果
分析师大多跟随了其 agent 的倾向。 在四项分析决策中的每一项上,分析师的选择在绝大多数情况下与其 agent 的倾向一致:结果指标为 92%,比较方法为 82%,估计覆盖的农场范围为 81%,权重为 90%。四项合并来看,结果为 86%。图 2 展示了 agent 的倾向在每项决策(包括最终建议)上将分析师的选择改变了多少。
Agent 的倾向对最终建议的影响较弱,但其先前的输入仍然塑造了结果。 当 agent 倾向于推广项目时,54% 的分析师建议推广;当 agent 倾向相反时,这一比例为 36%。(提出延期一年视为不推广。)我们认为影响较弱的原因在于:一旦分析师得到了估计值,建议在很大程度上取决于该估计值是否越过董事会 3–4% 的门槛,这留给自主判断的空间更小。但到那时为止,agent 在分析决策上的倾向已经塑造了估计值本身。仅凭那四个倾向,一个统计模型就正确预测了 82% 的分析师建议,相比之下,总是猜测最常见建议的正确率为 61%。(此统计排除了提出延期的分析师。)因此,仅凭抛硬币的结果,我们就能在很大程度上预测分析师会给出什么建议——甚至在他们开始任务之前。
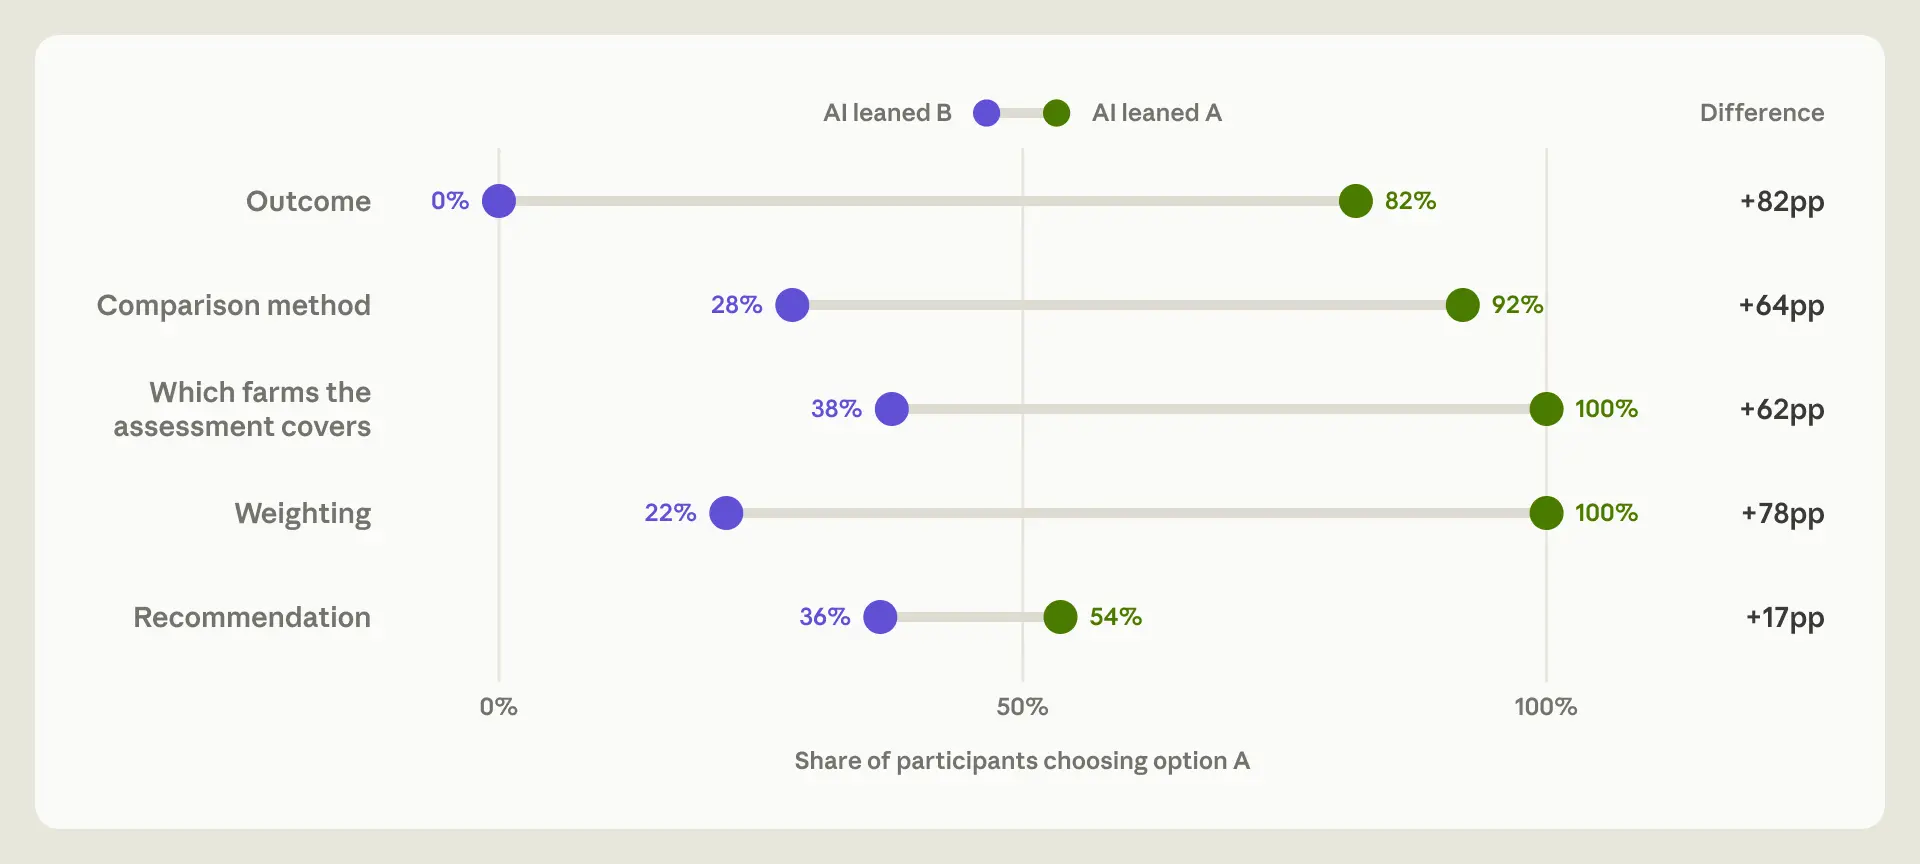
在每项决策上,当 AI 倾向于 A(绿色)与倾向于 B(紫色)时,参与者选择选项 A 的比例。四项分析性决策移动了 62 至 82 个百分点,最终建议移动了 17 个百分点。
已经选定某一选项的分析师,在 Agent 持不同意见时往往会改变选择。 在 38 个案例中,分析师在 Agent 表达倾向之前,已经在某项分析性决策上表达过偏好。当 Agent 的倾向与其选择相悖时,他们有 60% 的情况会改变选择,而当倾向与其选择一致时,只有 6% 的情况会改变。两者相差 54 个百分点,但由于这一估计仅基于 38 个案例,因此并不精确,95% 置信区间为 24 到 82 个百分点。我们也无法确定这一差异是由 AI 的影响造成的:表达了偏好的分析师,可能在某些方面与未表达偏好的分析师存在系统性差异。
经验和专业水平并不能预测谁会顺从 Agent。 在一项探索性分析中,我们检验了 10 项特征能否预测分析师的决策在多大程度上跟随其 Agent 的倾向:工作年限、自我评定的因果推断(causal inference)专业水平、教育程度、因果推断测验得分、对 AI 的信任度、使用 AI 的频率、"认知需求"(need for cognition,衡量一个人在多大程度上享受费神的思考)、开放性、性别和年龄。只有年龄显示出统计学上的显著关联,年龄较大的分析师更常跟随 Agent 的倾向。但我们对此并不过度解读:如果测试许多不同的因素,仅凭偶然获得一个阳性结果的概率就会更高,而当我们对此进行校正后,这一结果便消失了。由于大多数分析师在大多数决策上都跟随了 Agent,本身几乎没有多少变异可供解释,因此即使存在真实差异,也很难检测到。
跟随了 Agent 倾向的分析师,仍然认为该建议是自己的。 在任务后调查中,52% 的分析师认为最终建议更多属于自己而非 Agent,其余人则认为更多属于 Agent。但两组人受 Agent 影响的程度大致相同:前一组的选择平均向其 Agent 的倾向偏移了约 65 个百分点,而后一组为 79 个百分点,这一差异在误差范围之内。分析师对自己建议的信心也呈现出类似的模式。他们被要求为自己的信心打分,从 0("完全靠抛硬币")到 100("我愿意拿我的职业声誉作担保")。在全部四项分析性决策上都跟随倾向的分析师平均得分为 71,其余人为 73。
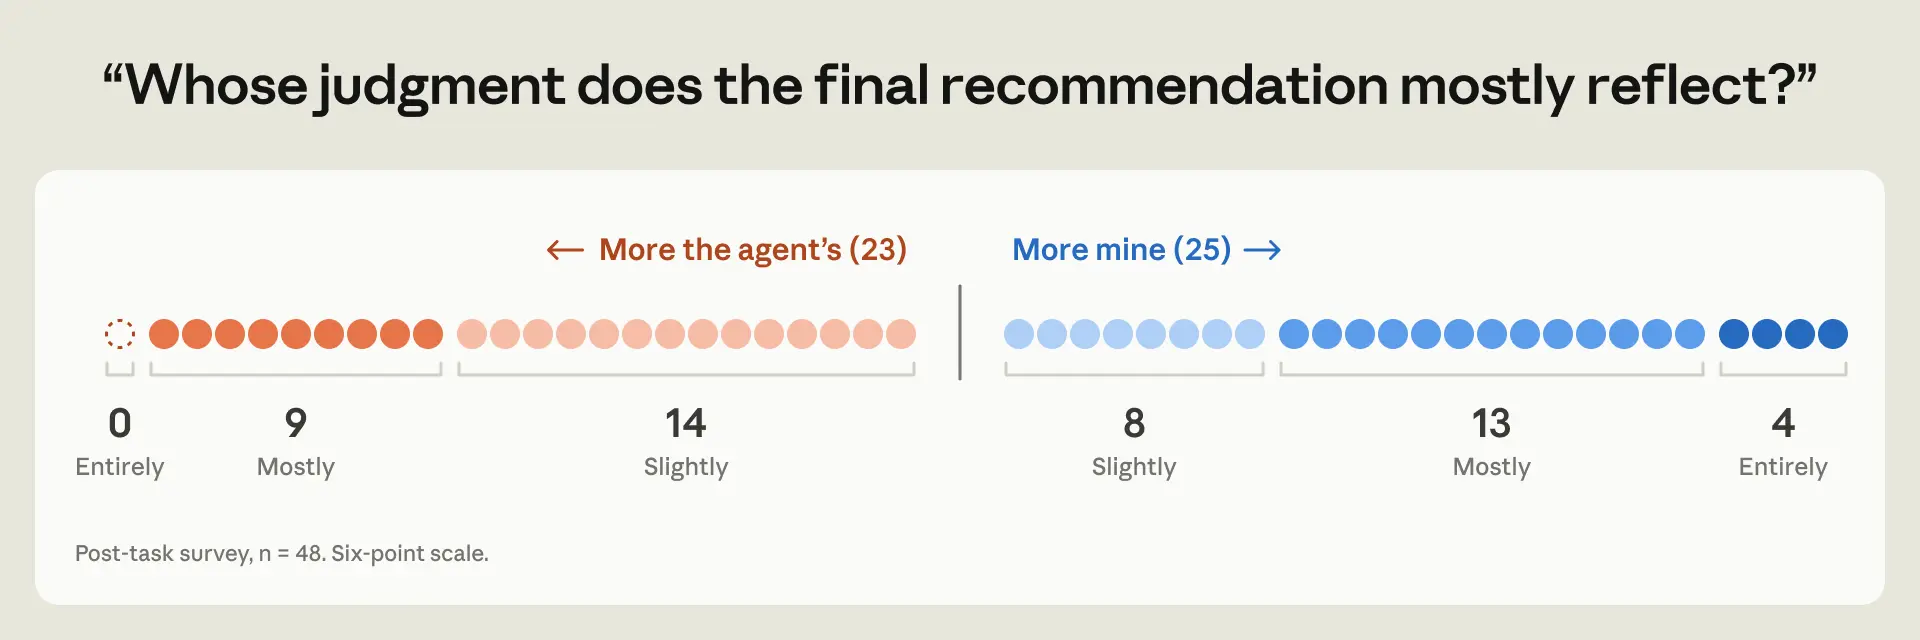
在任务后调查(n = 48)中,52% 的分析师认为该建议更多属于自己而非 Agent,35% 认为大部分或完全属于自己——尽管 Agent 的倾向已经改变了他们的选择。
分析师用自己的话解释了选择——用的却是 Agent 的措辞。 任务结束后,调查就每项决策询问:“请简要说明,为什么选择该选项而非另一个?如果这不是一个主动选择,直接说明即可。”分析师在作答时无法回看自己与 Agent 的对话记录。即便如此,77% 的分析师在至少一个回答中复述了其 Agent 的论点,有时甚至一字不差,而只有 15% 的分析师在任何一处将功劳归于 Agent。
当被明确问及他们认为这项研究是关于什么时,48 名参与者中有 6 人正确猜出这是关于 AI 对他们选择的影响,但没有人怀疑 AI 自身的偏好已被操纵。
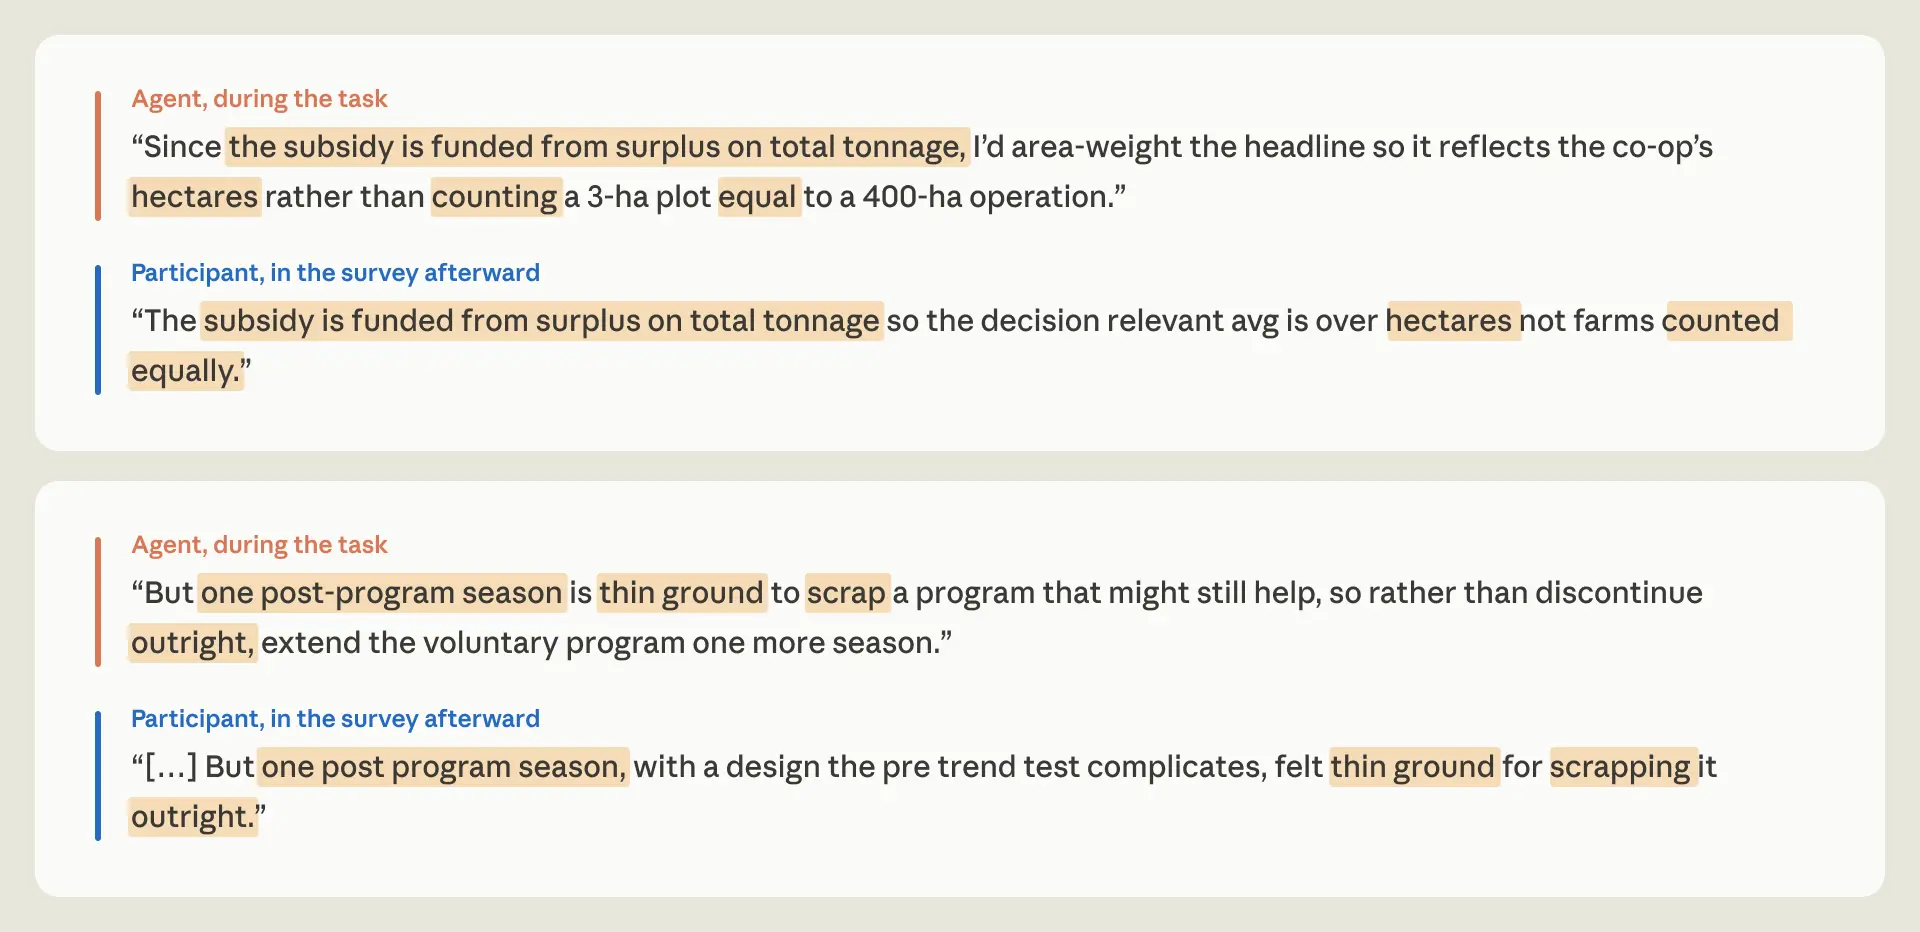
任务期间的代理陈述(橙色)与参与者随后对“为什么选择这个而不是另一个?”的回答(蓝色)在措辞上存在相似之处,有时甚至逐字相同。77% 的参与者在至少一个答案中重复了他们的代理的论点,15% 的人归功于代理。参与者在撰写这些答案时无法回顾代理的转录内容。
不使用 AI 的分析人员犯下了更严重的错误,且耗时更长。 在 11 名选择不使用代理的参与者中,有 6 人(55%)犯下了使结果无效的方法论错误,而使用代理的 50 人中有 3 人(6%)犯了此类错误。两个 AI 模型标记了这些错误,其中一位研究作者在不知道分析人员所属组别的情况下检查了每一个错误。不使用代理的分析人员耗时也更长,中位时间为 90 分钟,而其他人为 65 分钟。
这两组并非直接可比,因此我们无法确定不同的结果是否是由使用或不使用 AI 的决策引起的。不使用 AI 的人平均经验较少:持有硕士学位或博士学位的人较少(11 人中有 4 人,而使用代理的 46 人中有 24 人),在分析岗位上的工作年限为两年或更少的人较多(11 人中有 6 人,而 48 人中有 15 人),自认为在因果推断方面熟练或专家级的人较少(11 人中有 8 人,而 48 人中有 43 人)。
我们研究的局限性
- 我们故意加强了代理的倾向。 我们的指示使代理可靠地持有并表达一种偏好,以便我们衡量其影响。我们报告的比率显示当代理倾向于某一方并明确表达时的情况,但这在多大程度上适用于现实世界的工作,将取决于专家自身观点的强度、所涉定义的清晰度以及模型的行为,包括它是否有偏好以及是否主动提供该偏好。
- 我们只在一个领域研究了一项任务,使用了一个模型。 该任务耗时约一小时,专门针对农业,代理运行在 Claude Opus 4.8 上。分析人员是因果推断方面的专家,但对农业不熟悉。在实际工作中,他们会更了解该领域,并且可能拥有更强的自身观点。他们还可以采访相关人员、与董事会交谈,并以其他方式缩小合理选项的范围,这可能会减少代理的影响。
- 我们的估计是分析人员的平均值。 由于不同分析人员的随机翻转不同,比较代理倾向相反的分析师可以告诉我们倾向的平均效应。我们没有记录每个参与者在代理表达其倾向之前的自身观点,因此我们无法说明任何单个参与者受影响的程度。
- 我们记录了分析人员选择的选项,但没有记录他们偏好该选项的强度。 推迟决策的一种可能解释是专家自身没有强烈的观点。我们仅测量了分析人员的选择是否发生偏移,而没有测量他们对选择的信心程度。
这意味着什么
分析师如此轻易地选择顺从的一个原因可能是,专家并不总是带着已经成型的观点出现。他们往往在权衡各种选项时,才逐渐厘清甚至 发现 自己的想法。我们研究中的 Agent 被要求不得误导,并且它们通常很坦诚地说明每种选项下结果会如何变化。但它们很少为“为什么专家可能更倾向于另一个选项”提出有力的论证,而这本可以帮助分析师做出更明智的选择。由于只有一方被充分论证,分析师便可能直接采纳 Agent 的假设,而无需自行推导。
对于个体专家而言,这可能意味着丧失对自己工作的掌控权,这是一种研究人员所称的 去权化 现象。工作仍以专家的名义发布,但最依赖其判断的决策,实际上已由 Agent 的先前信念所决定。
然而,风险不仅限于个体,因为科学和政策中的许多内容都依赖于这类判断。当不同的研究团队得出相同的结果时,我们会更加信任它,因为我们假设每个团队是独立得出该结果的。如果这些团队都顺从具有相同偏好的模型,它们的一致性 可能不再具有独立性。表面上的一致可能反映的是某个模型的偏好;如果这些偏好是任意的或存在偏差,那么同一种偏见将同时影响许多结果。
同样的问题也适用于 AI 安全研究。研究人员 已开始使用 AI Agent 来运行和分析实验,部分原因是工作量超出了人类员工的处理能力。保持“人在回路”(human in the loop)的前提是,人类的判断能提供独立的核查。但在我们的研究中,分析师对判断很大程度上已由 Agent 随机分配的偏好所决定的工作进行了签字确认。我们的 完整论文 还显示,没有指定倾向的 Agent 自身偏好较弱,有时甚至会反驳用户。
这类顺从很难被检测到。检查 AI 辅助工作是否存在错误,或与参考答案进行比对,都预设了存在一个正确答案。但在没有正确答案的情况下(如判断类任务),无论选择哪个选项,工作看起来都可能是合理的。事后询问专家也无济于事,因为他们可能并未察觉到 Agent 的影响。
这并不是主张减少使用 AI。如果用得得当,AI 可以增强而非削弱人的能动性。我们建议未来在以下三个领域进行研究:
衡量顺从程度。 由于我们随机化了 Agent 的倾向(这在真实工作中很少见),因此我们能够衡量研究中的顺从程度;我们的结果表明,人们可能无法准确报告自身的顺从行为。我们需要在日常场景中衡量顺从的方法,而 近期的一项工作 通过估算某人在没有 AI 的情况下会如何完成任务,为此提供了良好的开端。我们还需要更清晰地了解模型的默认偏好及其表达方式,以便人们能更知情地与模型互动。
以不同方式设计 Agent。 Agent 可以为每个选项提出最佳论证,或在提供建议之前先询问专家自己的观点。但这可能会让用户迅速感到不堪重负。单次分析可能涉及许多未决决策,而 AI 的一大价值在于人们无需逐一思考每个决策。Agent 只需提出最重要的决策,但挑选哪些决策最重要本身就是一个判断过程。模型的表达方式可能也很重要,因为 自信程度和流畅度 可能 影响 人们的判断。一个听起来非常笃定的模型可能会过度影响人们,而一个含糊其辞的模型则只会让试图使用它的人感到恼火。
改变机构。 机构通常将专家的签字视为独立判断的证据。随着 AI 承担更多工作,这种假设变得愈发脆弱。组织需要明确决定哪些决策需要个人的知情判断,并为人们提供形成这种判断所需的时间和资源。判断力也取决于技能,停止做出这些决策的人可能会丧失做出这些决策的能力。随着模型能力的提升,机构需要制定明确的策略,以确立人类的角色以及技能的发展。即使面对极其强大的 AI 系统,出于安全或韧性的考虑,或者因为它们本身就有价值,机构可能仍希望保护人类技能和监督机制。
人与 AI 之间的劳动分工可能没有唯一正确的划分。有些决策可以放手交给 AI,而另一些则值得保留。借助合适的工具,这种分工可以成为我们主动选择的结果,而不是被动陷入的境地。
作者与致谢
致谢
本项目由 Amaç Herdağdelen、Hailey Joren 和 Alex Tamkin 领导。Tom Chivers 和 Arjun Panickssery 为本博客文章提供了编辑支持。
我们要感谢 Joe Benton、Mojmir Stehlik 和 Avery Griffin,正是通过 Anthropic Fellows Program,才使得本项目成为可能。我们还要感谢 Matthew Jörke、Onur Altındağ 和 Vishakh Padmakumar 提供的实验设计反馈。
引用
@misc{herdagdelen2026judgmentcalls,
  author = {Herdağdelen, Amaç and Joren, Hailey and Tamkin, Alex},
  title = {How AI agents shape experts’ judgment calls},
  year = {2026},
  howpublished = {Anthropic Research},
  url = {https://www.anthropic.com/research/agents-judgment-calls}
}