Glimpse:专门理解图片和视频,还能为机器人规划任务的 AI 模型
原文链接: https://elorian.ai/blog/introducing-glimpse 来源: Elorian / Andrew Dai 发现于: 小互 · AI 解读站 · 2026/10/18 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
一瞥,是观看的起点。当模型知道什么值得再看一眼,理解便由此开始。
Glimpse 是一种全新类别的视觉思考模型:一个能够基于所见对物理世界进行推理的系统。Glimpse 可以追踪运动中的物体、适应不断变化的视角,理解各部件如何组合在一起,并将观察与接下来会发生的事情关联起来。这种理解能力在机器人、科学发现和创意产业中至关重要。
与现有的前沿大型语言模型相比,Glimpse 在将视觉表征融入推理过程本身方面走得最远。它可以在视觉空间中进行推理,随着思考的展开不断回顾并细化内部视觉表征,同时也更 grounded,学会了围绕物体及其空间关系进行推理。作为一个 Agent,Glimpse 还经过端到端训练,能够使用编写代码、转换图像和观看视频的多模态工具;Glimpse 还能生成并协调多个 subagent,在它们之间交换文本、视觉产物和内部表征,共同解决一个问题。这些能力结合在一起,使 Glimpse 能够审视问题,并在推理过程中不断修正自己的解读。
在多模态基准测试中,Glimpse 达到了与 GPT-6 Astra 和 Claude Opus 5.5 相当(有时甚至超越)的前沿水平,同时模型规模显著更小、成本显著更低。我们以一个小团队、仅用几百块 GPU 开发了 Glimpse,在一个开放权重的 base model 上完成了 post-training。Glimpse 现已通过 API 和我们的 chat UI 提供。
模型结果
在涵盖科学图表推理、开放词汇计数、短视频 captioning 和操作事件理解的四项评测中,Glimpse 超过了 Astra,并在具身推理上与之持平。这些能力可支撑一系列应用:从分析实验室数据、为社交媒体视频打标签,到识别机器人录像中已完成的动作。
总体而言,Glimpse 在一整套多模态基准测试中都具有竞争力。输入 token 价格为每百万 0.60 美元,输出 token 为每百万 3.00 美元:两种费率分别比 GPT-6 Astra 低 94%,比 Claude Opus 5.5 低 85%,比 GPT-6.1 Sol 低 70%,比 Gemini 3.8 Flash 的首发定价低 20%。
Glimpse 之所以如此强大,在于它会细致而高密度地审查信息,从中解析出最有助于做出可靠推理决策的内容。如此仔细地观察需要时间,也需要 token。token 效率是我们接下来的最高优先级之一;与此同时,我们也在加码投入对最难的视觉推理模型技能的研究。
| 能力 | 评测 | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 输入价格USD / 1M tokens,非缓存 | $0.60 | $10.00 | $2.00 | $4.00 | $0.75首发价 | |
| 输出价格USD / 1M tokens | $3.00 | $50.00 | $10.00 | $20.00 | $3.75首发价 | |
| 机器人 | WGO Bench端到端操作事件 | 42.70 | 39.42 | 38.91 | 12.34 | 33.99 |
| 机器人 | ERQA具身空间推理 · 准确率 | 83.75 | 83.75 | 82.45 | 82.20 | 81.20 |
| 视觉感知 | BabyVision细粒度视觉推理 | 95.36 | 97.68 | 97.16 | — | 83.25 |
| 视觉感知 | HSS场景理解 · 图像 + 视频 | 46.36 | 53.6 | 46.6 | 49.81 | 41.6 |
| 科学推理 | CharXiv-R科学图表推理 | 92.90 | 92.10 | 92.60 | 93.40 | 91.80 |
| 视频 captioning | UGC-VideoCap短视频 captioning | 82.66 | 80.32 | 80.41 | 76.35 | 78.33 |
| 视频 captioning | DREAM-1K稠密视频 captioning | 76.04 | 79.05 | 77.93 | 72.05 | 70.00 |
| 时序推理 | TOMATO细粒度时序推理 | 93.60 | 96.02 | 89.02 | 72.44 | 83.02 |
| 时序推理 | Video-MME v2 with subtitles分组 rubric 得分 | 56.68 | 64.06 | 65.27 | — | 59.58 |
| 时序推理 | E.T. Bench事件理解 | 63.55 | — | 59.79 | — | 63.45 |
| 计数 | FSC-147开放词汇计数 | 83.36 | 82.02 | 82.69 | 73.78 | 67.06 |
| 计数 | CountQA商品图像计数 | 82.66 | 86.42 | 86.42 | 82.20 | 81.09 |
除非另有说明,所有模型结果均使用最高思考强度和原生 Agent 框架:Glimpse max;GPT-6 Astra max + Code Interpreter;GPT-6.1 Sol max + Code Interpreter;Opus 5.5 max + Code Interpreter;图像任务使用 Gemini 3.8 Flash high + Code Interpreter,视频任务使用 Gemini 3.8 Flash high + Video Agent。对于视频评测,GPT-6.1 Sol 和 Opus 5.5 使用 high + Code Interpreter,但 Sol Video-MME v2 例外,使用 max + Code Interpreter;其他视频评测无法提供 max 强度的结果。HSS 包括论文报告的结果。
视觉思考改变了什么
以下示例展示了视觉思考的不同模态——从跟随一个事件,到基于物理规律预测结果,再到将动作与其效果关联起来,以及精确计数物体。这些成功的示例旨在让你初步了解简单的视觉思考模式是什么样的,以及它们如何比单纯的文本推理更高效、更准确地捕获推理链。当你与 Glimpse 对话时,我们的平台会展示模型推理时的视觉草稿空间:它会放大某个区域,以更密集的帧率观看一段短时间间隔,或跨时间追踪某个特征——而你也将开始建立直觉,理解视觉思考能够解锁哪些类型的问题。
- 01 · 跟随世界随时间变化
跟随事件本身,而非帧的样本
跟随一列减速的火车
速度变化。 一段真实源片段和 正确的模型输出:跨时间跟随一个特征,比较位移,并在火车临近停止时验证趋势。
“火车的速度呈现什么规律?”
- 恒定速度。
- 完全静止。
- 减速。
- 加速。
C. 减速。
- 定位 火车在约 2.2 秒时 进入画面;使用同一个可见车窗边缘作为参考点。
- 比较 从 2.2–3.0 秒, 参考点在相邻观测之间移动了较大距离,并带有明显的运动模糊。
- 重看 从 4.5–4.9 秒位移 急剧收缩;从 4.9–5.13 秒它仅移动几个像素。
- 回答 在相等时间间隔内, 火车进站时每段的移动距离递减。
已记录的模型输出。时间戳、观测到的 位移规律和答案均予以保留;证据轨迹为发布需要而作了精简。
在镜头运动中跟随两只鸟
运动中的身份保持。 一段真实片段和 轨迹:区分两只鸟,检验剪辑假设,并在镜头移动过程中还原事件序列。
“完整描述这段视频,包括 主体、动作、时序、镜头结构以及不确定的细节。”
任务摘要 · 要求的回答:一段开放式的、 详细的视频描述。描述两只鸟的动作及其先后顺序, 包括镜头移动期间发生了什么。未提供候选答案。
0.00–1.75 飞行并盘旋 → 1.75–4.00 栖息并 鸣叫 → 4.00–5.10 在连续横摇镜头中起飞 → 5.10–6.13 进入 发光的拱门
- 概览 覆盖全部 6.13 秒, 然后以 8 fps 观看:两只蓝色的鸟围绕一个黄铜门把手盘旋、 降落、面对面,然后向左起飞。
- 检查 放大 2.4–4.0 秒:两双脚都抓住手柄杆;领头的鸟带有 一条洋红色绑带,第二只戴着淡绿色的头部覆盖物。
- 判定 以接近 14 fps 重看 4.3–5.2 秒。墙壁的中间位置表明这是一次连续横摇,而非硬切。
- 验证 在 5.25–6.05 秒,第一只鸟进入 被照亮的拱门;第二只在门槛处短暂停留,随后跟进。在最终采样帧中,两只鸟均保持可见。
已录制的评测运行。发布的 trace 保留了模型的时间戳、cut 与 pan 两种竞争性假设、定向回看以及最终的事件排序,同时压缩了冗长的 caption。
上面两段已录制的 trace 展示了两种消解不确定性的方式:跨时间跟踪一个稳定特征来判断速度,或者以更密集的采样率重新审视一段短暂而模糊的过渡。在第二段 trace 中,模型从 8 fps 的检查移动到约 14 fps,以区分 pan 与 cut 的那 0.9 秒区间。额外的检查集中在决定答案的时刻上。
在 train 视频片段中,模型沿着一条窗框边缘,从约 2.2 秒时火车进入一直追踪到 5.13 秒时接近停止。该边缘在相邻观测之间移动的距离逐渐变小。在 bird 视频片段中,当两只鸟离开门把手时相机发生摆动;模型检查中间墙壁的位置,以判断镜头是否在移动中保持连续。
- 02 · 预测接下来会发生什么
如果把手打滑会发生什么?
读取接触状态,预测后果
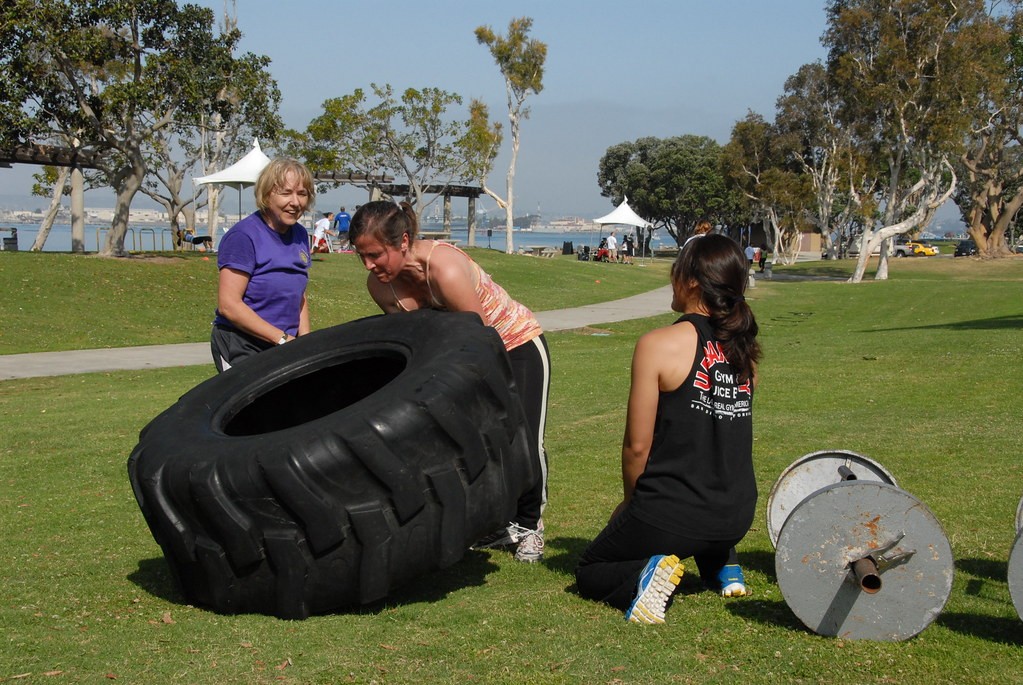
物理后果。 识别支撑物,找到支点,并考虑谁处于下落边缘的路径上。
“如果条纹上衣的女性在轮胎立起之前突然失去抓握,哪位女性最有可能立即被击中,轮胎会如何运动从而产生这种风险?”
必需回答:识别哪位女性处于危险中,并解释轮胎将如何朝她运动。这是一个开放式问题,没有提供备选答案。
最直接的危险:条纹上衣的女性。
- 定位 轮胎的下边缘仍然接触草地;其抬起的一侧尚未越过直立平衡点。
- 建模 如果支撑消失,重力会使抬起的一侧绕着接地的边缘向下旋转。
- 推演 回落的边缘将扫向条纹上衣的女性,而她正俯身于抬起的一侧。
原始照片及经审阅的参考答案。该解释识别了可见的支撑物和推演出的运动;它不是录制的仿真或模型 trace。
经审阅的参考答案跟随轮胎的运动:接地的边缘充当支点,重力使抬起的边缘回落向条纹上衣的女性。她的位置使她最直接地处于其路径上。这是基于照片的定性预测;没有仿真任何轨迹或冲击力。
三位女性正在抬起一个拖拉机轮胎。其下边缘停在草地上,而条纹上衣的女性俯身于抬起的边缘上。问题是:如果她在轮胎到达直立位置之前失去抓握,会发生什么。
- 03 · 理解因果
将动作与其改变的结果联系起来
动作改变路径
从运动到机制。 操作员移动操纵杆;相连的道岔改变位置。该视频片段和参考答案说明了这个动作的效果。直接的动作生成仍是未来工作。
“当女性把圆形铁轨从右移到左时发生了什么?”
必需回答:解释移动道岔的物理效果。这是一个开放式问题,没有提供备选答案。
道岔改变尖轨的方向。
- 定位 找到操作员以及机车旁边的道岔机构。
- 跟随 在源视频片段的第 15–20 秒,她将道岔手柄从身体一侧移动到另一侧。
- 连接 该动作重新调整道岔尖轨的位置:可见的手部动作改变了铁路的实际路径。
原始视频素材与经过审核的参考答案,而非记录的 Glimpse 轨迹或生成的控制序列。此节选涵盖源视频第 12–26 秒。
对机器人视频的检查记录在时间上做出了一个相关区分:从容器中取出标记物在 8.9 秒结束;将其放到桌上并松开在 14.085 秒结束。其输出包含这两个已完成的事件。我们正在开发直接动作输出,作为利用此类场景理解来控制机器人的下一步。
在铁路源视频片段的第 15–20 秒,操作员将道岔手柄从她的右侧拉到左侧。该手柄与道岔尖轨相连。经过审核的参考答案遵循了这一连接:移动手柄会改变尖轨的位置以及通过轨道的路径。
- 04 · 精准观察
数对正确的物体
数出张开的钳子
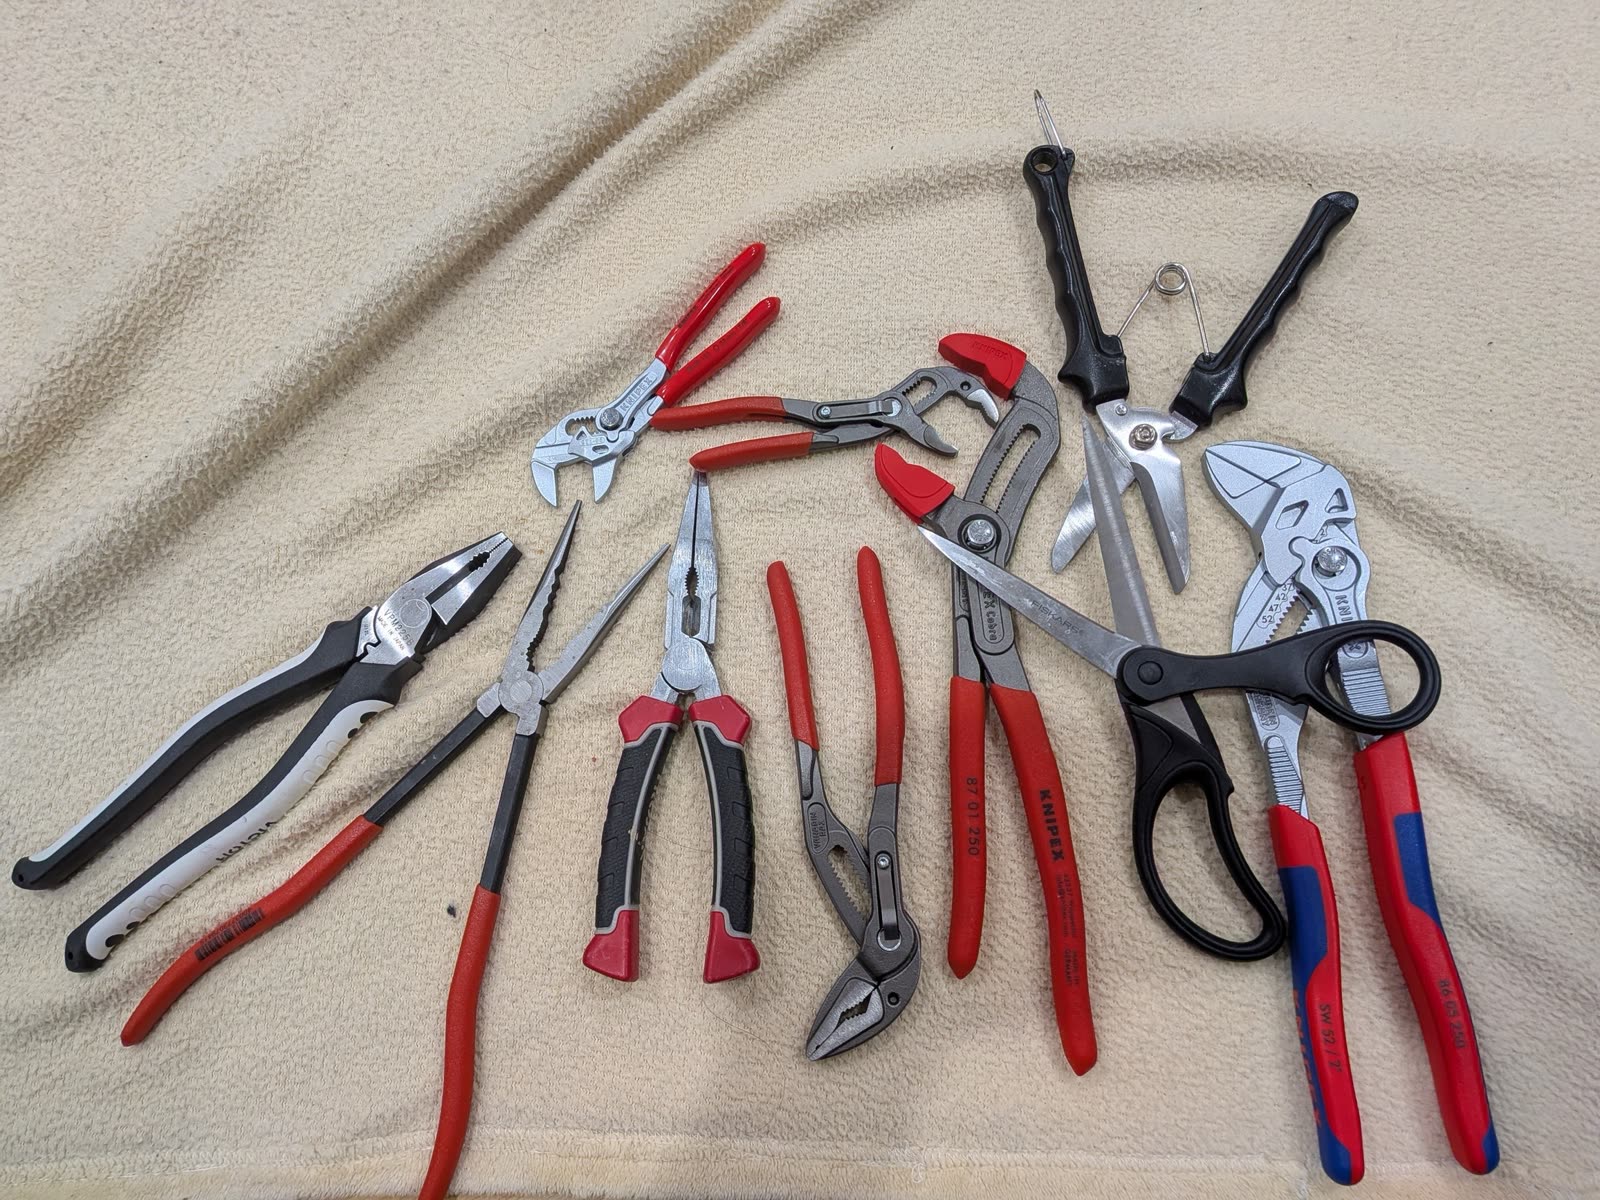
按类别与状态计数。 一张原始照片暴露了普通计数所掩盖的失败:目标类别本身很简单,但其状态和外观相似物必须保持区分。
“有多少把张开的钳子?返回一个整数。”
要求答案:一个整数。只数张开的钳子;没有多选题选项。
4
- 定义 目标不是每一件手动工具,也不是每一把钳子,而是手柄和钳口明显张开的钳子。
- 区分 闭合的钳子是类别匹配但状态错误;剪刀是外观相似但类别错误。
- 验证 在将其计入之前,对照两项约束——工具类别和张开状态——重新审视每个候选对象。
- 参考 经过审核的参考计数为四。
原始照片与经过审核的参考答案。这些步骤解释了任务中的视觉区分;它们并非记录的模型轨迹。
在上面的照片中,问题要求找出张开的钳子。一把闭合的钳子具有正确的工具形状,但不符合条件;剪刀有两个手柄和一个铰链,但属于不同的类别。逐一检查每个候选对象的手柄和钳口,得到经过审核的参考计数:四。
计数是一种基础感知能力:识别场景中物体的集合。在一堆密集的物体中,这意味着将相邻物体彼此分开、将它们与外观相似物区分开,并检查哪些物体满足问题的标准。
Glimpse 能做什么
上面的完整示例展示了视觉思维在理论上如何运作。下面的示例则展示 Glimpse 在实践中如何应用于一系列真实任务:从机器人领域(用于训练的合成数据生成、为 VLA 模型提供 System 2 规划),到短视频的密集描述(dense captioning),再到对院子里的一群小狗或建筑工地上的设备进行精确的视频计数,以及可靠地解决简单的视觉推理谜题——这些谜题连孩子都能完成,却已被证明对当今许多前沿模型极具挑战性。
面向机器人的基础模型 — 从合成数据生成到高层规划
遥操作数据的标注与分段
Glimpse 为每张静帧中的物体命名并画出边界框,并将 episode 分割为六个 pick-and-place 事件,每个事件都有各自的时间戳:这正是机器人学习数据集所需要的标注。
规划并检查 VLA 模型的工作
Glimpse 与 GPT-6 Astra 各自在同一个 LIBERO 任务上为同一个机器人 policy 进行规划。
在被要求“把奶油芝士放进碗里,然后把碗放到柜子顶上”时,每个模型都为同一个 vision-language-action policy 担任规划器——即来自 Physical Intelligence 的 π0.5。规划器将请求拆解为若干步骤,在机械臂工作期间查看机器人的摄像头画面,判断每一步何时完成、下一步做什么。两个规划器都完成了任务。Glimpse 的规划成本为每个 episode $0.035;Astra 的成本为 $0.249。
为全世界的视频档案建立映射
聚焦细粒度动作的 dense captioning — 哈瓦那的一场街头表演
一段在哈瓦那拍摄、时长 2 分 46 秒的街头表演,包含 14 个关键事件。每个模型为整段视频生成描述;清单会逐一标注它对每个事件判断的对错。
聚焦社交与情感动态的 dense captioning — 一对情侣与一个打包好的行李袋
一段 16 秒的素材视频片段,包含 13 个关键事件,其中大多数是情绪和意图,而非动作。
在这两段视频中,Glimpse 都能捕捉到 Gemini 3.8 Flash 和 GPT 6.1 Sol 都会遗漏的细粒度视觉细节与微妙推断。
计数 — 从你家的院子到总承包商的场地
计数与追踪 — 每只小狗,只数一次
手持手机拍摄的视频,实时计数。每种颜色代表一只小狗,当镜头摇走又摇回来时,每只小狗仍保留自己的编号。镜头移动之前的前六秒以 4× 速度播放。
在施工现场 — 场地里有多少辆工程车辆?
平台中的 scratch space:当被问到视频里出现了多少辆工程车辆时,Glimpse 逐步过完整段视频,并连同它所依据的时间戳一起返回计数结果。
Elorian 平台中的 Glimpse 会话记录,答案按返回原样展示。
高级视觉推理
视觉谜题 — 迷宫与找不同
两类谜题在三个模型上运行测试:解规模不断增大的迷宫,以及找出两幅画之间的每一处差异。
Humanity's Sixth Sense — 模型能看到接下来会发生什么吗?
从 Humanity's Sixth Sense 中随机抽取的十二道“接下来会发生什么”问题。每个模型看到一张静帧和一个问题,作出回答,并画出它预期的路径;全部十二题的得分见结尾。
每个答案之后播放的动态画面,是由 Seedance 2.5 根据静态图片生成的,用于展示基准测试的参考答案。没有任何模型见过这段动态画面。
迈向理解视觉世界的模型
Glimpse 是 Elorian 希望解锁的能力的一次预览。我们相信,围绕多模态智能从零开始构建覆盖系统、数据、模型架构和训练的完整技术栈,能够解锁物理世界中的 AGI。模型必须能够重建场景、预测物体移动时会发生什么,并利用这种理解来指导下一步行动。除了机器人、工程和国防应用之外,这些能力还可以帮助创作者制作和编辑视频、帮助科技公司搜索和整理在线媒体、帮助游戏开发者构建和测试交互式环境。
我们正通过多模态原生(multimodal-native)预训练、既能理解又能生成的模型,以及面向机器人的直接动作输出,朝着这些目标努力。Glimpse 的视觉理解能力只是早期的第一步;校准重建和机器人控制仍是未来有待完成的工作。
Glimpse 可通过 API 和交互式聊天界面使用。在 Elorian 平台上免费试用 Glimpse。