Google 开源多模态向量模型 EmbeddingGemma 2:用自然语言搜索文字、图片、声音和视频
原文链接: https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/ 来源: Google DeepMind 发现于: 小互 · AI 解读站 · 2026/10/7 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
EmbeddingGemma 2:开放、轻量级的多模态 embedding 模型
2026 年 10 月 6 日
|
EmbeddingGemma 2 是目前最强大的端侧多模态 embedding 模型,可将文本、图像、音频和视频的组合原生映射到统一的 embedding 空间中。
Sahil Dua
Google DeepMind 研究工程师
Henrique Schechter Vera
Google DeepMind 研究工程师
分享
      收听文章

    [[duration]] 分钟

      此内容由 Google AI 生成。Generative AI 尚处于实验阶段
我们去年推出了 EmbeddingGemma,为高质量文本嵌入提供了一个轻量级选择,帮助您的应用直接在消费级硬件上组织、搜索和连接信息。开发者社区的反响远超我们的预期。下载量已超过 2000 万次,开发者们用它构建了更智能的设备端搜索工具和隐私优先的检索增强生成(RAG)管线。
今天,我们正式发布 EmbeddingGemma 2**,** 超越文本范畴,将代码、图像、视频和音频统一到同一个共享嵌入空间中。EmbeddingGemma 2 基于 Gemma 4 架构构建,以商业友好的 Apache 2.0 许可证发布,拥有 7.4 亿参数,非常适合设备端推理。它可以帮助您从语音备忘录中找到特定的视频片段,或根据文本查询搜索数小时的音频录音,这一切都由单一的原生多模态模型处理完成。
EmbeddingGemma 2 基于与 Gemini Embedding 模型相同的技术构建,具有以下特点:
- 同级尺寸中的最佳表现: 在 MTEB(Massive Text Embedding Benchmark)Code 和 MAEB(Massive Audio Embedding Benchmark)等基准测试中,取得了 1B 参数以下多模态嵌入模型中同尺寸领先的分数,同时在文本、视觉和音频任务上与许多更大的模型持平甚至超越。
- 模块化设计: 纯文本工作负载最低仅需 270M 参数,并可通过可选的视觉(170M)和音频(300M)编码器实现完整的多模态支持。
- 存储高效: 借助 Matryoshka Representation Learning (MRL),开发者可以将输出向量从 768 维动态截断至 512、256 或 128 维。这最多可将本地向量数据库和内存占用的存储需求降低 6 倍。
- 针对设备端性能优化: 可在严苛的资源限制下高效运行。经过量化后,在 Google Pixel 11 Pro 上,EmbeddingGemma 2 的纯文本权重仅需约 191MB 活跃 RAM,完整多模态模型约需 567MB。
- 扩展上下文就绪: 配备 8K token 上下文窗口(是 EmbeddingGemma 1 的 4 倍),可直接在本地硬件上处理最长 5.5 分钟的音频、29 张图像、58 个视频帧,或这些内容的交错组合。
在代码、视觉和音频方面实现顶级质量
EmbeddingGemma 2 保持了 EmbeddingGemma 出色的多语言文本性能,同时在代码性能上取得了 9.92 分的显著提升(MTEB Code 从 68.76 提升至 78.68),非常适合本地代码库索引、语义代码搜索和编码 Agent 检索。在图像、视频、文档和音频方面,它为 1B 参数以下模型树立了单位参数质量的新标准,甚至超越了某些规模超过其两倍的专用模型。
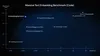
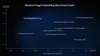
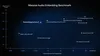
完整的评估指标和模型信息请参见 EmbeddingGemma 2 模型卡片。
在设备端全面实现语义搜索、路由与检索
EmbeddingGemma 2 将强大的能力直接带到边缘硬件上。在本地生成 embeddings 有助于确保数据隐私、降低 pipeline 延迟,并让开发者能够构建完全离线运行的跨模态搜索与检索。
与 Gemma 4 等生成式模型搭配使用时,EmbeddingGemma 2 可以构建能够理解复杂多模态数据的设备端 RAG pipeline。由于 EmbeddingGemma 2 基于 Gemma 4 构建,并共享其 text tokenizer 和 audio encoder,开发者可以在统一的 pipeline 中同时运行这两个模型,合计内存占用更低。
使用文本或图像,基于语义相似度在您的媒体库中查找最匹配的内容。可以在 Google AI Edge Gallery 的 Instant Media Search 中试用。
使用文本或音频查询定位视频中的特定片段。可以在 Google AI Edge Gallery 的 Video Moments Finder 中试用。
将 EmbeddingGemma 2 用于本地文件检索,再结合 Gemma 4 进行上下文推理。可以在 Google AI Edge Foresight 应用中试用。
通过 MediaPipe Decision Task API,利用多模态上下文创建具备分类、路由和预测能力的实时决策引擎。
如需了解如何使用 LiteRT 构建设备端搜索和 RAG 系统,请阅读这篇 Google AI Edge 博客文章。
EmbeddingGemma 2 入门
我们与以下合作伙伴紧密协作,确保 EmbeddingGemma 2 能在您的开发环境中即刻可用:
- 下载模型: 模型权重可在 Hugging Face 和 Kaggle 上获取,Gemini Enterprise Agent Platform Model Garden 也将很快提供支持。请访问 LiteRT Community on Hugging Face 获取针对设备端优化的模型。
- 设备端部署: 使用 Google AI Edge MediaPipe 开箱即用地完成 embedding、检索与决策任务,或使用 LiteRT 进行自定义模型集成,开发跨平台应用。也可以使用 transformers.js 或 WebGPU 构建浏览器端应用。
- 使用您喜爱的开发工具:使用 transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama 和 LMStudio 高效地部署模型。使用 Qdrant 存储您的 embedding 向量。
- 微调: 参照 Unsloth 提供的指南,了解如何针对您的使用场景微调 EmbeddingGemma 2。
发布于: