让 Claude 帮你建 eval、调 prompt,怎么不被分数骗
原文链接: https://claude.dev/blog/automating-eval-design-and-hillclimbing/ 来源: Anthropic 发现于: 小互 · 会员解读 · 2026/9/29 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
评估为你的应用或技能在特定任务上的表现提供了信号。但设计评估,并在不欺骗自己的情况下提升评估表现,是困难的。我们为 claude-api 技能 添加了这两方面的指导。
借助该技能,你可以运行 /claude-api build-eval 在代码库中构建评估,并运行 /claude-api hillclimb 来针对该评估改进你的应用,每次只改动一处,并使用一组留出的示例来防止过拟合。
在本文中,我们首先强调良好评估设计和 hillclimbing 的原则,然后展示 Claude Code 结合 claude-api 技能如何应用这些原则。最后,我们将通过几个命令示例来收尾。
评估设计
设计良好的评估具有几个共同要素(图 1):
- 评估任务反映生产环境。 选择你在“生产环境”(即你正在测试的能力或应用将被使用的场景)中关心的示例任务。有时任务被选中是因为它们易于生成或易于评分。但确保任务分布代表你实际关心的内容至关重要。
- 性能随更强模型和更多思考而提升。 能力更强的模型和更高的努力水平通常应在评估中表现更好。如果并非如此,通常是由于任务模糊或评分器校准不当限制了性能。
- 前沿存在“可达到”的提升空间。 最高努力水平下的最强模型应远低于 100% 的评估分数,否则你无法可靠地判断改动如何影响性能。重要的是,这种差距不应由不可能或模糊的任务来解释:一个常见的迹象是某个任务在每次评估运行中都失败,无论重复次数多少。一个好的任务应该是两位领域专家会得出相同结论,并且评分器检查的所有内容都在任务中明确陈述。
- 运行间方差低。 高方差通常源于设计不当的模糊任务,或对相同输出产生不同结论的评分器。方差也可能隐藏在配置中。例如,努力水平可能未一致应用。此外,环境可能影响评估结果:早期试验留下的状态(文件、git 历史)可能将答案直接交给 agent。
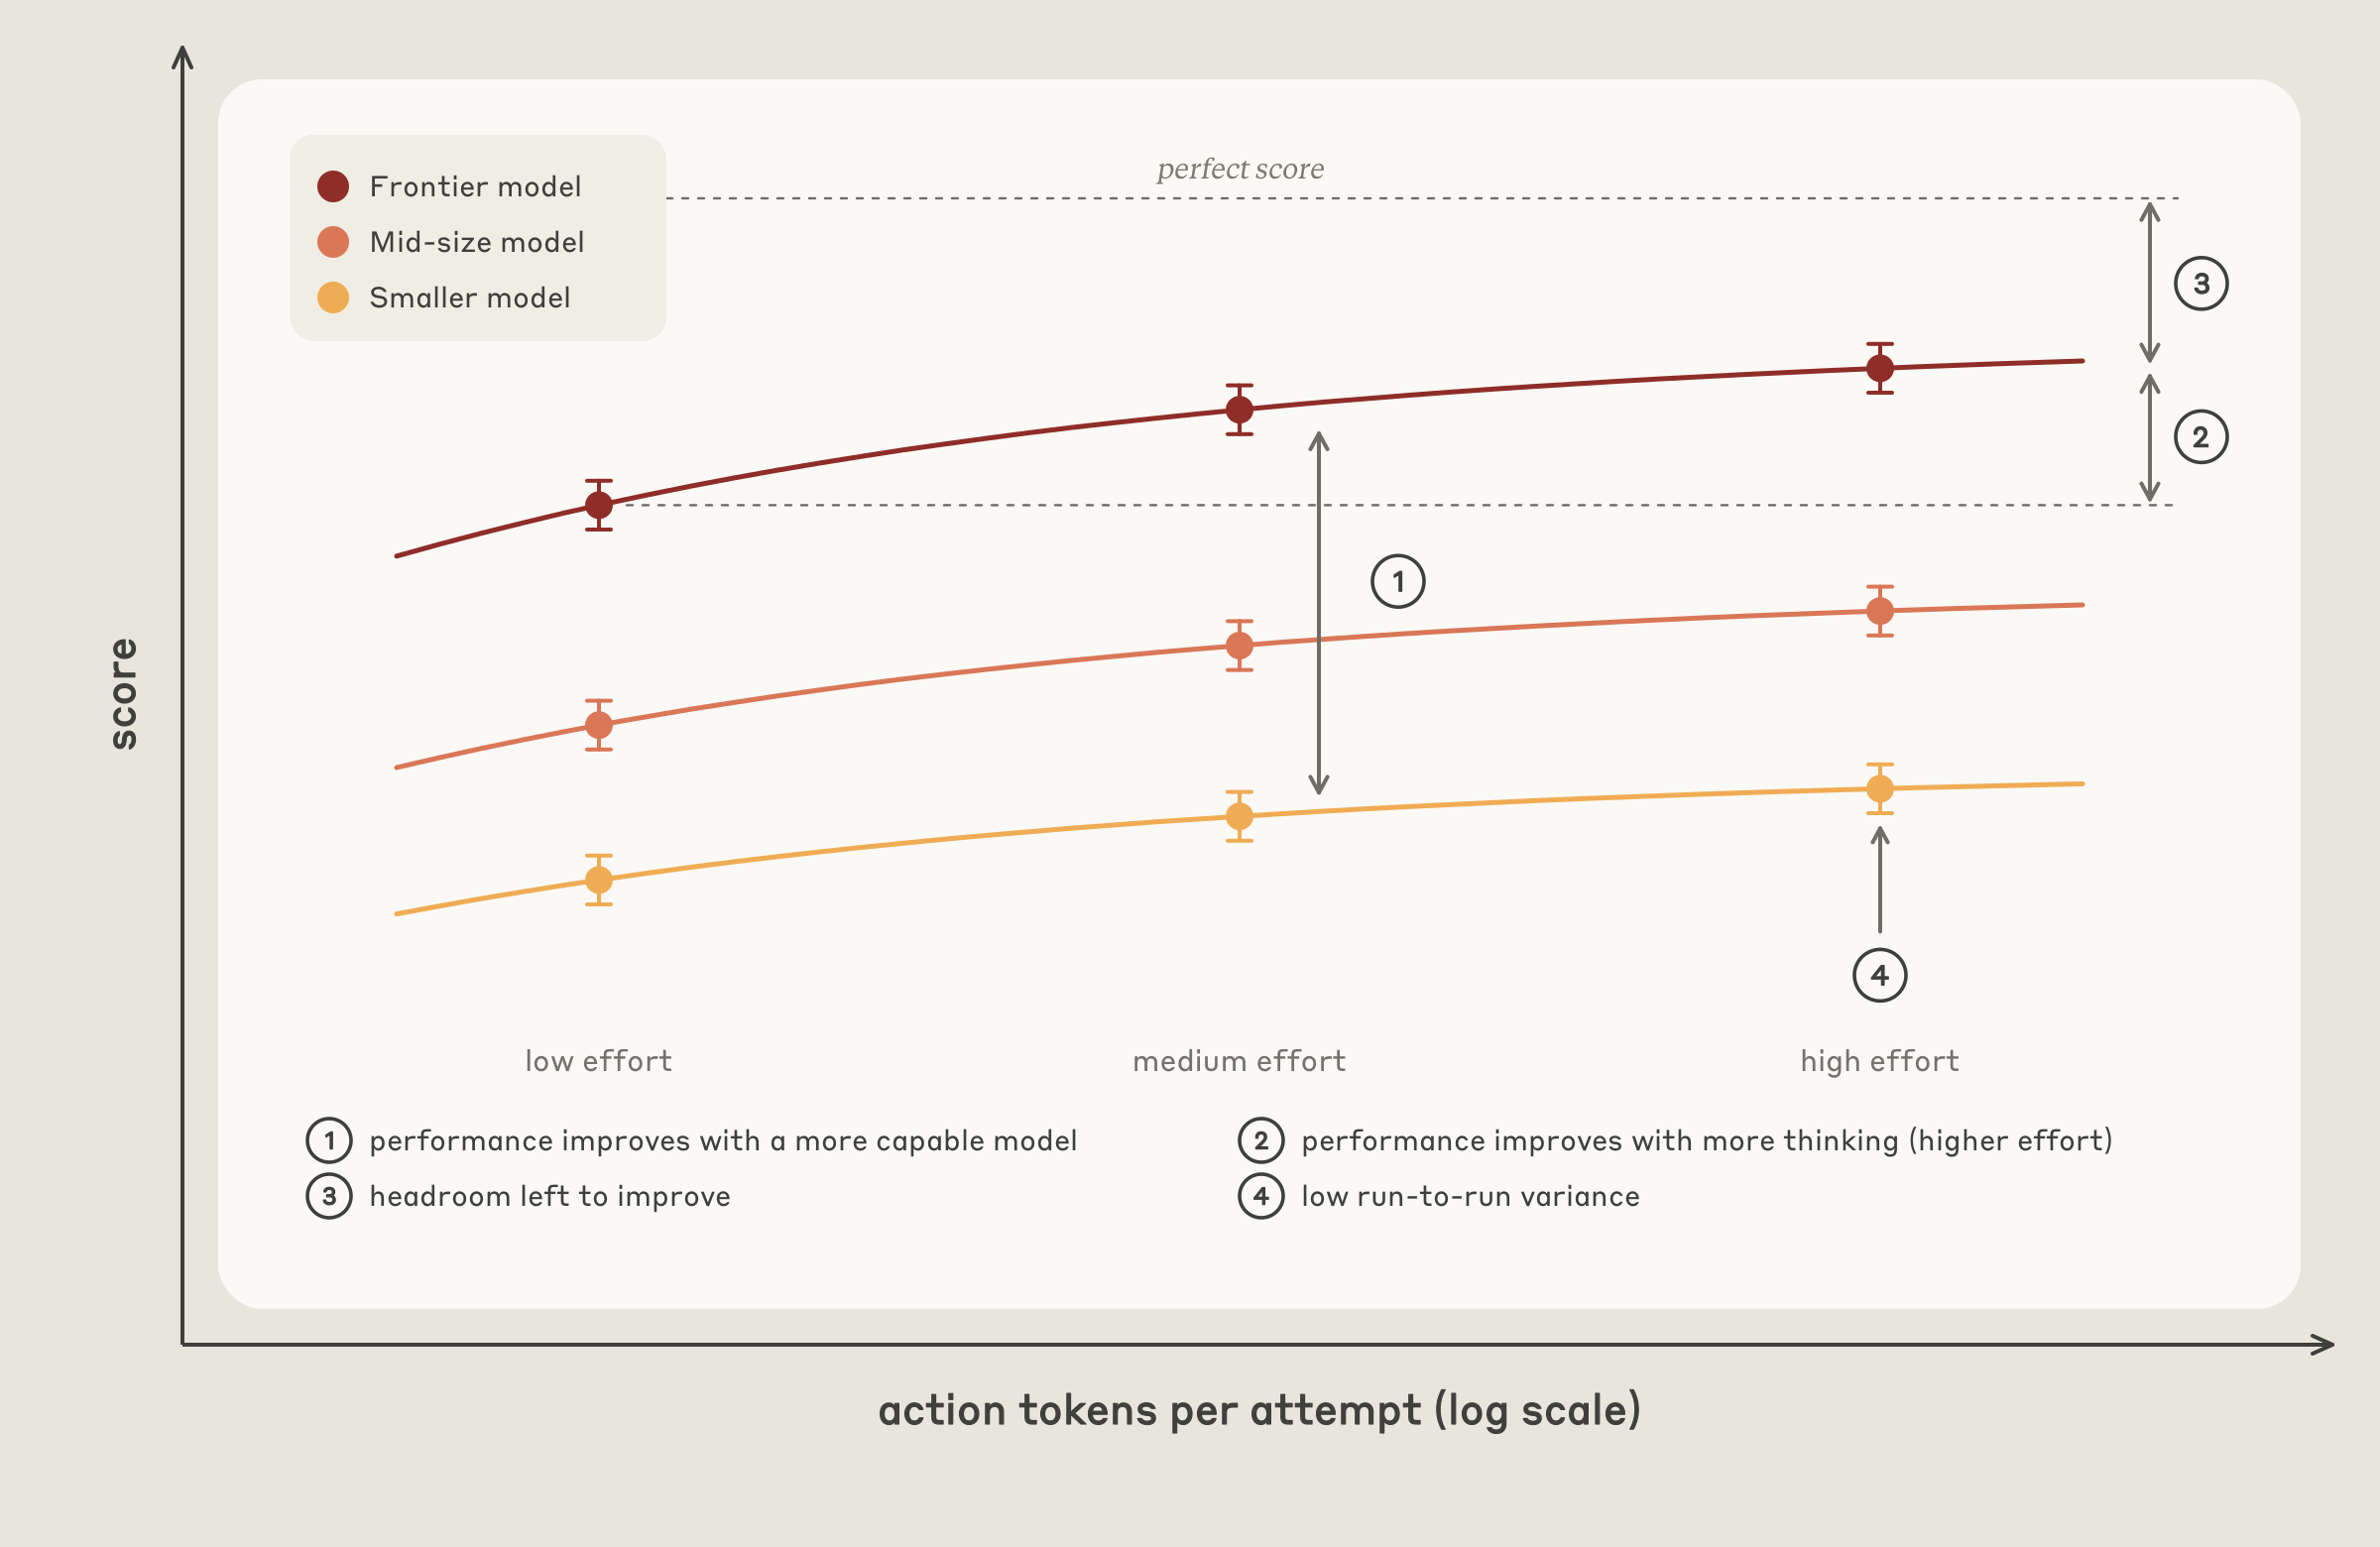
图 1 良好评估的四个要素
对抗性采样
模型能力是参差不齐的。如果你因为今天的模型在某个案例上失败而选择它,那么你就是在采样一个模型能力表面的低谷(图 2)。评估最终可能衡量的是该模型的失败特征,而不是你的应用本质上困难或有价值的事情。
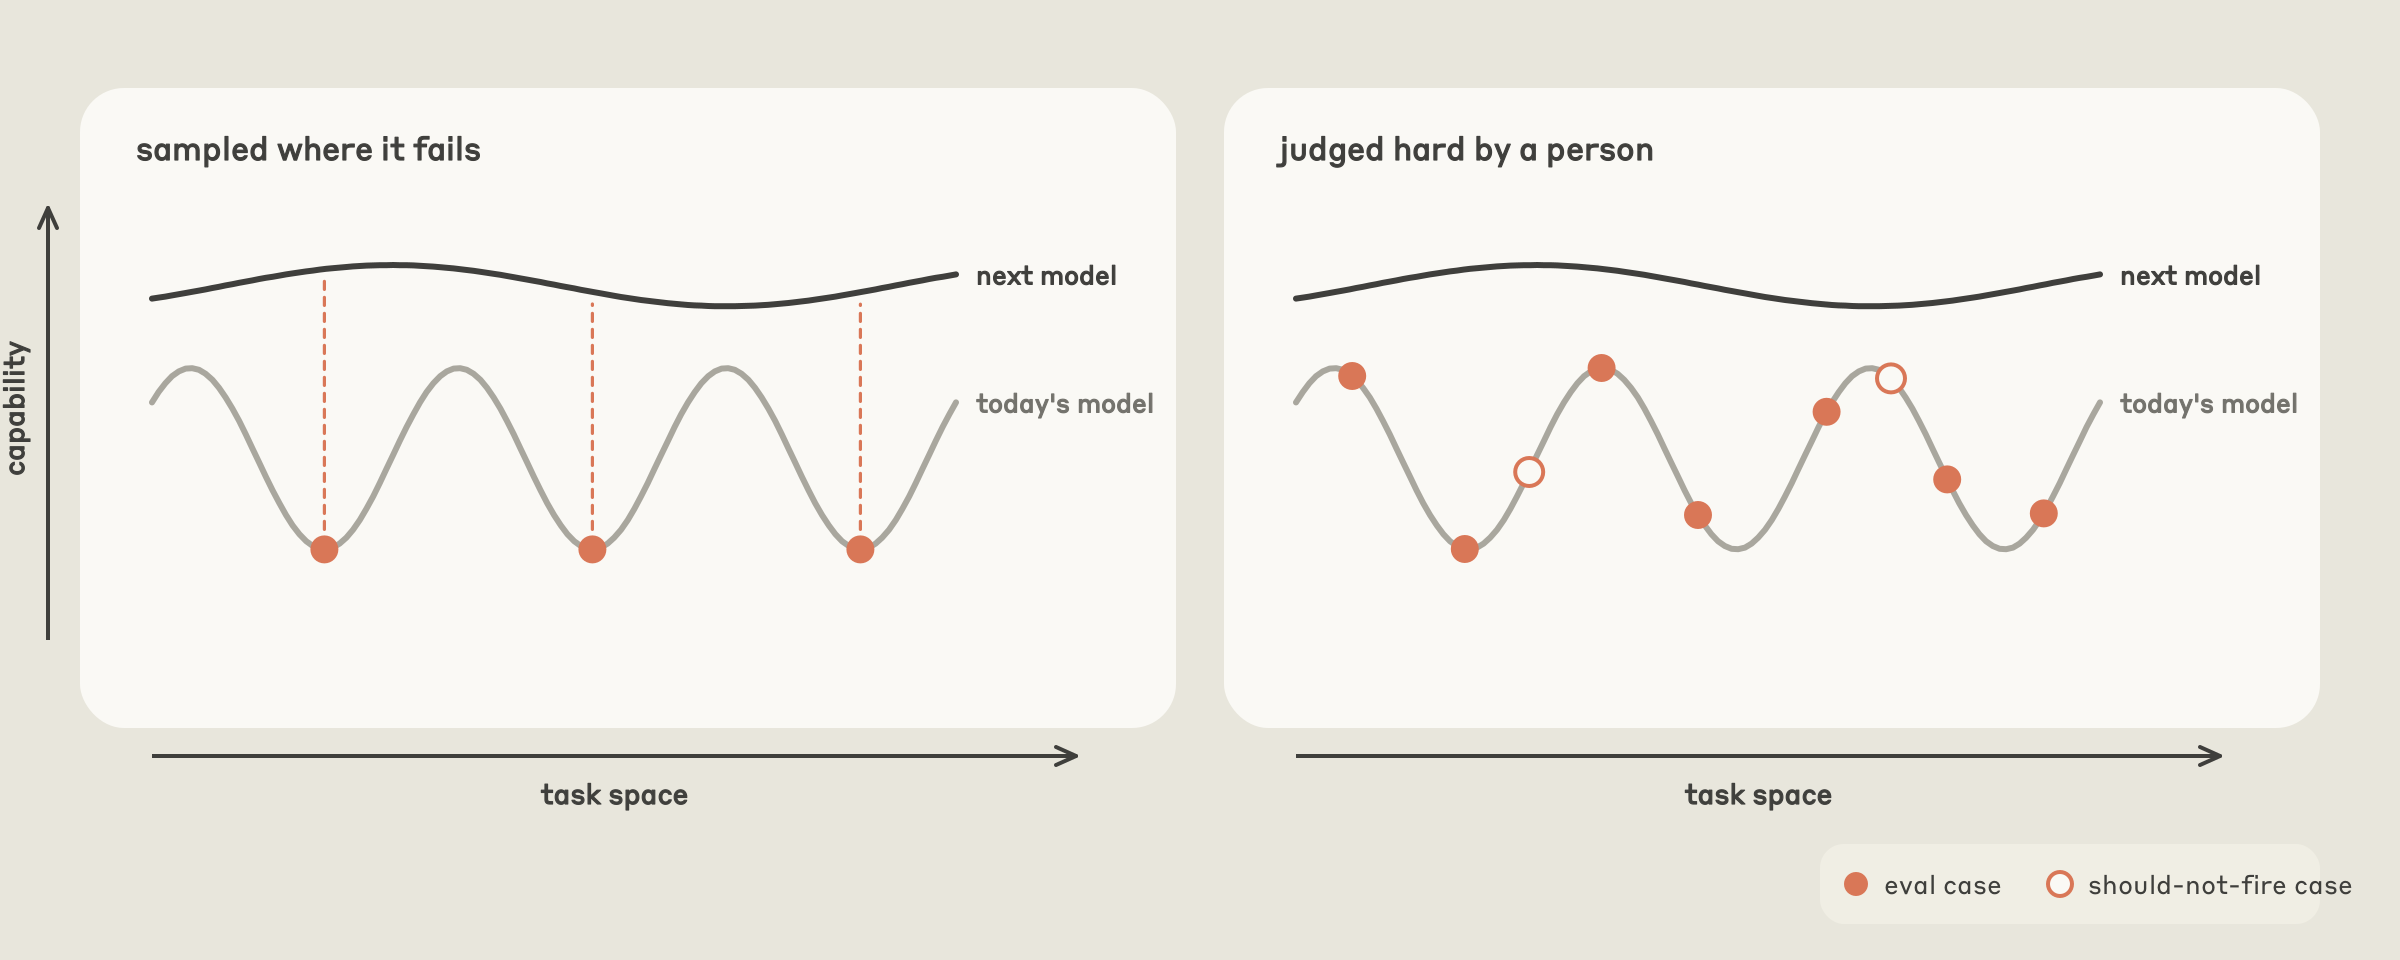
图 2 对抗性采样
选择困难的案例是因为人类判断它们困难:一个有用的测试是,在包含一个案例之前,能够说出它为什么困难。包含来自生产流量、错误报告或工单的、你的应用中具体的失败案例。然而,不要盲目信任用户流量:用户有时会尝试他们预期能成功的事情,因此严格从用户流量中抽取的任务分布可能偏向简单。
/CLAUDE-API BUILD-EVAL
claude-api 技能中的 build-eval 命令将这些原则转化为一个引导式工作流。当你在 Claude Code 中运行 /claude-api build-eval 时,Claude 会对访谈你、在你的代码库中构建评估,并在特定节点暂停等待批准。
设计样例
Claude 帮助你按以下顺序采样输入以构建评估:
- 生产环境对话记录,前提是先询问数据保留期限和敏感数据问题。
- Bug 报告和支持工单。
- 你手工编写的五到十个案例。
- 从你的代码库合成的案例。
该技能优先使用生产流量,但它也可以基于你提供的少量真实示例来生成合成数据。该技能会指示 Claude 生成一个简单页面来展示每一个输入,并等待你确认。作为示例,下面展示了该技能可能要求用户审阅的电子邮件路由应用的输入示例集(图 3)。
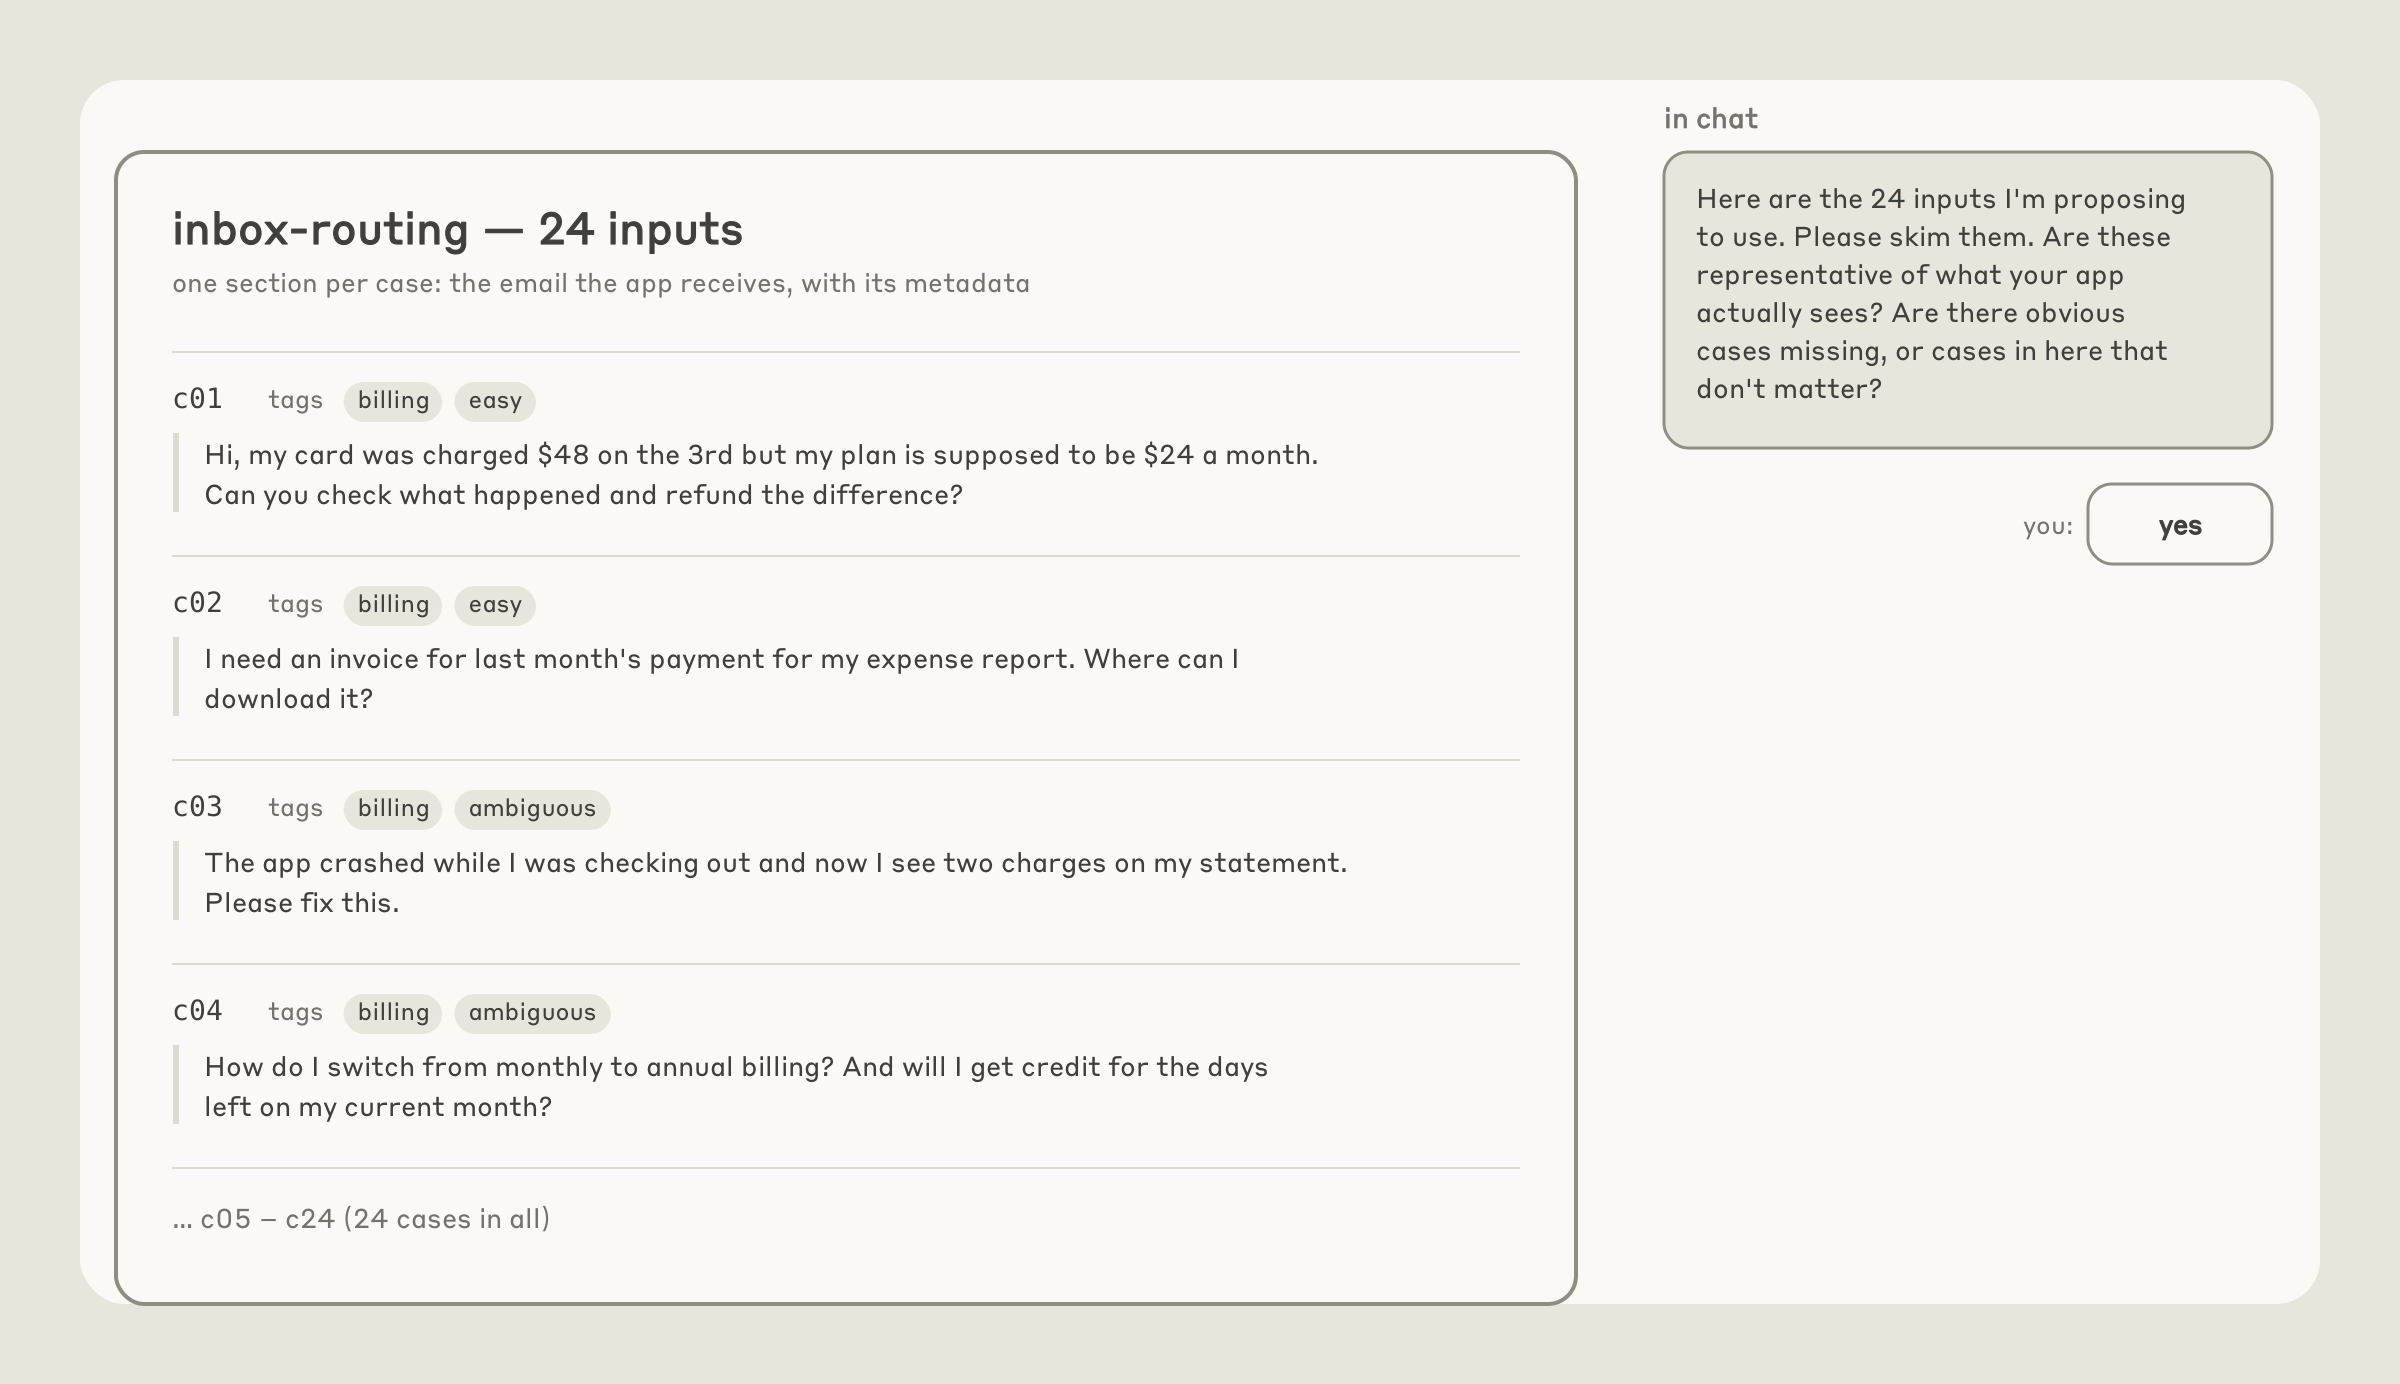
图 3该技能生成的输入示例审阅页面
验证评分器
在输入之后,Claude 会提出最适合你应用输出的最低成本评分器:
- 程序化验证:如果输出的可能性是受限的,它会使用基于代码的检查(精确匹配、来自固定集合的标签、符合 schema 的 JSON、通过的测试)。
- LLM-as-judge:如果输出空间是开放式的,即存在许多有效答案但有明确的质量标准,它会默认使用这种类型的检查。在这种情况下,第二个模型会读取输入、输出以及一份写成可核查声明(而非 1 到 5 分制)的评分细则,并返回分数及其推理过程。如果你有一个可对比的 baseline,评判模型则会以随机顺序读取两个输入,且不被告知哪个是 baseline,并选出更好的那个。评分模型由你选择,但它不应是你正在测试的那个模型。
Claude 会给少量案例评分,并询问你是否会对其中任何一个给出不同的分数(图 4)。总体而言,在相信你的评估器之前,先阅读一部分已评分的对话记录非常重要;评分失败是评估配置错误最常见的原因之一。
在你验证完评分器之后,该技能会告诉你评估集的规模(案例数 × 重复次数 × 模型,以及大约需要多长时间),运行 baseline,并输出带置信区间的分数。你最终得到的是:案例、评分器、运行器、每个案例一行 JSON 以及一份完整对话记录,还有一个纯文本页面列出每个案例的分数并附有其对话记录的链接。如果你想要比该页面展示的更多内容(例如图表),只需提出,Claude 就会在它旁边构建一个额外的页面。默认情况下,这些额外页面是可在本地打开的静态文件,不会从网络加载任何内容。
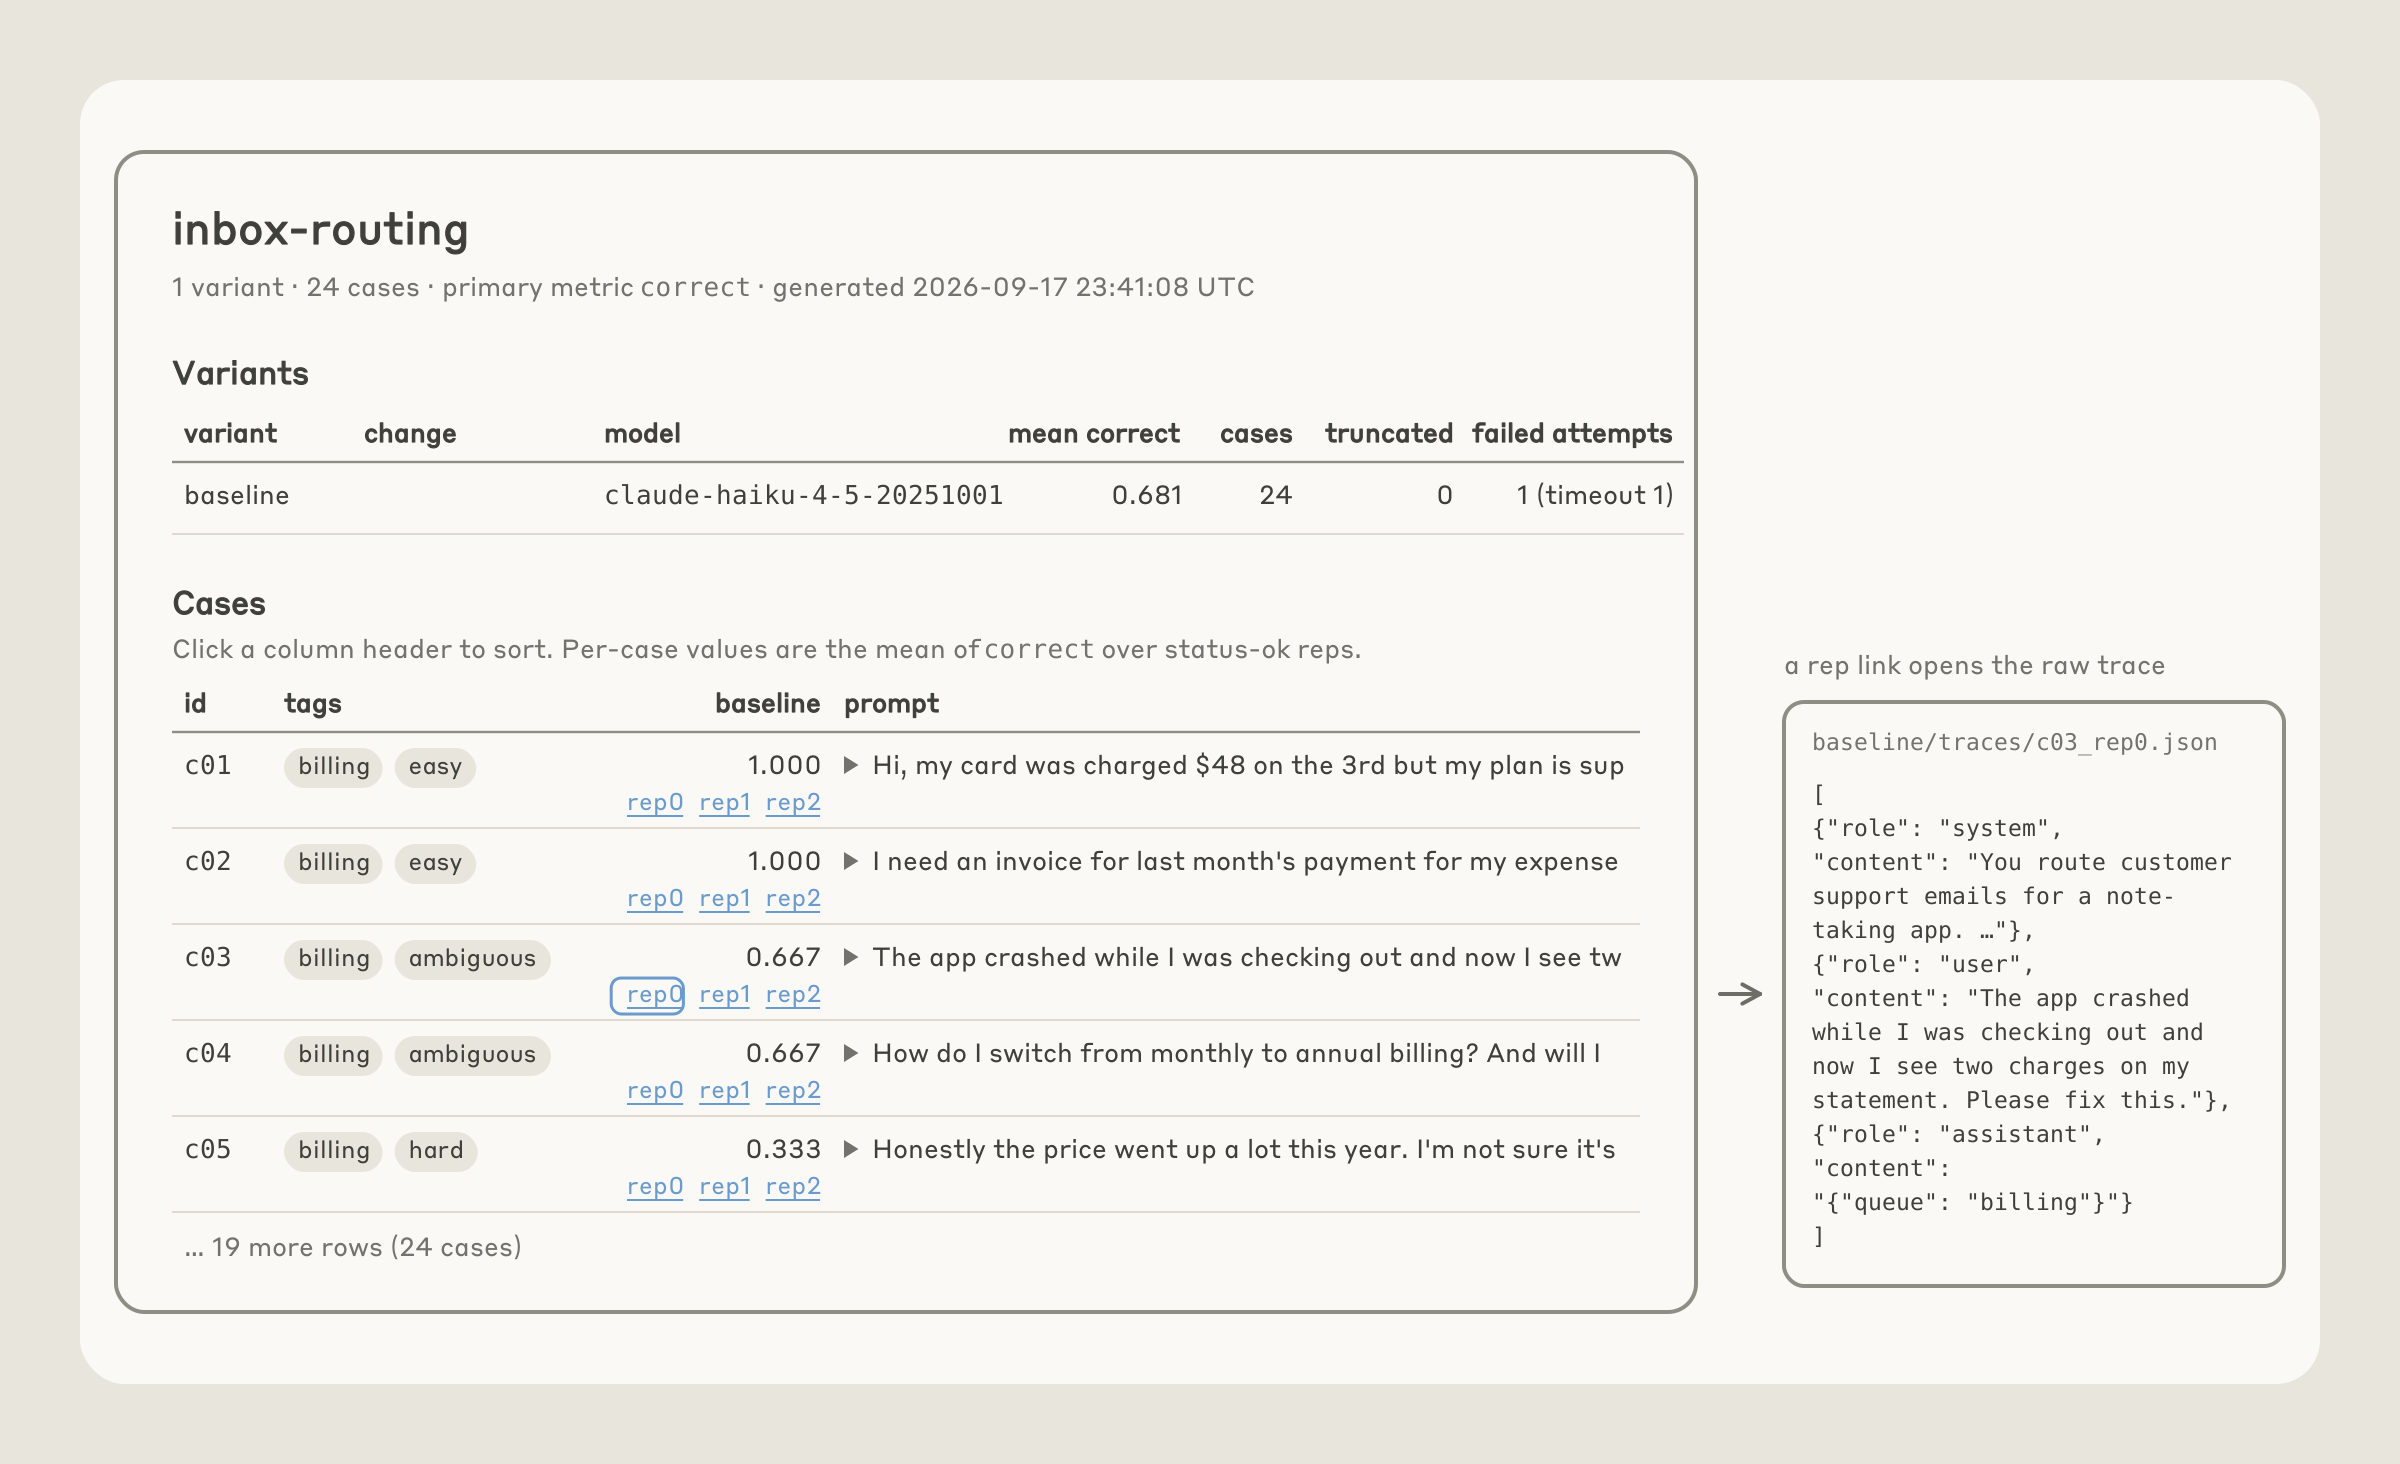
图 4生成的结果页示意图,包含针对每个输入的建议评分。
诊断检查
在上面提到的 baseline 运行过程中,Claude 会检查一系列事项:
- 评分器(Grader):Claude 会对同一输出运行评分器两次,并报告判定结果是否发生了变化。
- 基础设施(Plumbing):Claude 会检查超时、API 错误和被截断的回答,以确保基础设施层面的噪声不会被误认为模型本身的波动。
- 提升空间(Headroom):如果 baseline 的得分已经达到约 95% 或更高,该技能会警告用户,并提示 hillclimb 应该以探索成本或延迟的优化为目标,而非质量。
爬山法(HILLCLIMBING)
现在你已经有了可靠的方法来评估应用在任务上的表现,可以着手改进它了。爬山法(Hillclimbing)是调优 effort 或 prompt 等参数的有效方式,这些参数需要在成本与性能之间进行权衡。以下是选择在何处应用它的一些通用建议:
- 迭代成本低 - 无论你将爬山法聚焦于哪个层面(surface),对其进行修改都应当是廉价的(在时间、成本和精力方面)。许多内部项目和客户都将爬山法聚焦在文本上,例如 prompt 和 skill。这些内容易于修改和回退。相比之下,在爬山法过程中对 agent harness 进行开放式修改可能涉及大量代码变更。
- 可归因 - 评测分数的变化应当可以归因于你在爬山法过程中所修改的层面。例如,多个成功的爬山法应用都聚焦于 skill 触发。其评测指标(该 skill 的触发率)与被修改的 skill 描述直接耦合。
- 目标界定清晰 - 一种常见的失败模式是在未仔细考虑评测剩余提升空间(headroom)的情况下,提出开放式提升性能的请求;接近饱和的评测或界定不佳的层面(例如开放式更新 harness 的请求)更容易陷入停滞。在各类实践中,成本通常是一个强有力的目标:即使评测已经饱和,你仍然可以让 Claude 寻找降低成本的方法,同时保持性能持平。
过拟合(Overfitting)
即使是设计良好的评测,也很少与你所关心的生产环境中的确切任务分布完全匹配。因此,对评测的“过拟合”是一个常见问题,会导致系统在评测上的表现优于在生产流量上的表现。
评测有多种方式可能“泄漏”到你的 harness 中(harness 指围绕模型的代码,包括 prompt、工具以及调用 Claude 的循环)。例如,设想某个评测任务能从 OCR 中获益,但 OCR 在你的生产任务中很少有用。评测 harness 可能会给你的应用添加一个 OCR 工具,从而提升 benchmark 表现,却对生产毫无影响。更广泛地说,爬山法可能会给 harness 添加一些功能,以应对你所选的特定评测示例中的边缘情况。这些 harness 增补能提升你的评测分数,却无法转化为生产环境的改进(图 5)。
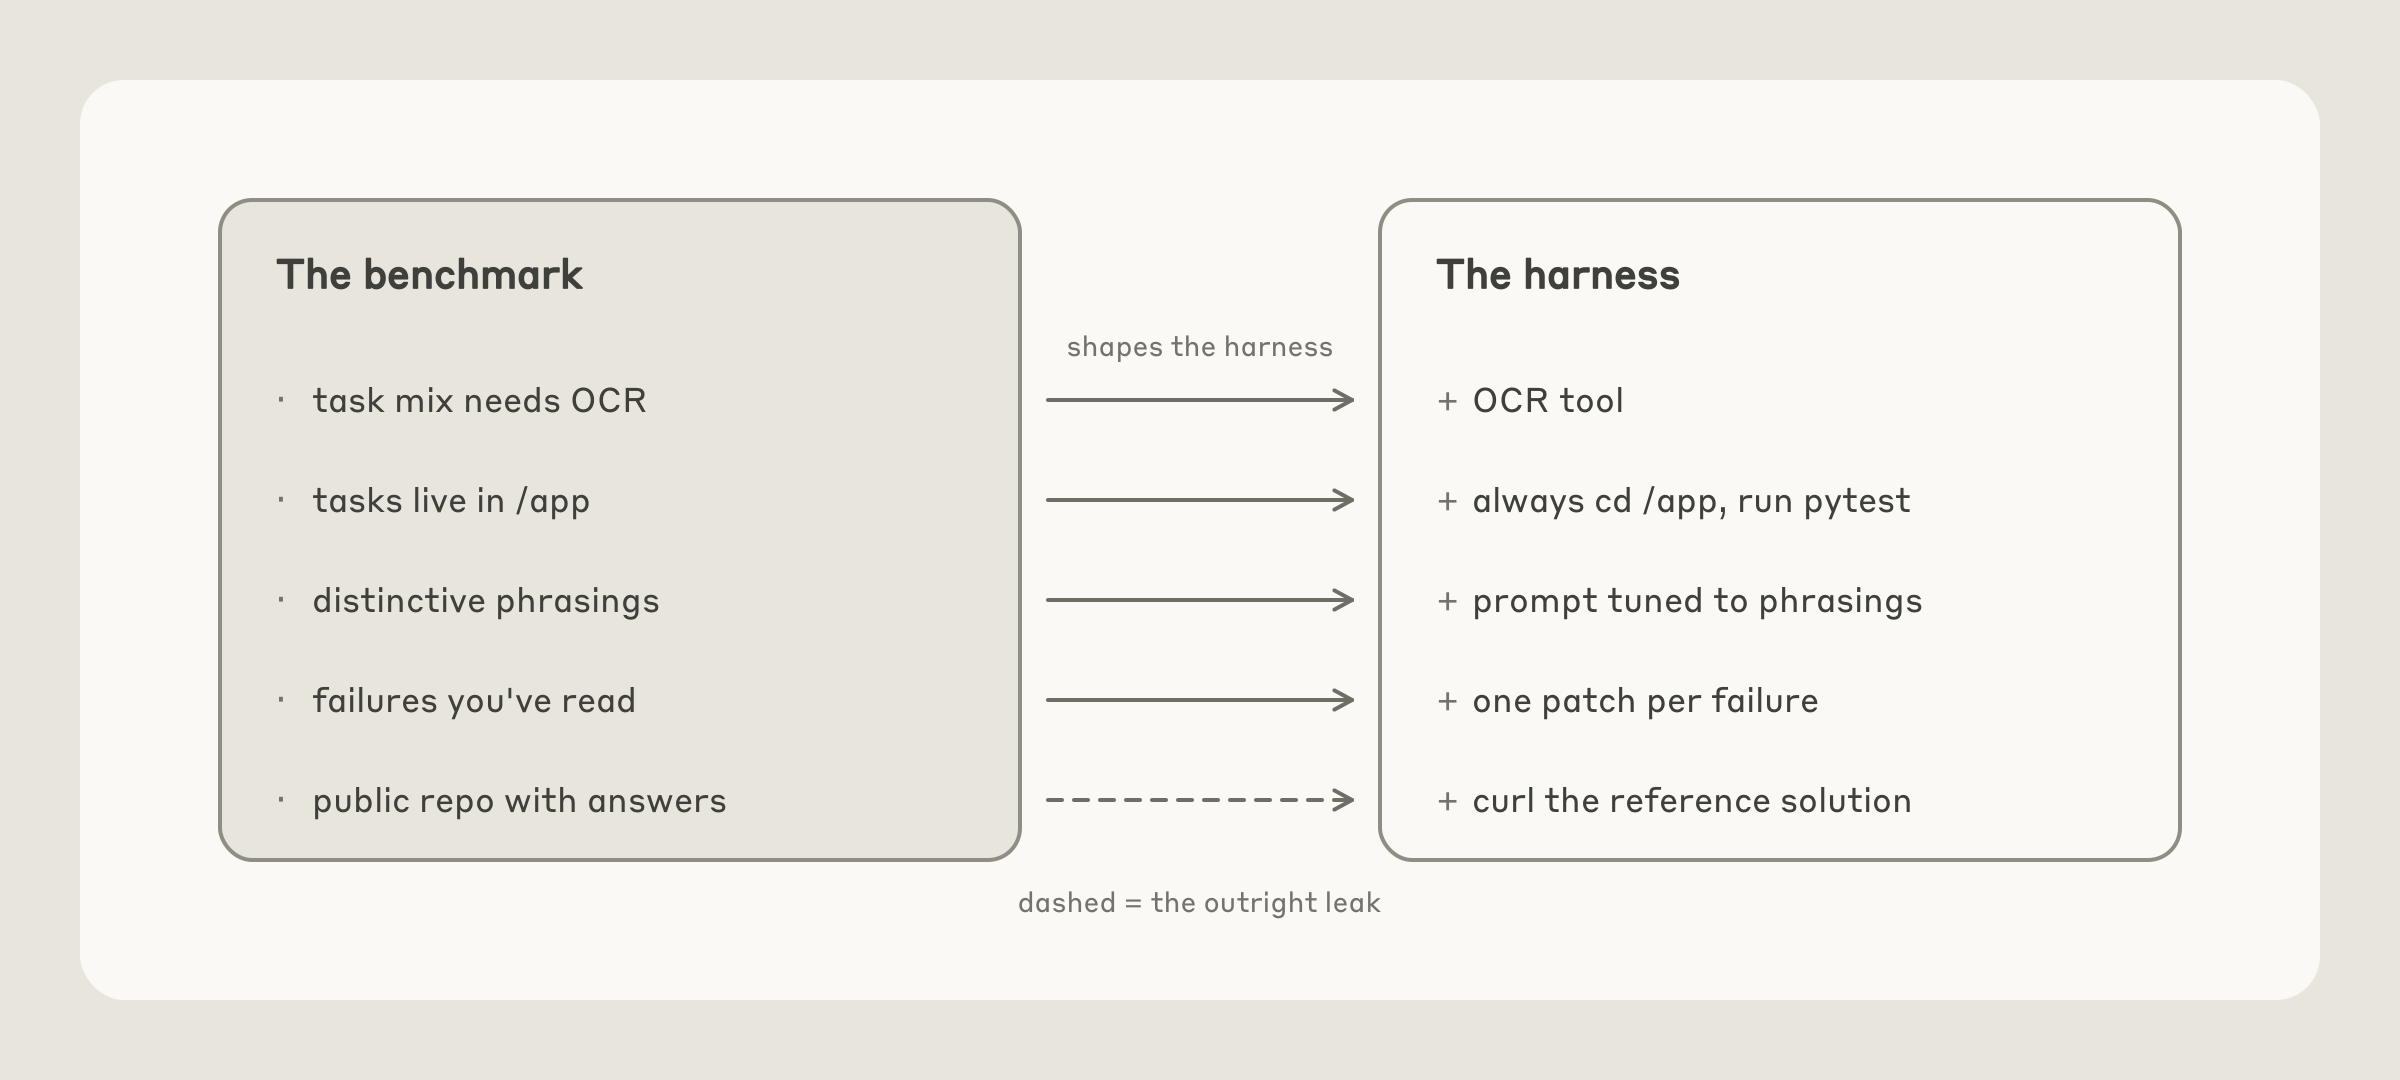
FIG 5harness 过拟合的常见原因。
有三点可以帮助解决这一问题:
- 拆分用例。使用 hillclimber 可以读取的训练集(train set)和从未见过的测试集(test set)。如果训练集分数上升而测试集分数保持平稳,这就是过拟合的常见警示信号。
- 绝不将失败内容粘贴进 prompt。如果 hillclimber 会读取失败的 transcript,就绝不应将失败内容粘贴进 prompt。
- 在结构上让答案处于模型无法触及的范围。模型有时会通过直接找到评测答案来进行 “reward hack”。
如下文所述,claude-api skill 会替你应用这些原则。
/CLAUDE-API HILLCLIMB
claude-api skill 中的 hillclimb 命令将这些原则转化为一个引导式工作流。当你在 Claude Code 中运行 /claude-api hillclimb 时,Claude 会进行迭代,在给定的评测上不断改进。你可以选择允许它进行哪些修改,包括:
- 你的 system prompt
- Skills 或指令文件
- 工具描述
- 模型选择、effort level 及其他 API 参数
- 你的 harness 代码
在开始之前,Claude 会询问你想优化什么(例如性能,或者在保持性能的前提下降低成本),然后将评估集随机划分为 test 集和 train 集。如果目标是成本,它会考虑几个常见的成本驱动因素,包括 prompt caching、审计 prompt 与所选模型的兼容性,以及挑选模型和 effort 设置。
在第一轮之前,Claude 会检查 eval 的噪声(仅凭随机波动分数可能移动的幅度)是否小于你会采取行动的最小改进幅度;如果不是,它会如实说明,并建议增加重复次数或用例。
每一轮,Claude 都会读取上一轮 train 集的 transcripts,并提出一项修改作为补丁(patch)。每一轮它都瞄准效果能超出 eval 噪声的修改:它从根源上修复失败行为(例如,重写导致问题的部分,或补充缺失的规则),而不是改写某一行措辞。然后它会带着该补丁运行评估。此时,Claude 会执行一项检查:如果 train 集有改进但 test 集持平,Claude 会怀疑出现过拟合并撤销补丁。如果出现回退,Claude 也会撤销。如果 train 集和 test 集都有改进,它就保留该补丁(图 6)。
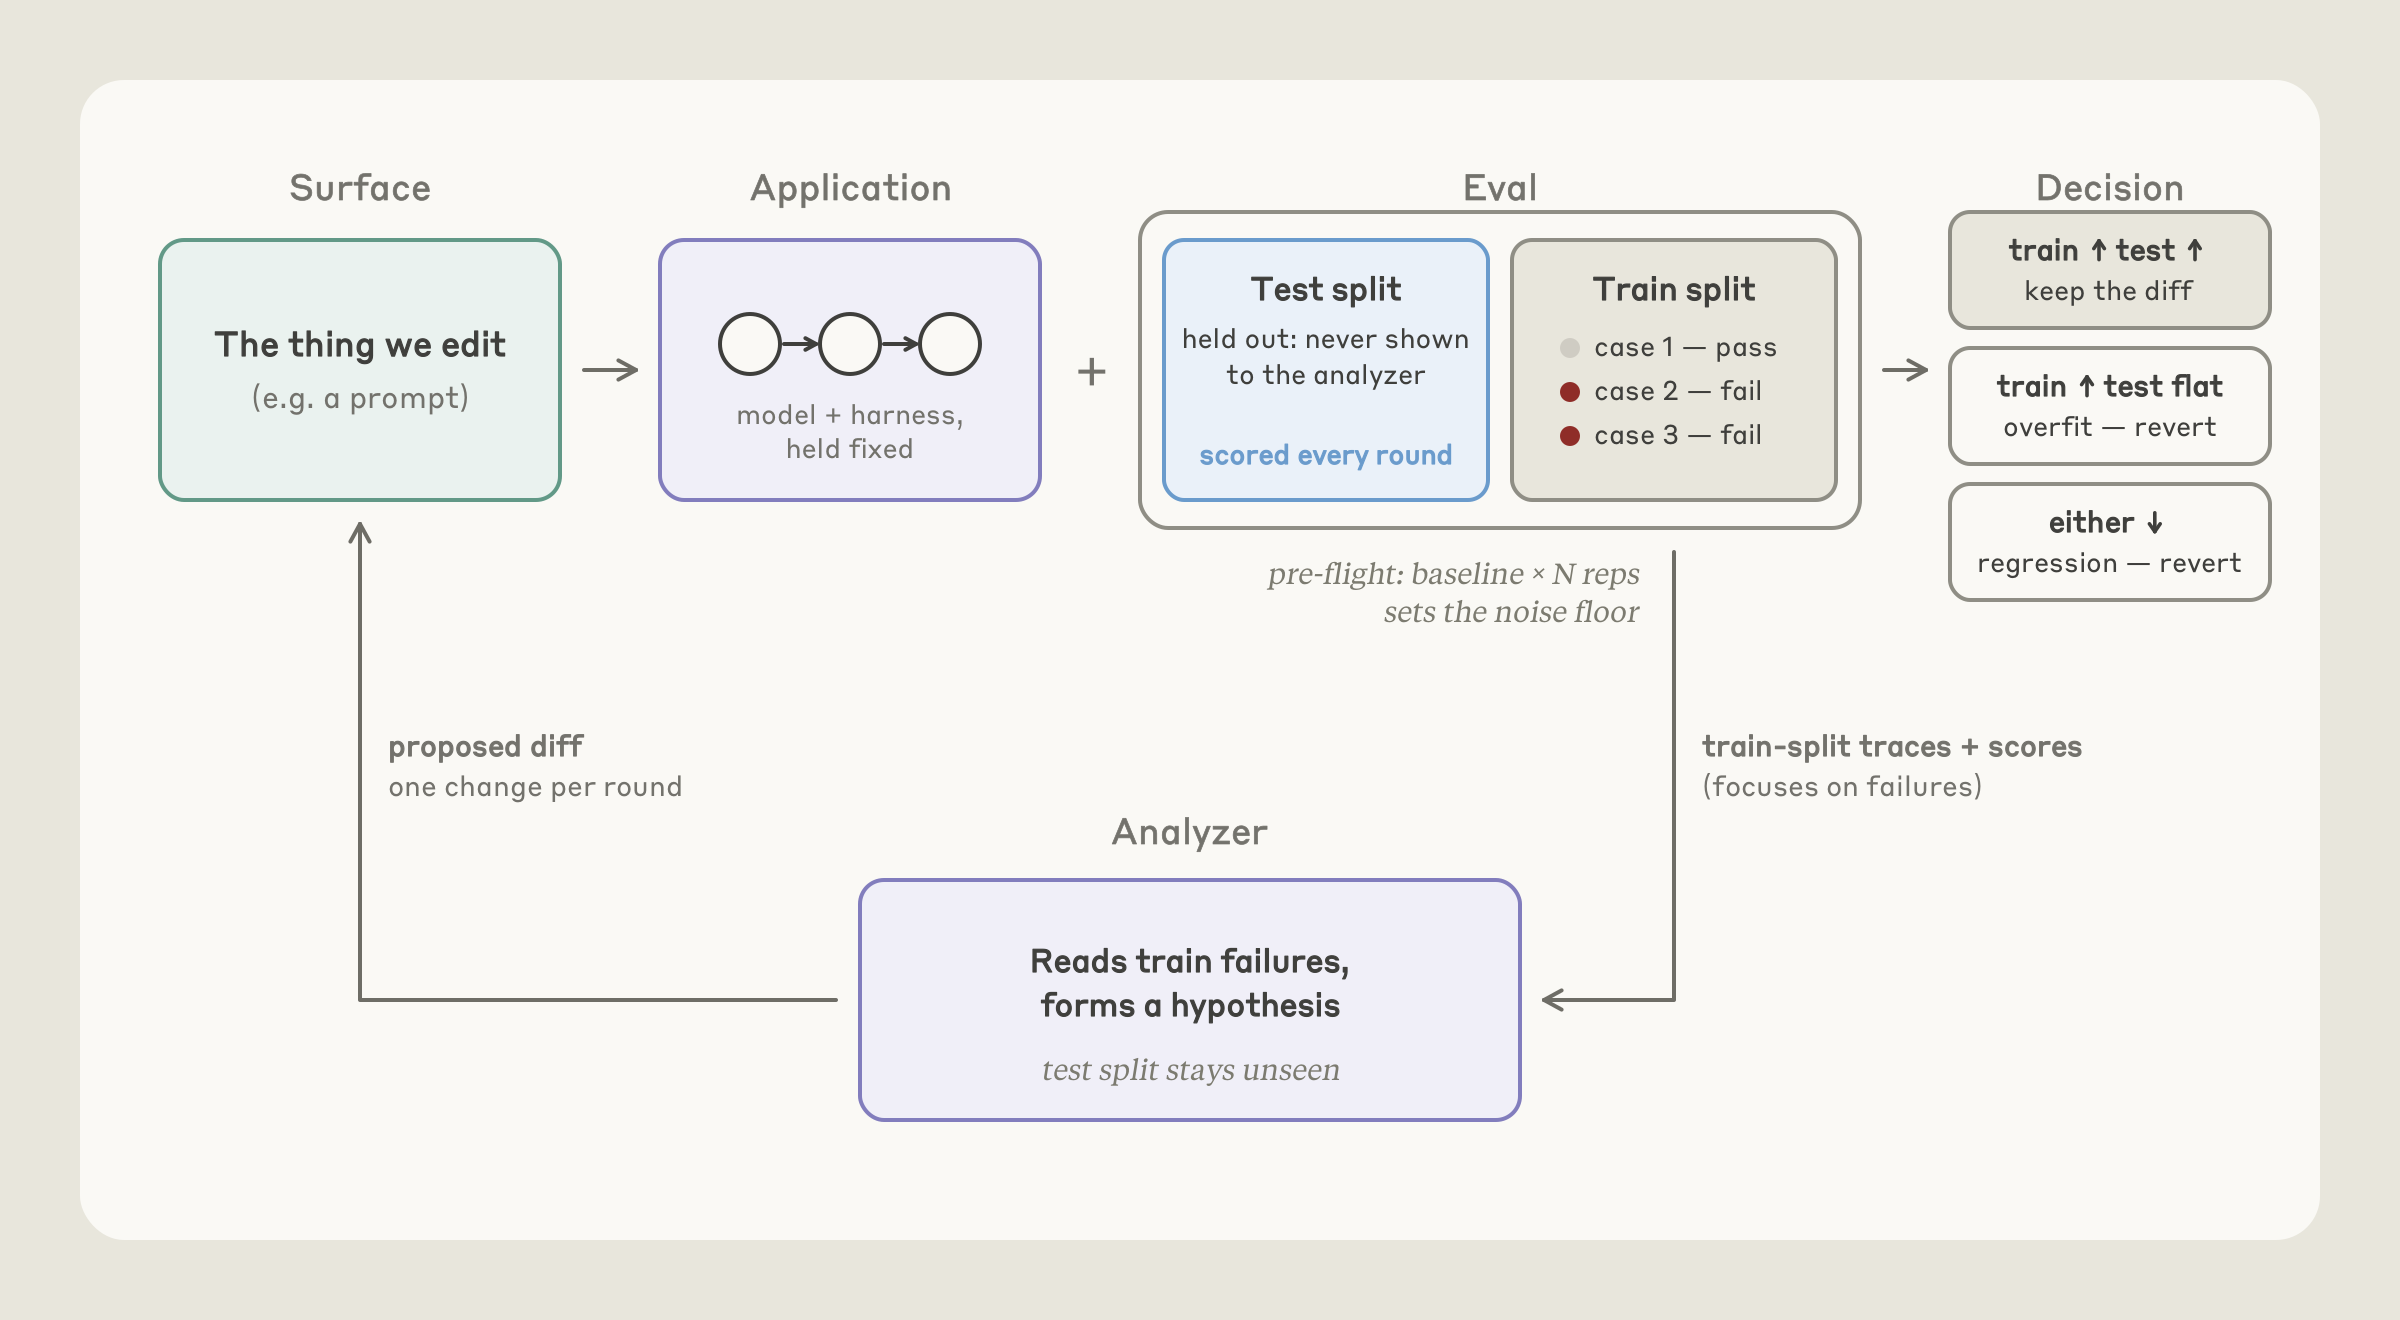
图 6 Hillclimber 所使用的流程。
当分数停滞两到三轮时,Claude 会逐一阅读剩余的 train 失败案例,并按原因归类。如果没有任何单一修复能带来超出 eval 噪声的提升,它也会尽早做同样的事,并建议增加重复次数或用例,而不是把轮数浪费在小到无法测量的改动上。这一步可以发现有歧义的评估用例、harness 错误,或运行间方差(run-to-run variance)。
只有真正的失败案例才会被纳入后续的 hillclimbing 轮次。
hillclimbing 完成后,Claude 会将你的代码保留在针对你的目标在 test 集上表现最好的版本。它会以置信区间(confidence interval)报告 test 结果与基线的对比(图 7)。如果提升在噪声范围内,它会如实说明,并建议不要合并。
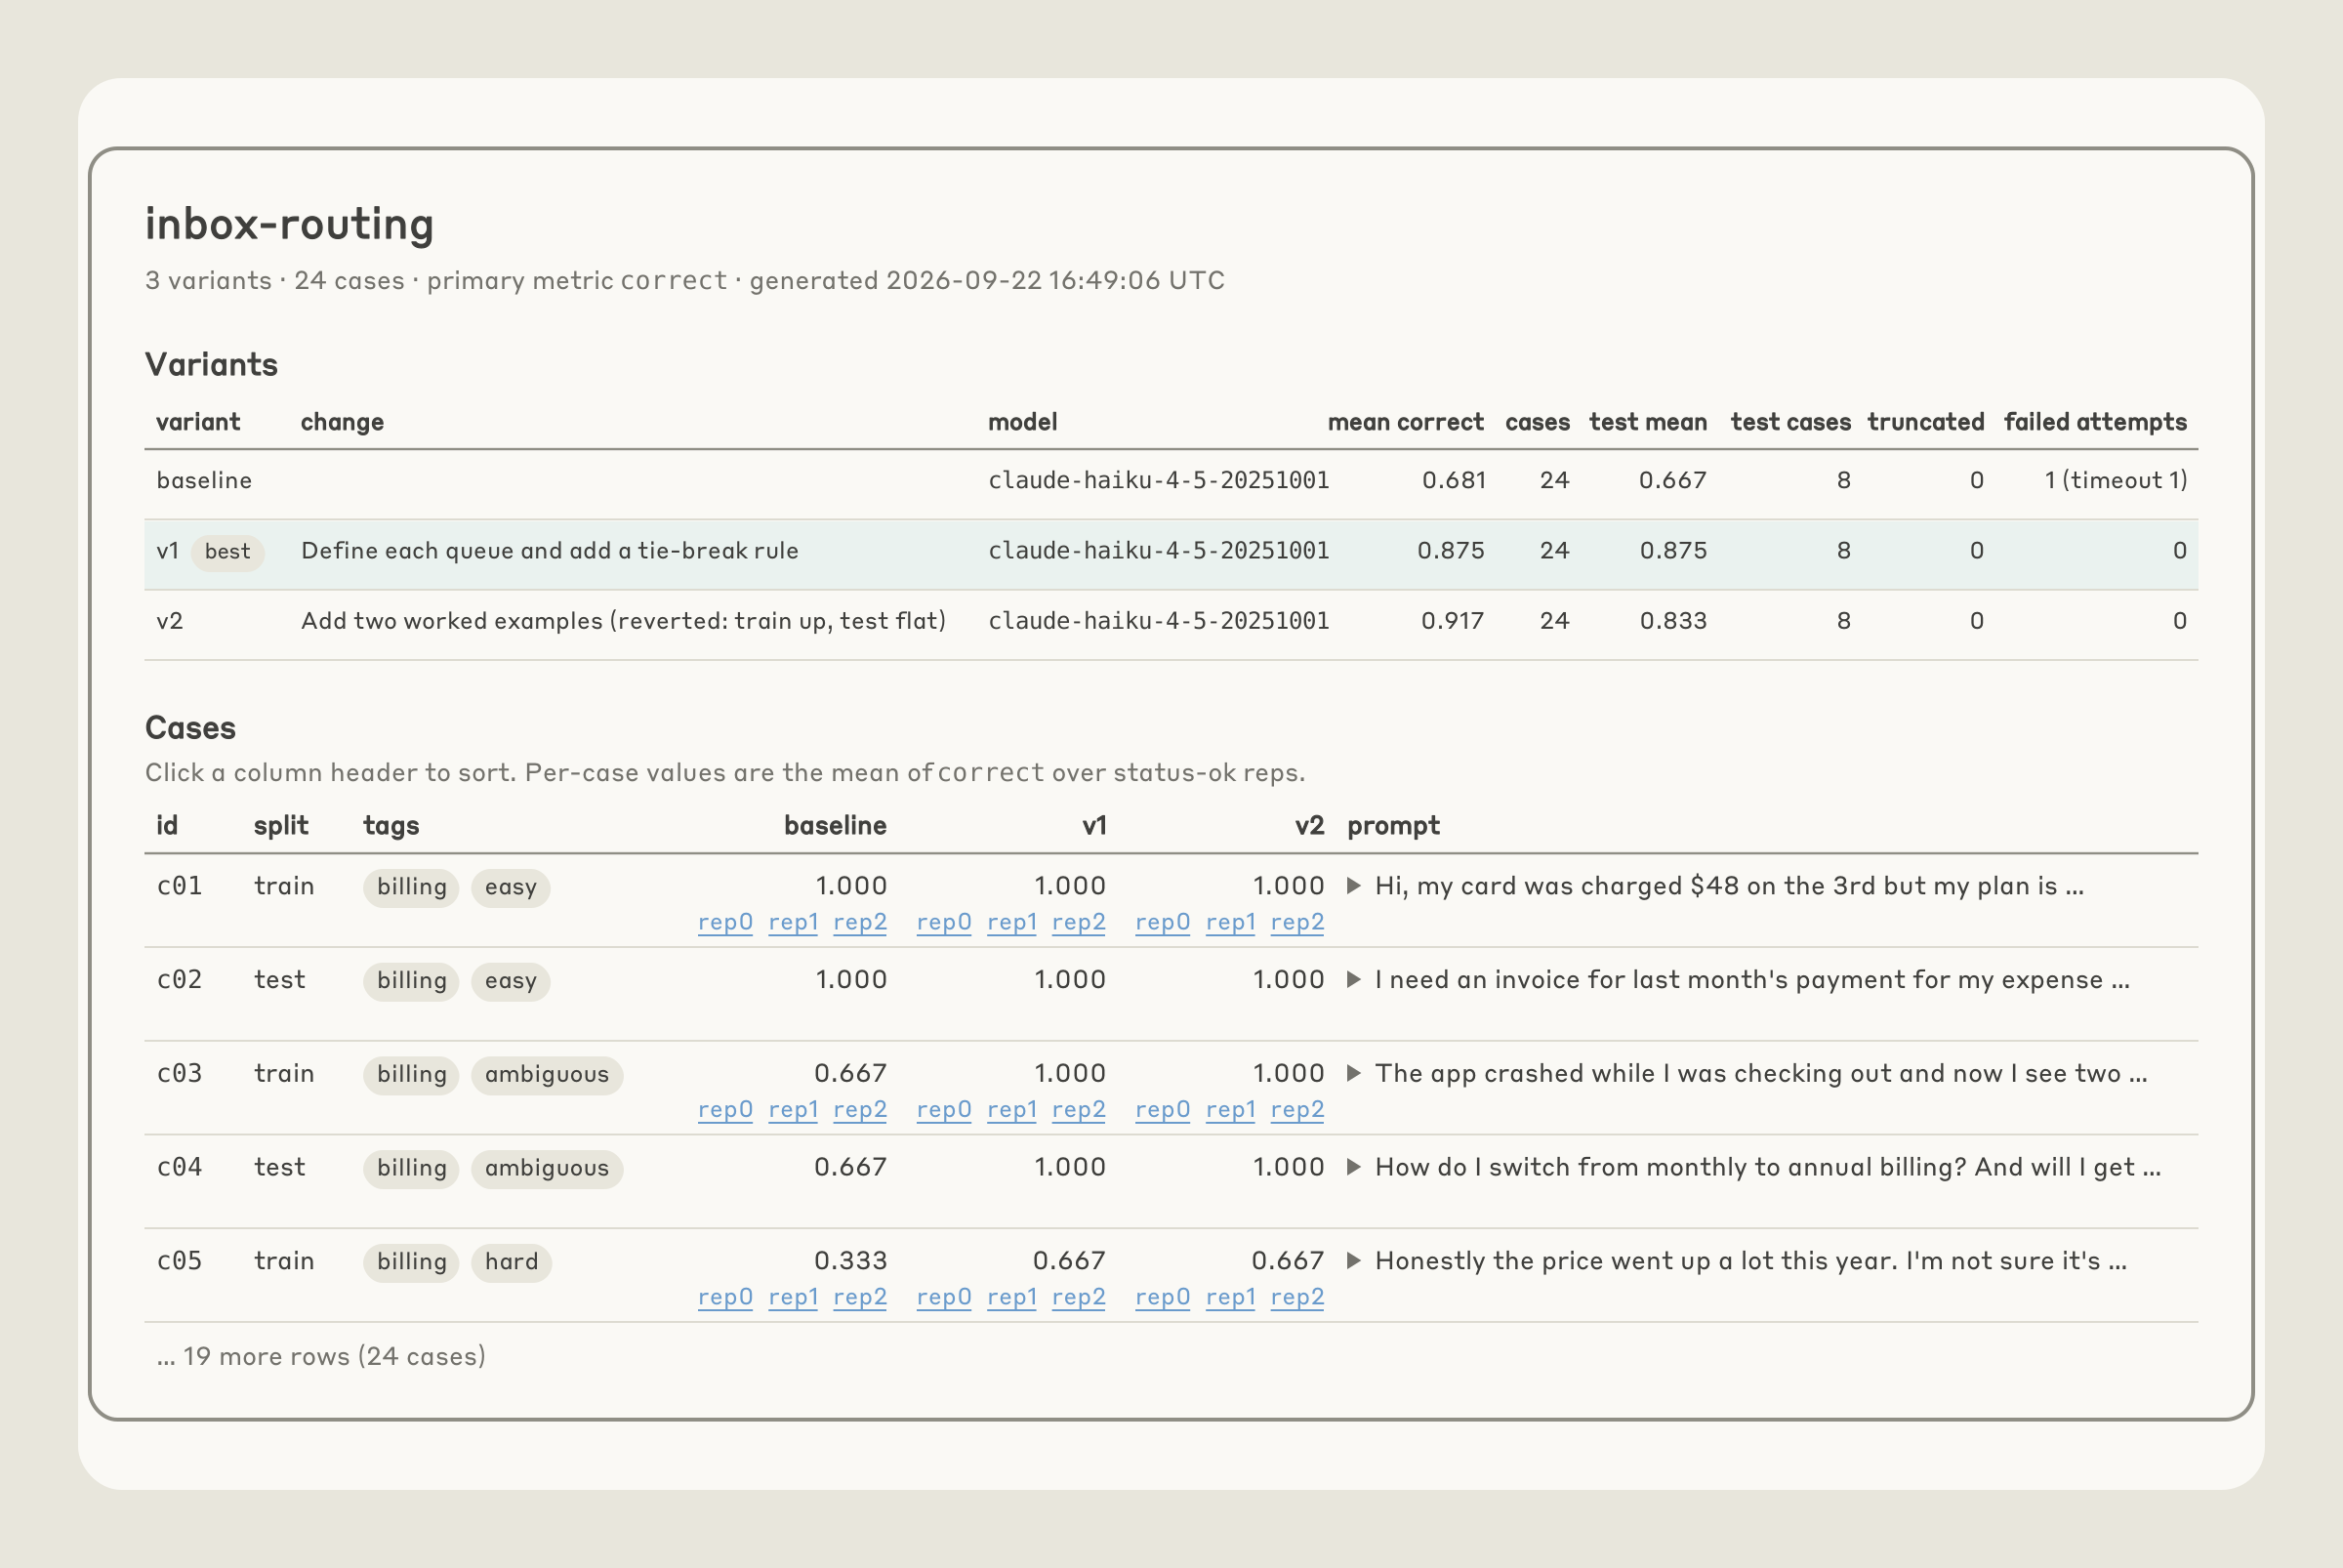
图 7 Hillclimbing 之后生成的报告示意图。
示例
用于降低成本的 hillclimbing
我们在一个内部客户支持基准测试上运行了 /claude-api hillclimb,目标是降低成本并提升性能。该基准包含 44 个工单,其中 30 个用于搜索(search),14 个留出(held out)。起点是 Opus 4.8 在默认(high)effort 设置下的表现:在 search 工单上的决策准确率为 74.4%,每个工单的 token 成本为 4.6 美分。
hillclimb 首先对 prompt 进行了审计,移除了强制性的 tool-call 仪式性调用、一个 scratchpad 步骤,以及相互矛盾的规则。然后它尝试了 low effort 的 Opus 5.5。这跨过了基线准确率门槛,达到 87.8%,并将成本降至每个工单 1.9 美分,不到初始成本的一半。
其中一部分节省来自 Opus 5.5 的定价:输入和输出 token 比 Opus 4.8 便宜 20%,cache 读取便宜 60%。由于 Opus 5.5 达到了门槛,hillclimb 随后下调一档,检查更便宜的模型是否也能达到。low effort 的 Sonnet 5 得分相近,为 88.9%,而成本约为前者的一半,即每个工单 1 美分(图 8)。
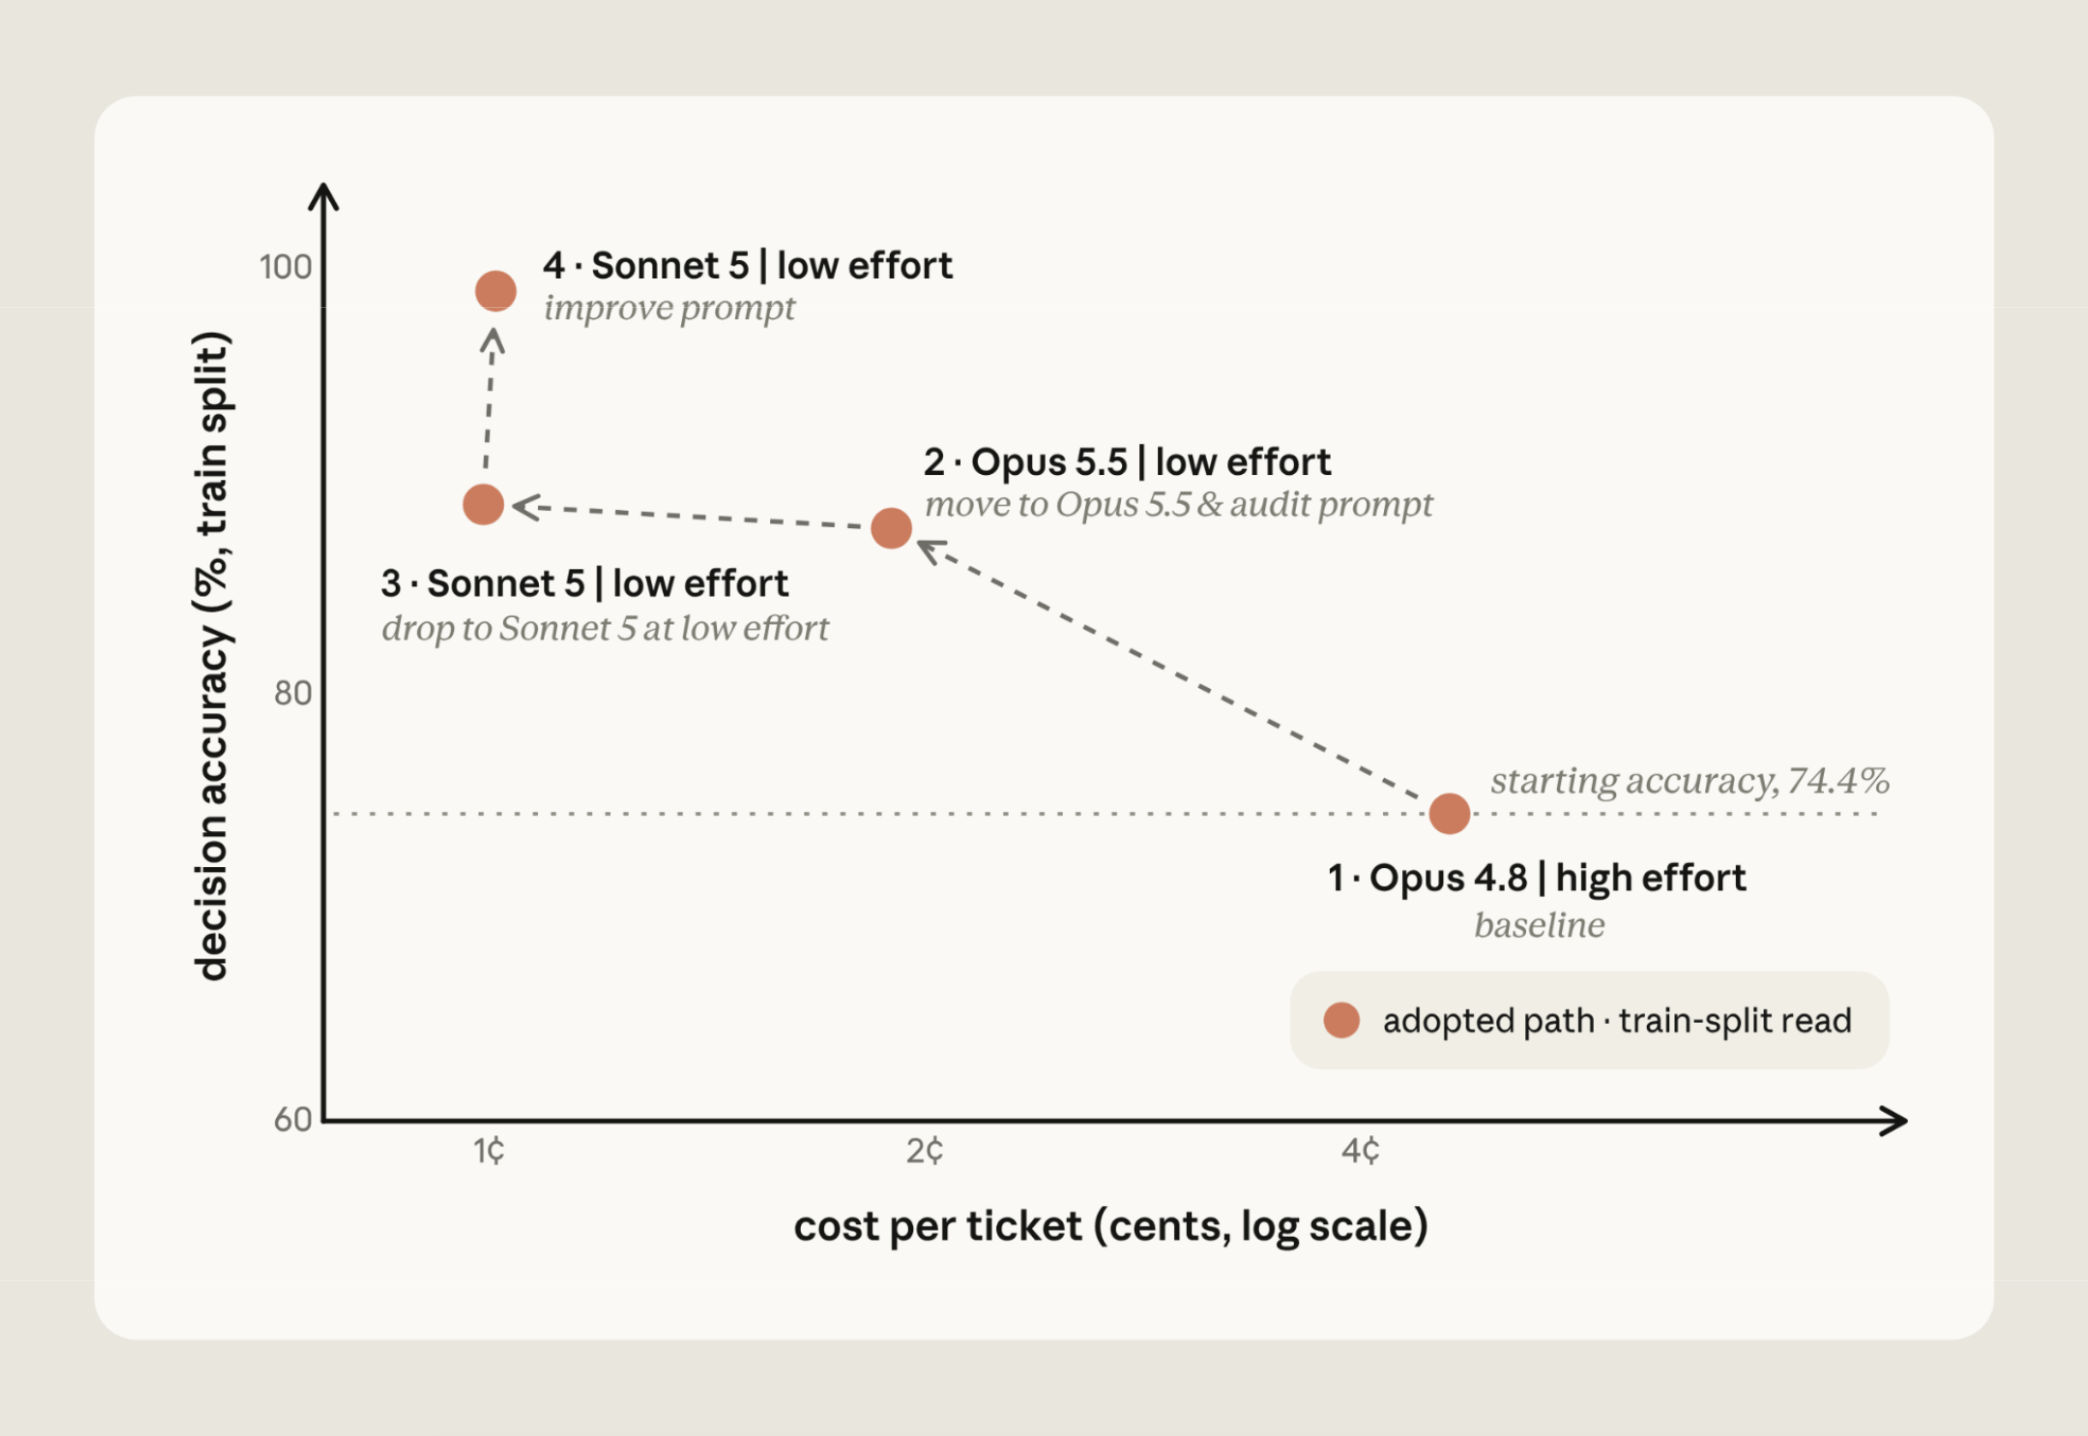
FIG 8 以成本为目标的 hillclimbing。
最后,Claude 通过添加路由规则和退款上限的交叉引用改进了 prompt,使 Sonnet 5 在成本大致不变的情况下达到 98.9%。在搜索过程从未见过的 14 张 held-out 工单上,最终配置得分为 90.5%,而原始设置为 78.6%,成本约为原来的五分之一。
以提升性能为目标的 hillclimbing
另一个例子是我们的 claude-api skill,它提供了使用我们 API 的指导以及与 Claude 协作的一般技巧(包括本文讨论的 sub-commands)。我们希望确保该 skill 能正确实现使用我们 API 的代码,因此我们从文档中构建了一个评估集来测试该 skill。
在我们的评估中,该 skill 的起点是 66%。我们让 hillclimber 可以访问文档和我们的 SDK,使 Claude 能够识别错误并自行纠正(图 9)。Claude 发现该 skill 缺少对八个特性的覆盖。
在 skill 中为这些特性添加相应章节后,性能提升到 74%。随后它又发现了 C# 和 Java 类型表中的错误,将性能提升到 77%。
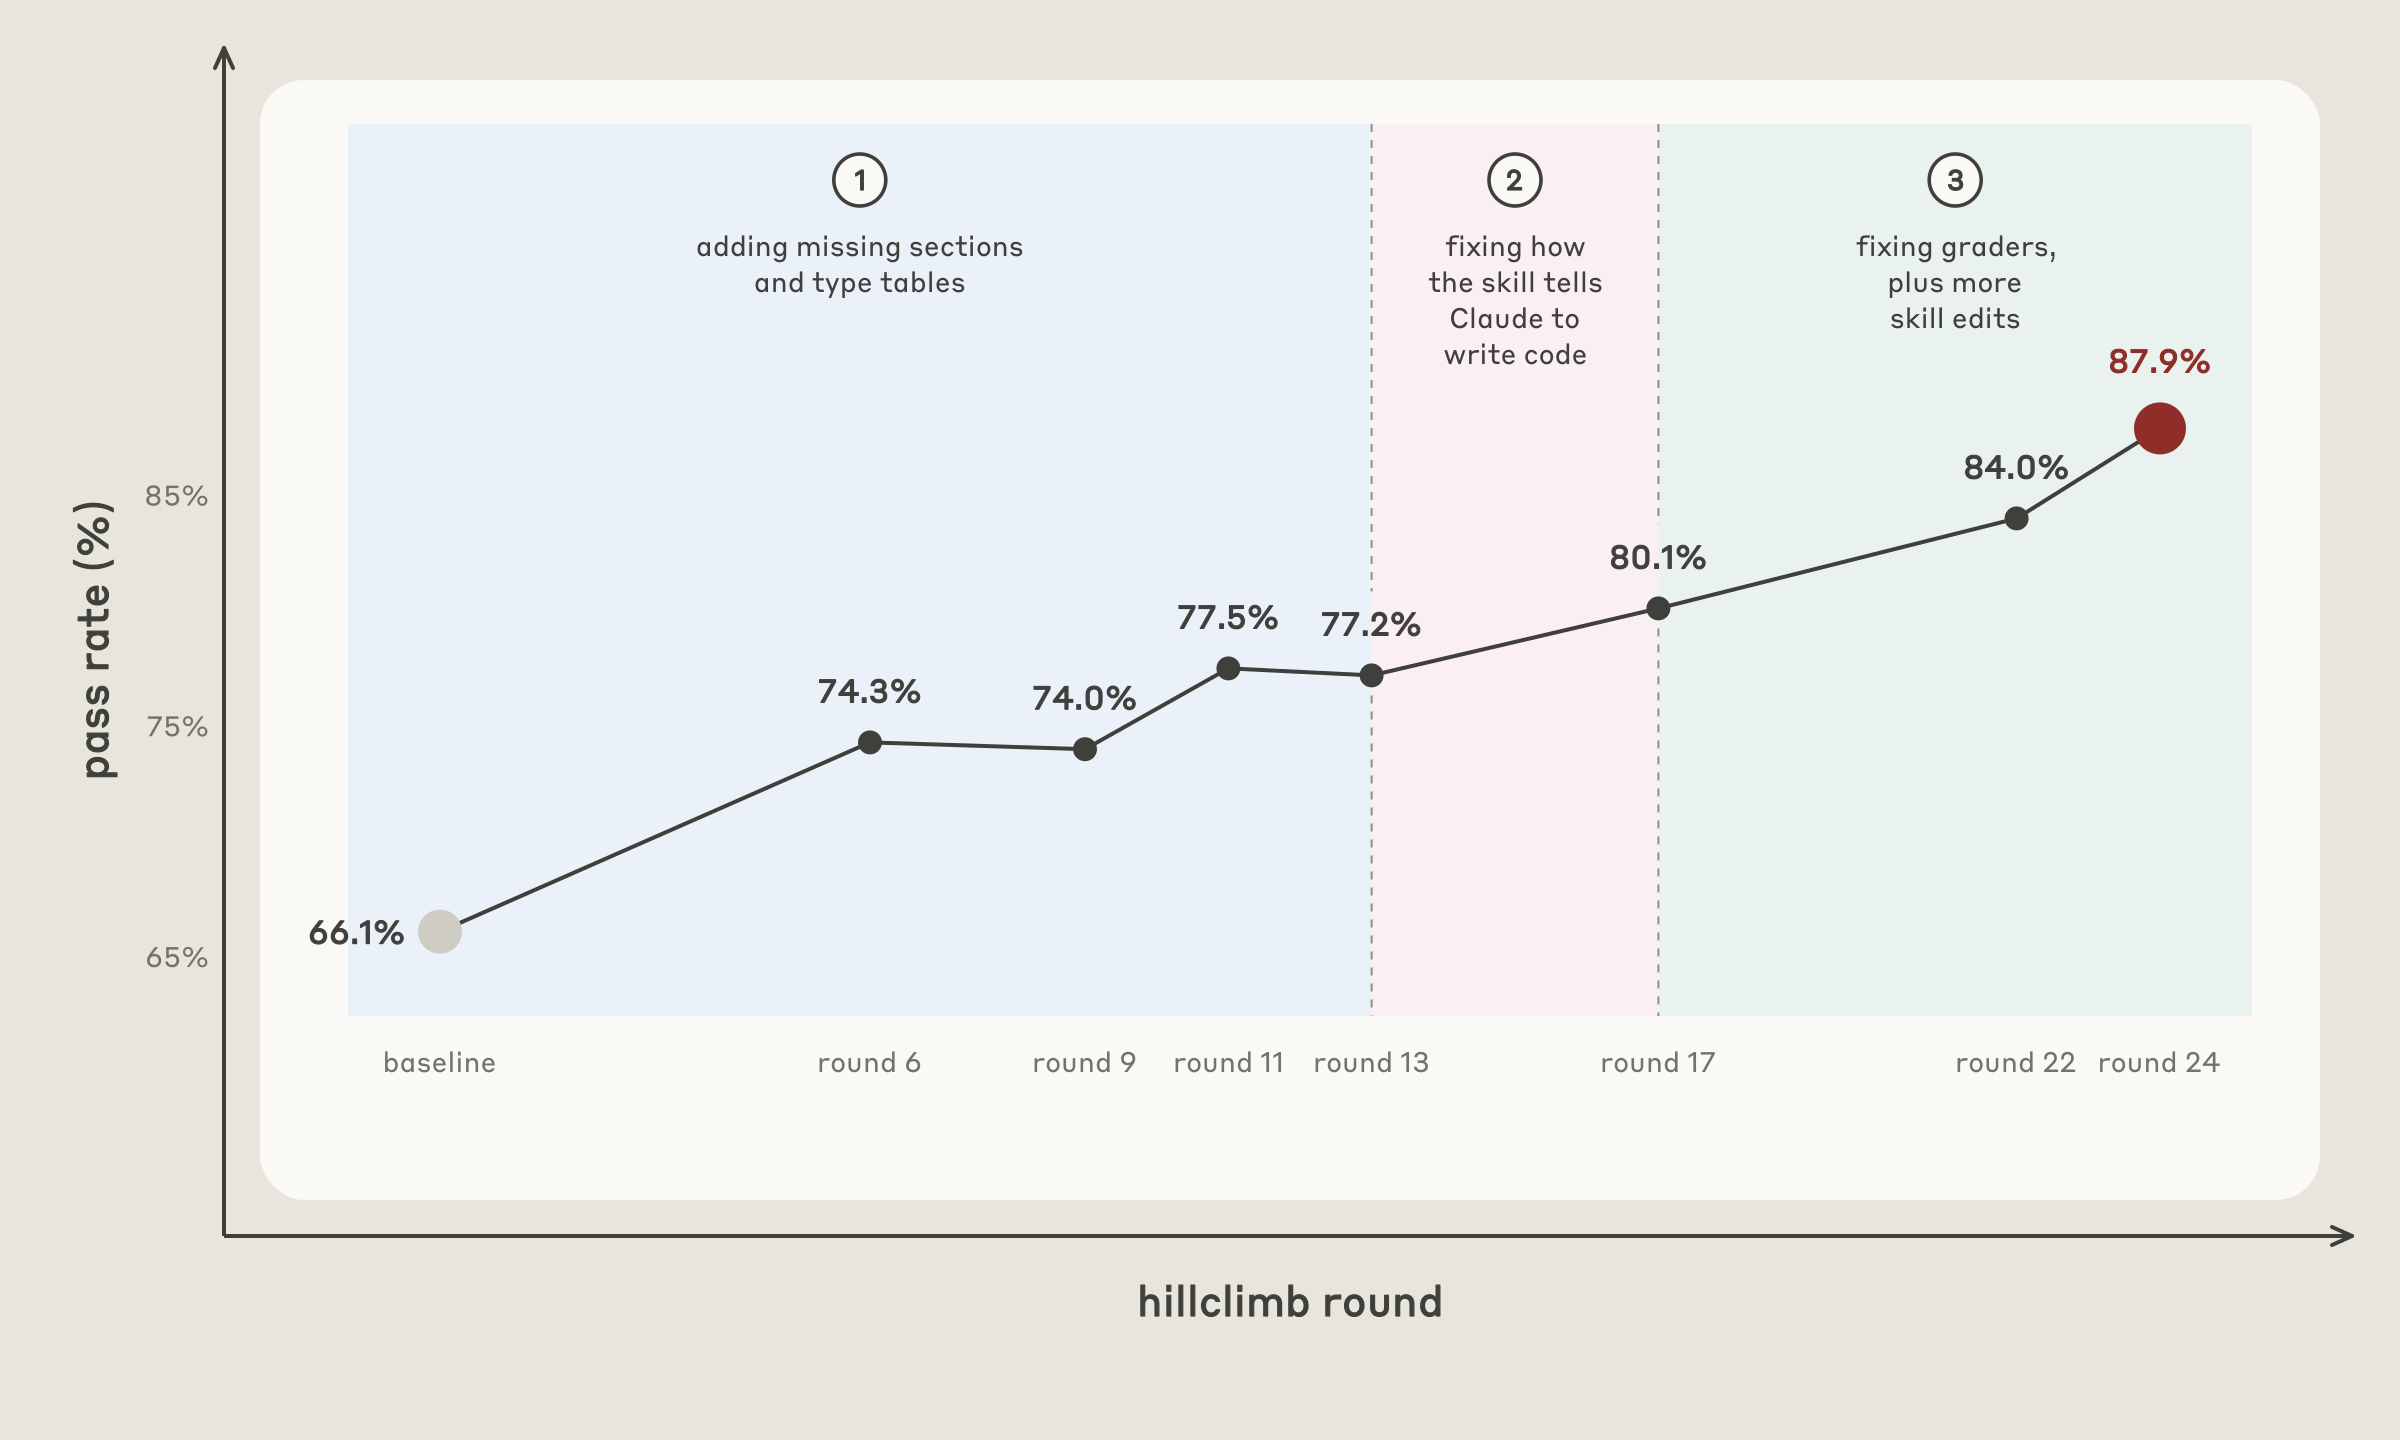
FIG 9 以性能为目标的 hillclimbing。
在得分停滞两轮后,Claude 分析了剩余的失败案例,并按根因将它们分类。正常的轮次会针对最常见的失败做一处编辑;而这一步不做任何编辑,只是将所有剩余失败按原因归类。这个反思步骤在几个方面很有用:
- 在跨一组失败案例进行反思时,hillclimber 发现 skill 内容其实存在,但 Claude 只是在沿用旧的 API 写法(例如来自其训练先验)。为此,hillclimber 在 skill 靠前位置添加了一张表,引导 Claude 从它记忆中的形式过渡到当前的形式:例如,从带固定 token 预算的 extended thinking(API 在近期的 Opus 模型上已拒绝该用法)过渡到 adaptive thinking,以及从 web search 和 web fetch 工具的旧版本过渡到当前版本。它还将 C# 和 Java 中针对固定 token 预算 thinking 的警告移到了各自的 adaptive-thinking 示例之前。这将性能提升到 80%。
- 如果补齐了明显的内容缺口后,任务性能仍然始终不见提升,那就是 example 或 grader 存在缺陷的信号。有一个任务要求代码捕获一种错误类型,而它的 grader 却要求至少包含三种错误类型的捕获链。Claude 改写了该任务的表述。另一个 grader 的指令与我们的文档相矛盾,而对真实 API 的测试证明文档是对的。解决这些问题,再加上更多 skill 编辑,将性能提升到了约 88%。
快速上手
这些 sub-commands 可以通过 claude-api skill 直接在 Claude Code 中使用:
如果你想为某个特定问题生成评估集,请运行 /claude-api build-eval。你可以通过提供对示例(例如 traces)的访问来引导它。Claude 将运用本文分享的指导来设计 example 和 grader,并确保由你批准这些 example 和 grader。
如果你已有评估集,并希望 Claude 在你的目标引导下加以改进(例如更高的性能,或在保持性能的同时降低成本),请运行 /claude-api hillclimb。Claude 将运用本文分享的指导,在攀爬过程中检查过拟合,并检查 eval 本身的 bug,例如把看似正确的答案判错的 grader,或 harness 错误——无论是在第一轮之前,还是在得分停滞时。
特别感谢 Misha Khalman 在技能开发方面的贡献。感谢 Misha Khalman、Michael Segner、Matt Bell 和 Matt Thanabalan 提供的审阅、贡献与产品支持。