Google 发布Gemini 4 Argon:综合评分超越GPT-6 Astra、Claude Fable 5.1 以及 Claude Opus 5.5
原文链接: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/ 来源: Google 发现于: 小互 · AI 解读站 · 2026/10/1 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
Gemini 4 Argon:我们前沿智能的新纪元
2026年9月30日
|
Gemini 4 Argon 在复杂工作流程中提供前沿性能,涵盖现实世界软件工程、企业知识工作(如法律和金融)以及网络安全防御。
      [Koray Kavukcuoglu SVP,Google DeepMind 和首席 AI 架构师,Google](https://blog.google/authors/koray-kavukcuoglu/)


              分享
收听文章
[[duration]] 分钟
此内容由 Google AI 生成。生成式 AI 具有实验性。
- Google 的新一代 Gemini 4 Argon 模型为复杂、长周期的专业任务带来先进的推理能力。
- 该模型拥有业界领先的 100 万 token 限制,支持深度、多步骤的问题解决。
- 它擅长编码、金融研究、法律文书起草以及自主网络安全漏洞修补。
- Argon 目前正通过 Fairwind Program 向受信任的网络防御者推出。
- Google 在向公众更大范围发布之前,优先考虑安全性和严格测试。
摘要由 Google AI 生成。生成式 AI 具有实验性。
本文目录
今天,我们宣布推出我们的新前沿模型 Gemini 4 Argon,该模型正通过我们的 Fairwind Program 向一组受信任的网络防御者推出。Argon 专为在复杂、长周期工作流中维持深度推理而构建,正在从根本上改变我们在 Google 的工作和构建方式。它在现实世界软件工程、法律和金融等企业知识工作以及网络安全防御等复杂工作流中提供前沿性能。
安全地发布这一级别的前沿能力需要分阶段的方法。我们正积极参与美国政府的预发布模型访问自愿流程,同时逐步扩大访问范围。我们将继续收集早期测试者的反馈,在护栏上迭代,然后尽快让开发者、企业和消费者使用 Argon。
Argon 将以入门价格 1 推出:每百万输入 token 2 美元,每百万输出 token 10 美元,缓存的输入 token 价格仅为输入 token 价格的 5%。
改变我们在 Google 的工作和构建方式
Gemini 4 Argon 已经在为我们的内部工作流提供支持,成千上万的谷歌员工强调了该模型在专业编码任务、进行更深入研究和写作质量方面的优势。它正在帮助团队更快地构建,突破工程生产力的边界,并加速突破:
量子算法优化: Argon 正在帮助我们的量子计算研究者优化阻碍重要应用瓶颈的子程序的时空资源(qubits × gates)。在一个示例中,它在几分钟内就比已发布的基准线高出 40%。
内存效率: 一个 Argon Agent 团队分析了整个机群的性能剖析遥测数据,自主识别并在 Google 的数据中心中应用内存优化,一旦推出即可释放超过 300 TiB 的内存,预计总节省量可达 500 TiB 至 1 PiB。
大规模代码库迁移与优化: Argon Agent 们正在 Google 内部开展将 C/C++ 代码库迁移到 Rust 的工作——从 re2、libgav1 等核心库的数万行代码,扩展到 Fuchsia Zircon 内核的 80 万行以上。考虑到其中许多系统的关键性,如此大规模的重写在生产环境推出之前,正在接受严格的自动化和人工审计、仿真测试和审查。 对于 libgav1(Google 的开源视频解码软件),Argon Agent 们采用了现有的 Rust 移植版本,通过多轮 profile-guided 实验、研究编译器输出,生成了安全的 Rust 代码,从而使编译器能够自动进行向量化,替换了 32K 行 SIMD 代码。最终结果是一个内存安全的视频解码器,运行速度比 Rust 移植版本快 2.7 倍,视频输出完全相同,使其更接近优化后的 C++。
在您最复杂的问题上更努力地工作
为了支持 Gemini 4 Argon 在更长、更复杂的用例中的能力,我们大幅扩展了模型的输出 token 限制,从之前的 64K token 提升至行业领先的 100 万 token。当模型有足够的空间进行深度思考,并在单次轨迹中生成数十万 token 时,它为推理增加了新的深度层次,从而一次性解决难题。

跨领域赋能编码和企业工作流
Gemini 4 Argon 在编码、推理和多模态方面的能力,以及其维持长序列、多步骤任务的能力,使其在一系列企业工作流中表现出色。
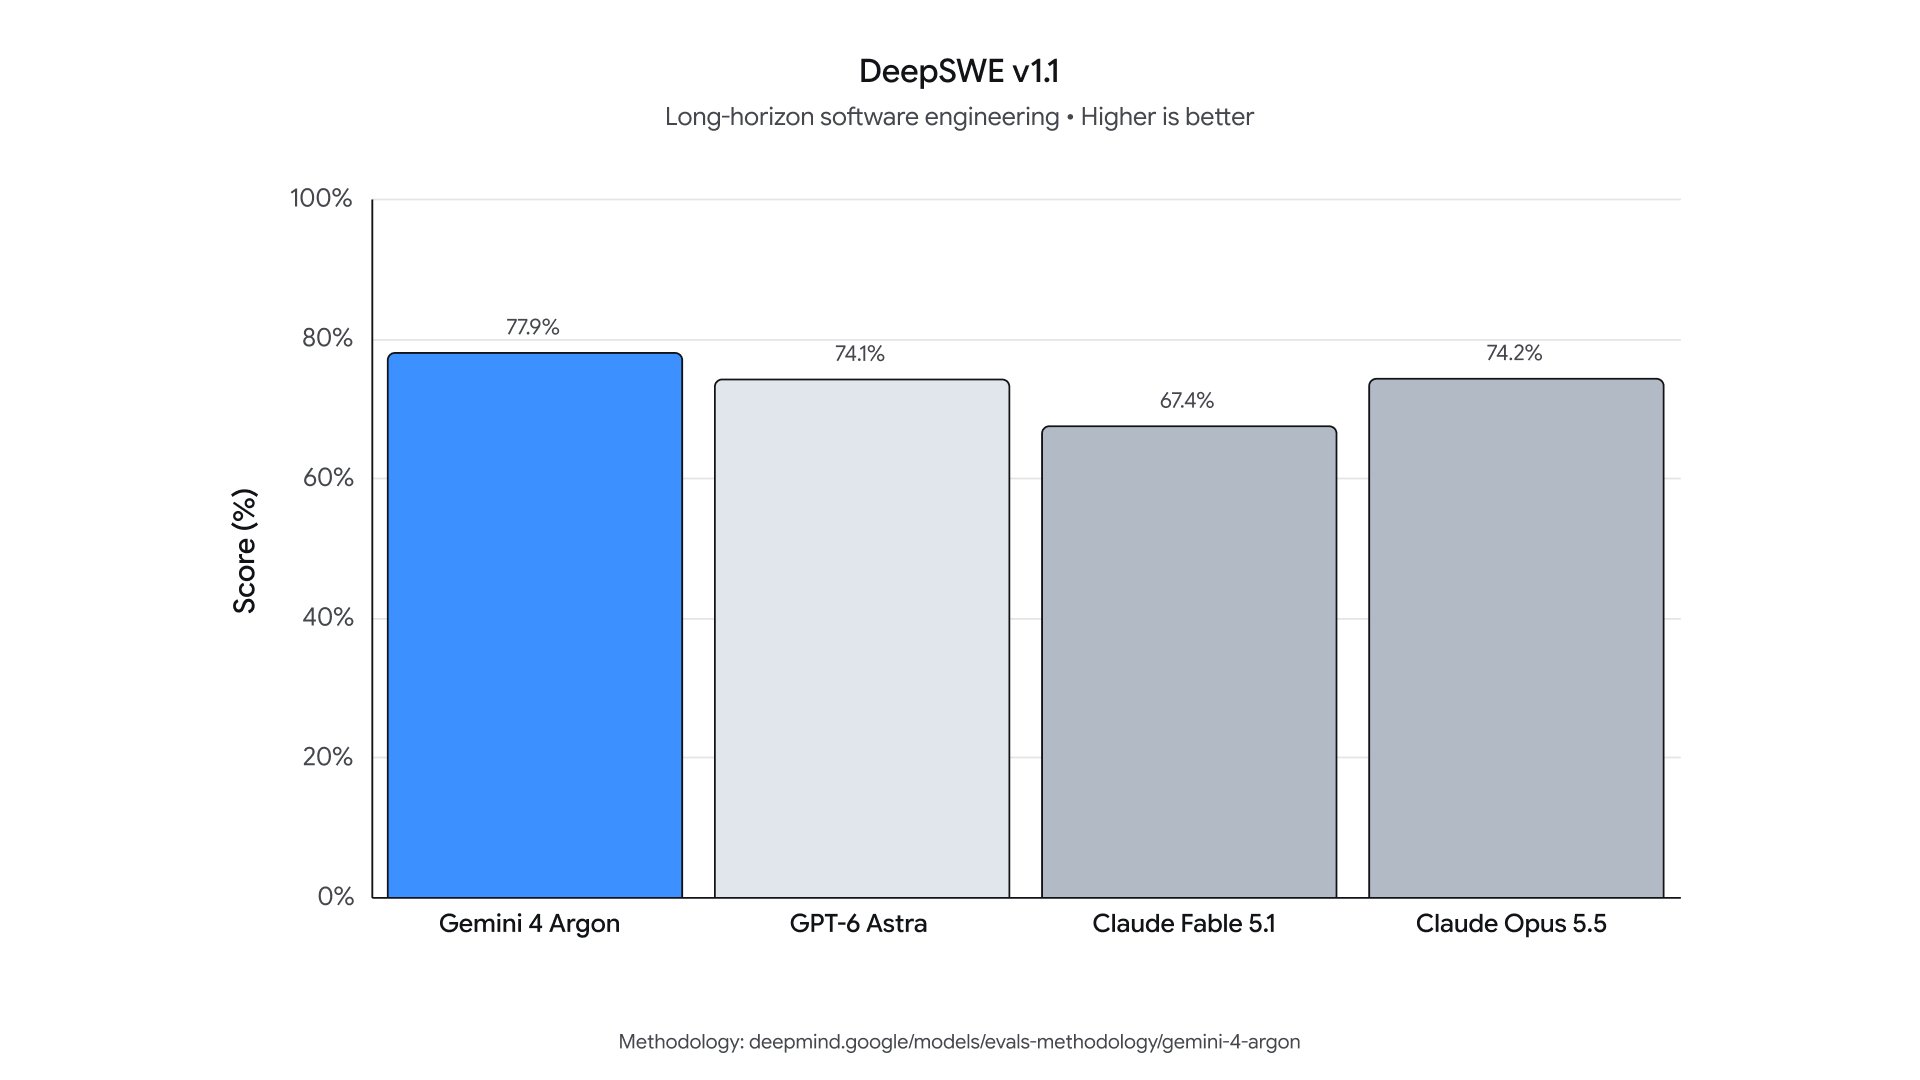
Google 工程师们一直在日常工作中使用 Argon,从日常调试到大规模代码库迁移和算法设计。它在 DeepSWE v1.1(77.9%)上树立了新的行业标杆,该基准衡量模型在现实世界长期软件工程任务中的表现。
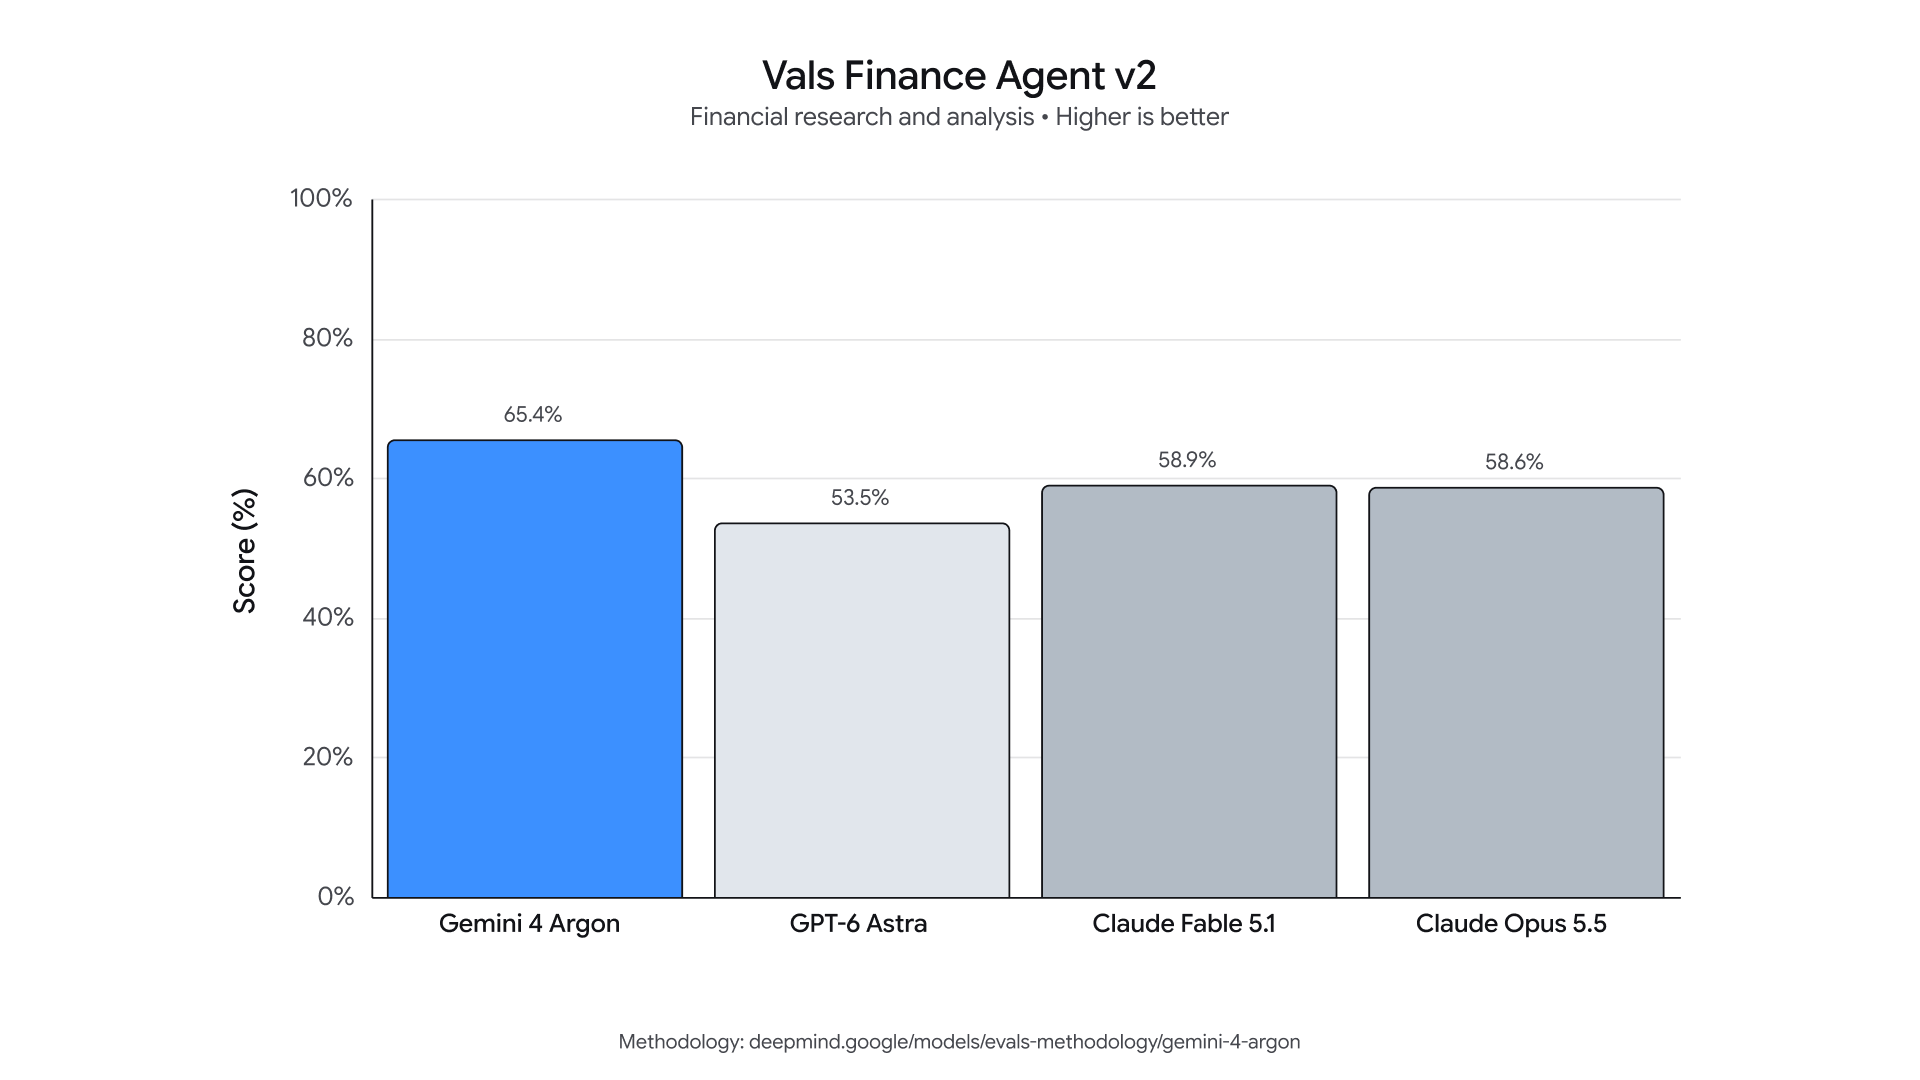
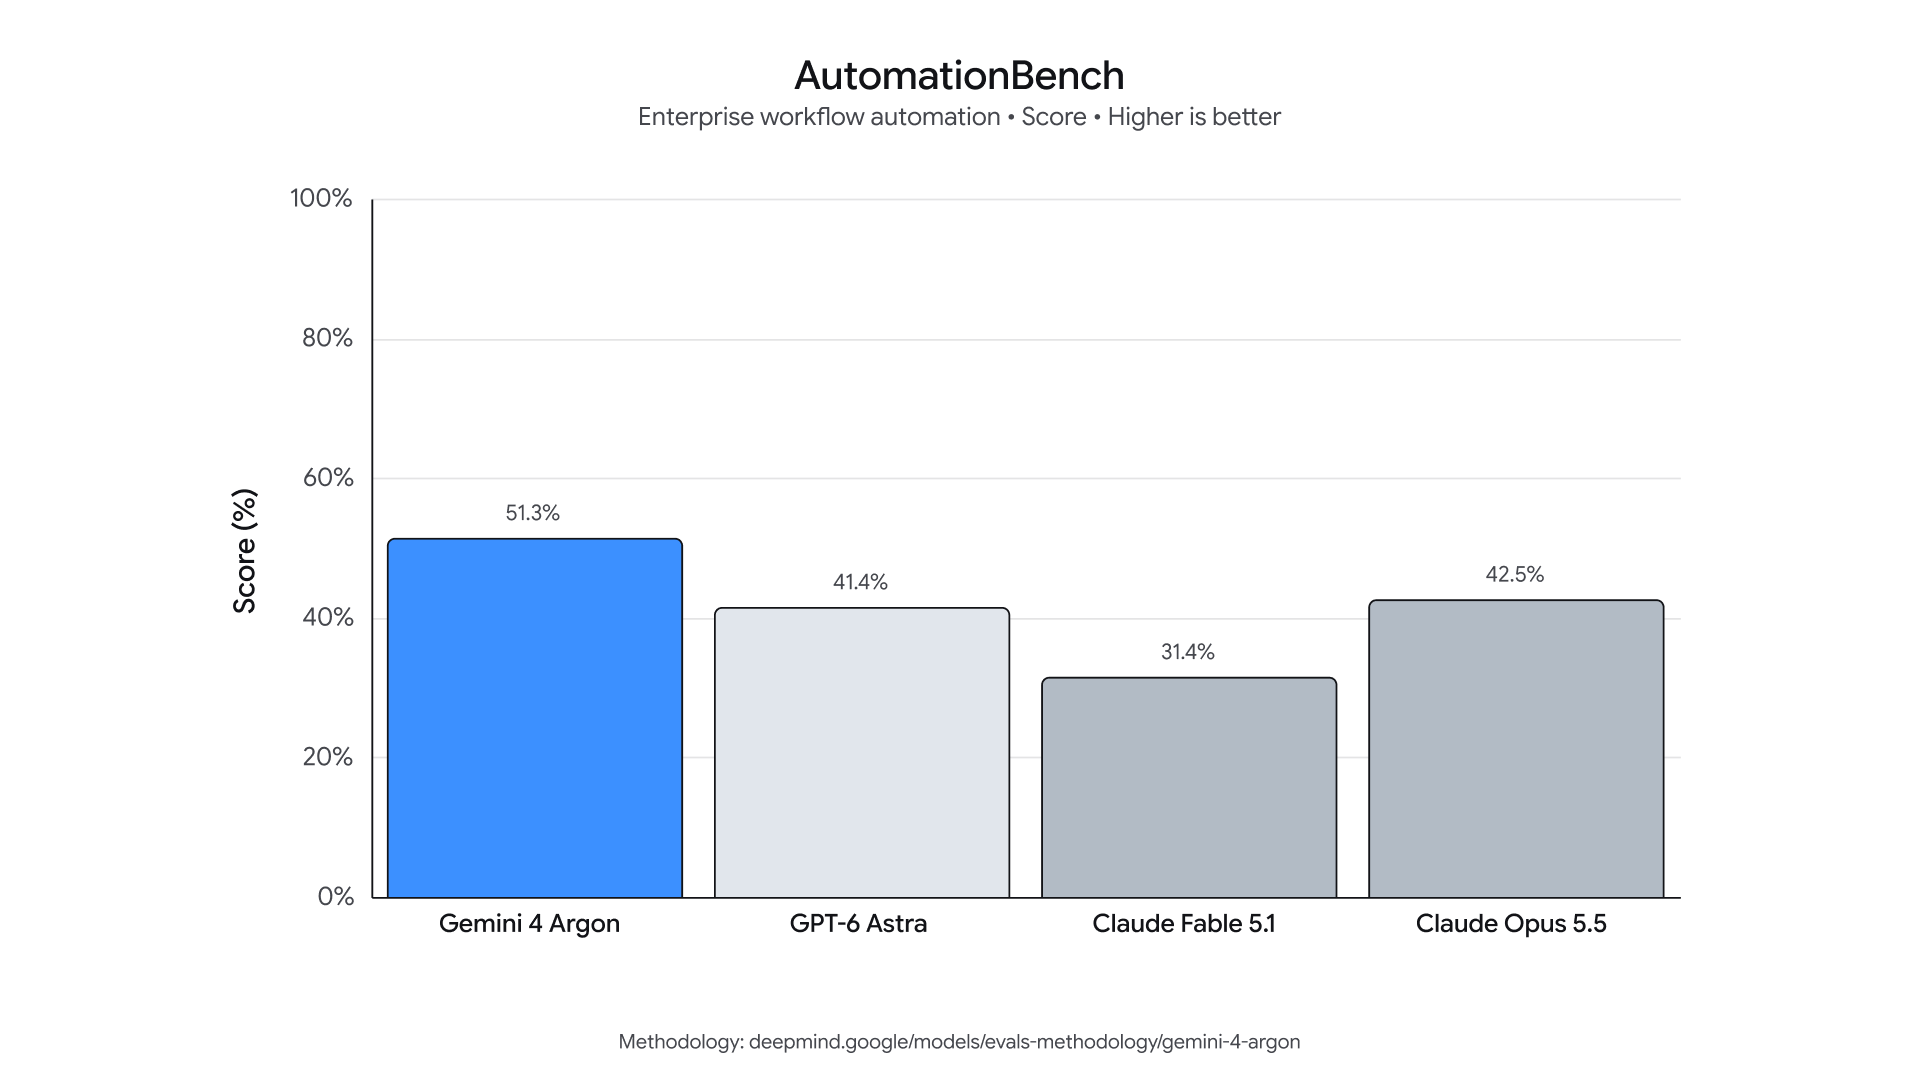
除了编码,Argon 在 Vals Index 上也是领先模型,该指数衡量金融、编码、法律和税务工作对经济的影响,每个行业按其对美国 GDP 的贡献加权。我们在其他领域特定评估中也看到了类似的领先表现,例如 Vals Finance Agent v2(多步骤金融研究)和 Harvey 的 Legal Agent Benchmark(法律研究与起草)。在 AutomationBench(Zapier 的基准测试,衡量核心业务功能的端到端执行)上,Argon 以 51.3% 的得分排名第一。
当知识工作需要视觉理解时,Argon 也表现出独特的优势。它能够进行专业的图表分析,从长视频中识别细节,并根据一系列文档采取行动。例如,在衡量长视频理解的 LVBench 上,Argon 以 91.7% 的得分达到行业领先水平。


在防御性网络安全领域领先
为了更好地装备网络防御者以应对新时代的网络攻击,我们训练了 Gemini 4 Argon,使其在网络安全防御方面具备高度能力。Argon 可以自主发现、验证并修补关键软件漏洞。对于受信任的防御者以及 Google 内部团队,我们将发布不带网络安全护栏的 Argon,以便他们能够充分利用其前沿级别的网络安全防御能力。
Wiz 已经通过其 Scan for Good 计划使用 Argon 进行网络安全防御——该计划致力于通过发现和修复高风险暴露点,免费保护关键公共基础设施。在早期的影响展示中,该模型发现了一个关键漏洞,该漏洞暴露了全球医院使用的医疗软件中的敏感个人信息,识别出此前前沿模型未能发现的严重风险。
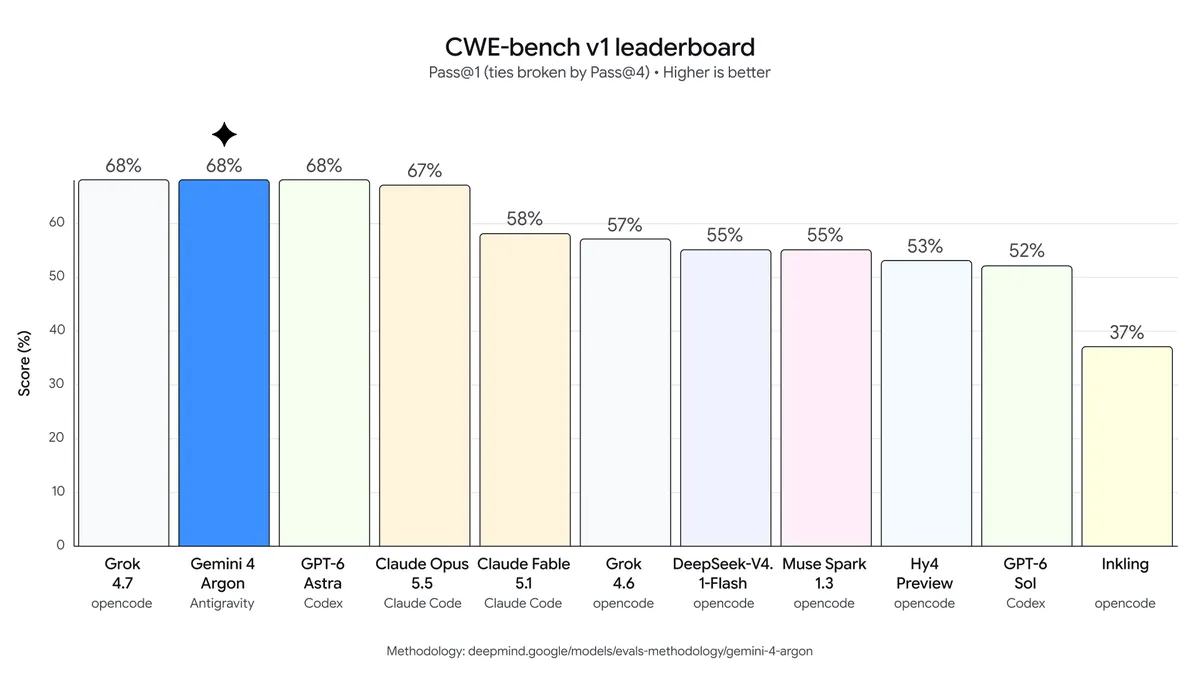
在CWE-bench v1上,该基准评估模型修复安全漏洞的能力,Argon以68%的最高分并列第一,基于3.8 Flash Cyber在CWE-bench v0上的前沿性能。
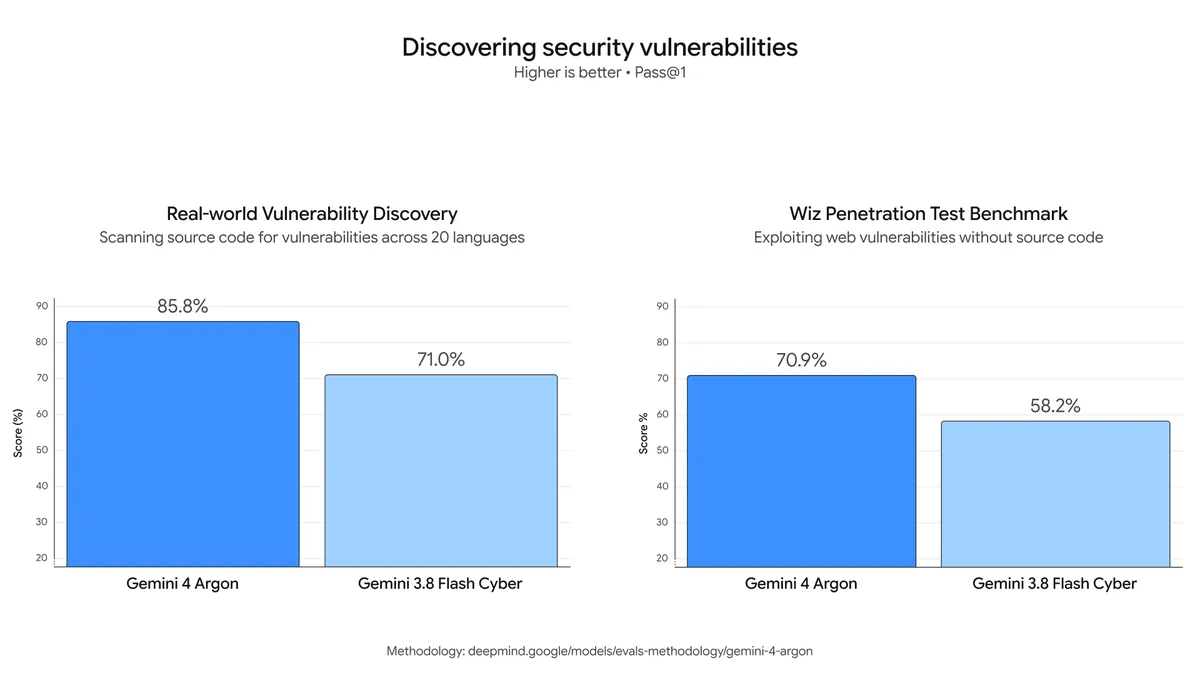
Gemini 4 Argon在漏洞发现方面相较于3.8 Flash Cyber展现了显著飞跃。例如:
在谷歌内部综合漏洞基准上,Argon在跨越20种编程语言的复杂代码库中发现了广泛的安全暴露。
在Wiz的内部黑盒渗透测试基准上,该基准测试模型在无源代码情况下分析实时Web系统的能力,Argon在发现攻击面、识别漏洞以及生成概念验证证据以验证漏洞方面均优于3.8 Flash Cyber。
在广泛可用前强化前沿安全防护
在广泛推出Gemini 4 Argon之前,我们正在继续强化四个关键领域的前沿安全防护:
防御滥用: 为防止恶意行为者利用Argon进行网络攻击或化学、生物、放射性和核(CBRN)攻击,该模型设计为拒绝有害请求,同时保留合法的双重用途科学研究,依据我们的前沿安全框架。我们正在加强此次发布的安全防护稳健性,包括改进技术以监控模型的内部激活来发现滥用迹象。这些安全防护经过内部和外部红队使用手动和自动化攻击方法相结合的稳健性测试。
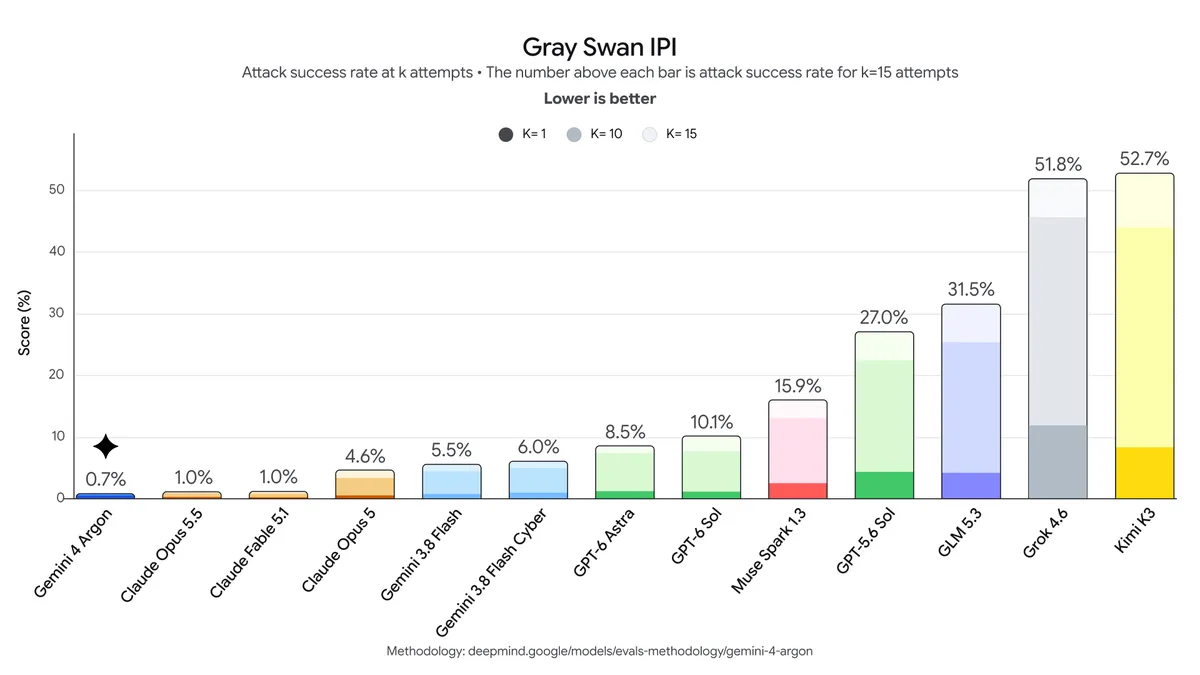
防御提示注入攻击: Argon也是我们迄今为止对间接提示注入最具韧性的模型,这类攻击利用恶意指令或上下文劫持模型行为。这些是复杂的攻击,需要持续警惕和多层防御。通过自动化红队对抗训练,Gemini 4 Argon在Gray Swan的间接提示注入(IPI)基准上引领提示注入稳健性。
监控错位: 为防止Argon越界以超出用户意图的方式完成任务,我们正在部署错位缓解措施,监控Argon的思维链和行动,并在必要时停止执行。
我们使用类似系统监控训练运行,并向专门的应急响应团队发送警报,同时采取谨慎预防措施,避免将发现反馈到训练中,以防塑造Argon的推理以规避我们的监控。我们强烈鼓励行业其他成员在能力增强的关键时刻保持推理透明度,同时应对对齐风险,以便模型思维在识别和诊断错位方面保持有用。
加固系统: 随着前沿模型能力不断增强,安全测试它们需要能够跟上系统本身的安全环境。根据我们的代理控制路线图,我们正在加固沙盒环境,在高风险训练或评估开始前进行隔离和密封。我们致力于与合作伙伴分享这些代理安全最佳实践,以提升整个生态系统的安全性。
即将推出
我们打造了 Gemini 4 Argon,它在编码、知识工作、网络安全防御和创意写作方面具备前沿级能力,旨在成为开发者、专业人士和企业应对最具挑战性难题时的合作伙伴。我们感谢首批网络防御者和可信测试人员,他们的真实评估和反馈将帮助我们在向开发者、企业和消费者发布之前强化系统,首批发布将面向付费 API 客户和 Google AI Ultra 订阅用户。
发布于: