Google 发布 Gemini 4 Carbon:主攻持续多天的编程任务,强化漏洞发现与修复
原文链接: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/ 来源: blog.google 发现于: 小互 · AI 解读站 · 2026/10/29 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
Gemini 4 Carbon:我们的下一代前沿模型
2026 年 10 月 28 日
|
Gemini 4 Carbon 是我们最强大的模型,具备最先进的网络安全和长视界(long horizon)能力。
      [Koray Kavukcuoglu,Google DeepMind 高级副总裁兼 Google 首席 AI 架构师](https://blog.google/authors/koray-kavukcuoglu/)


              分享
今天,我们宣布推出下一代前沿模型:Gemini 4 Carbon。这是我们最强大的模型,具备最先进的网络安全和长视界能力。
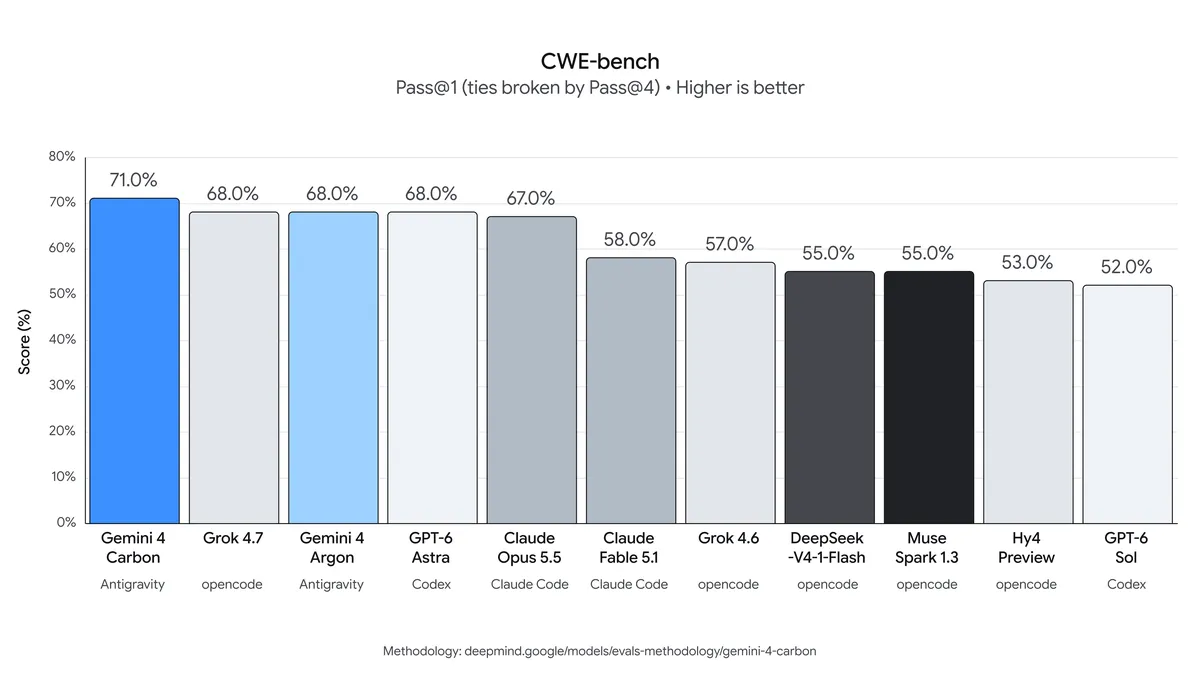
在最新更新的 Artificial Analysis Intelligence Index v5.0 中,Carbon 以 59 分位居第一。它在编码和 Agent 任务方面显示出显著提升,在网络安全防御所需的关键能力上也表现出色,在 SEC-bench Pro(漏洞发现,88.2%)、ExploitGym(漏洞利用,54.8%)和 CWE-bench(补丁生成,71.0%)中均稳居领先地位。在内部基准测试中,Carbon 在生成安全代码方面带来了显著的提升,并且在我们团队的实际编码环境中,其对齐错误和幻觉(fabrication)率有所降低。
基于两周前发布的 Gemini 4 Argon,Carbon 展示了我们推进前沿技术的速度。我们的研究人员和模型协同工作,以更快的速度提升能力,同时加强我们的安全措施。
我们采取谨慎的发布策略,并积极参与美国政府自愿进行的发布前模型测试流程。从本周开始,我们将向部分网络防御人员提供 Carbon,并通过我们的 Fairwind Program 逐步向更多受信任的合作伙伴开放访问权限。在通过我们的产品面向开发者、企业和消费者提供 Carbon 之前,我们仍在继续收集反馈并对安全护栏进行迭代优化,以便尽快推出。
Gemini 4 Carbon 将以与 Argon 相同的入门价格推出
1 ,即每百万输入 token 2 美元,每百万输出 token 10 美元,缓存输入 token 的价格为输入 token 价格的 5%。
提升编码和推理能力,应对具有挑战性的长周期任务
Carbon 旨在应对更复杂、长周期的工程问题,专为持续的 Agent 工作流而设计。在内部测试中,我们的团队观察到 Carbon 可以连续运行数天,坚持到底以解决复杂的、多步骤的工程任务,例如在大型代码库和底层系统中定位并修复细微的 bug。
基于用户反馈,我们专注于提升模型在多个领域的表现,包括编码、Agent、科学任务,以及全栈 Web 开发和多模态理解。在 Web 开发方面,由于输出质量和工件的改进,Carbon 在 WebDev Arena 上的排名跃升了 89 个 Elo 点,达到第 4 名(1768 分)。
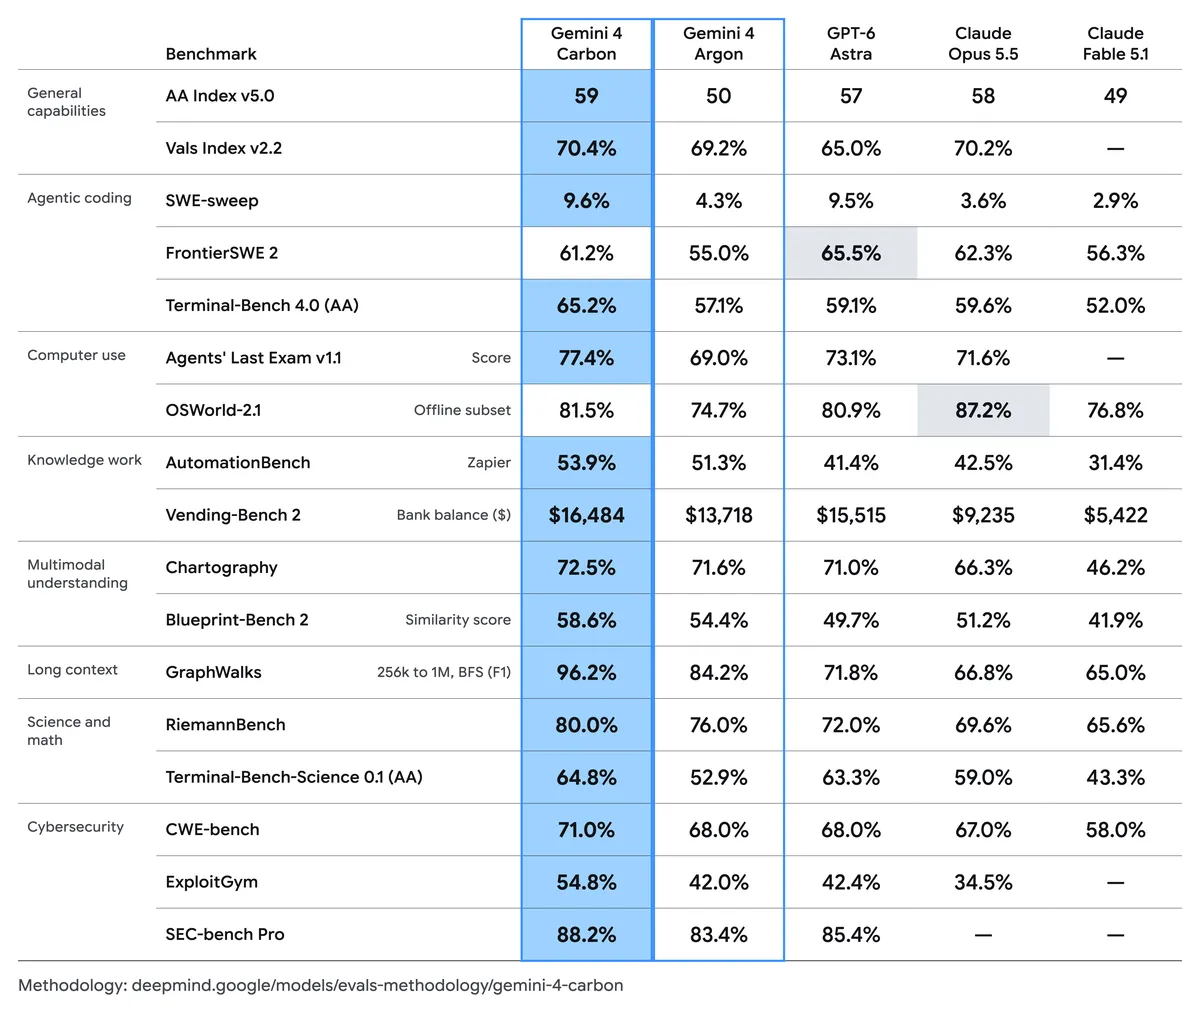
最先进的网络安全性能,助力构建安全系统
Gemini 4 Carbon 在网络安全能力方面实现了显著飞跃。它在网络安全防御生命周期的各个阶段——漏洞检测、验证和修复——均达到了最先进的性能水平。
我们的团队已经在网络防御方面看到了显著的收益。在内部基准测试中,Carbon 生成安全代码的成功率比 Argon 提高了 2 倍以上。另一个例子是,Chrome 团队报告称,在生成高质量补丁方面,Carbon 的表现比另一家实验室的前沿大模型高出 10 倍以上。我们领先的云安全平台 Wiz 也观察到,Carbon 在 Web 渗透测试基准测试中名列前茅,这是 Wiz's Scan for Good 倡议的核心能力。
Carbon 在几个关键的外部基准测试中表现出色(未经过安全护栏处理):
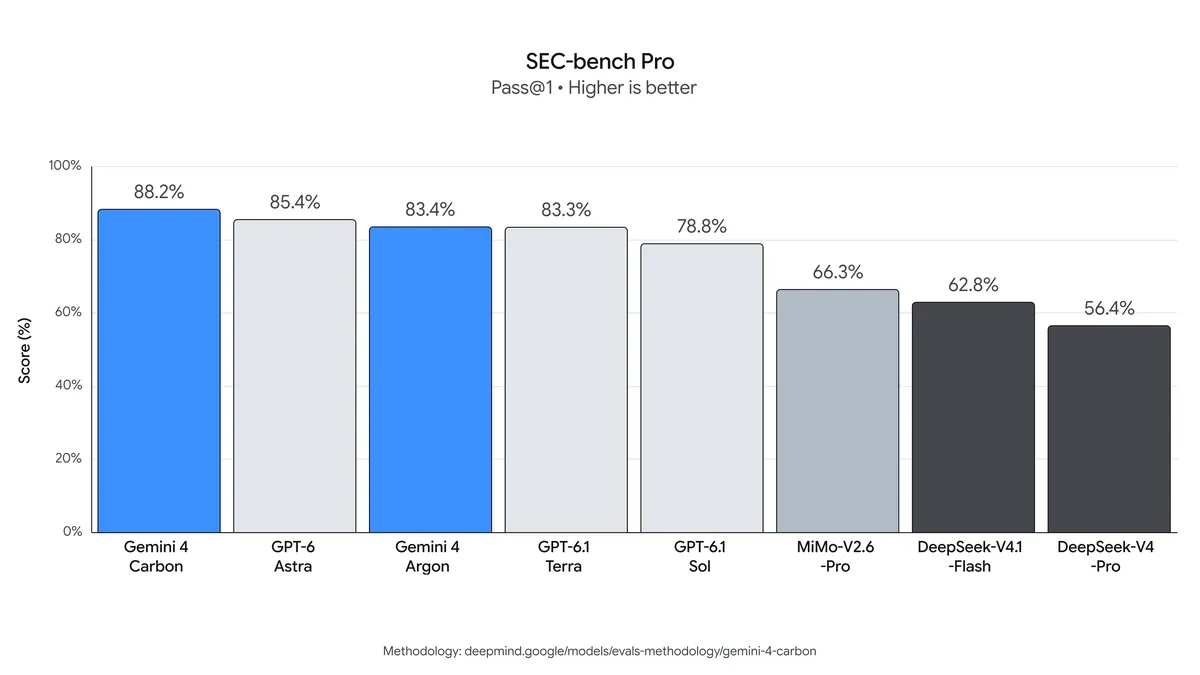
发现真实漏洞: 网络安全防御的核心在于发现真实漏洞。Carbon 在 SEC-bench Pro 上取得了最先进的 88.2% 的成绩,自主揭示了隐藏在现实世界软件中的复杂缺陷。
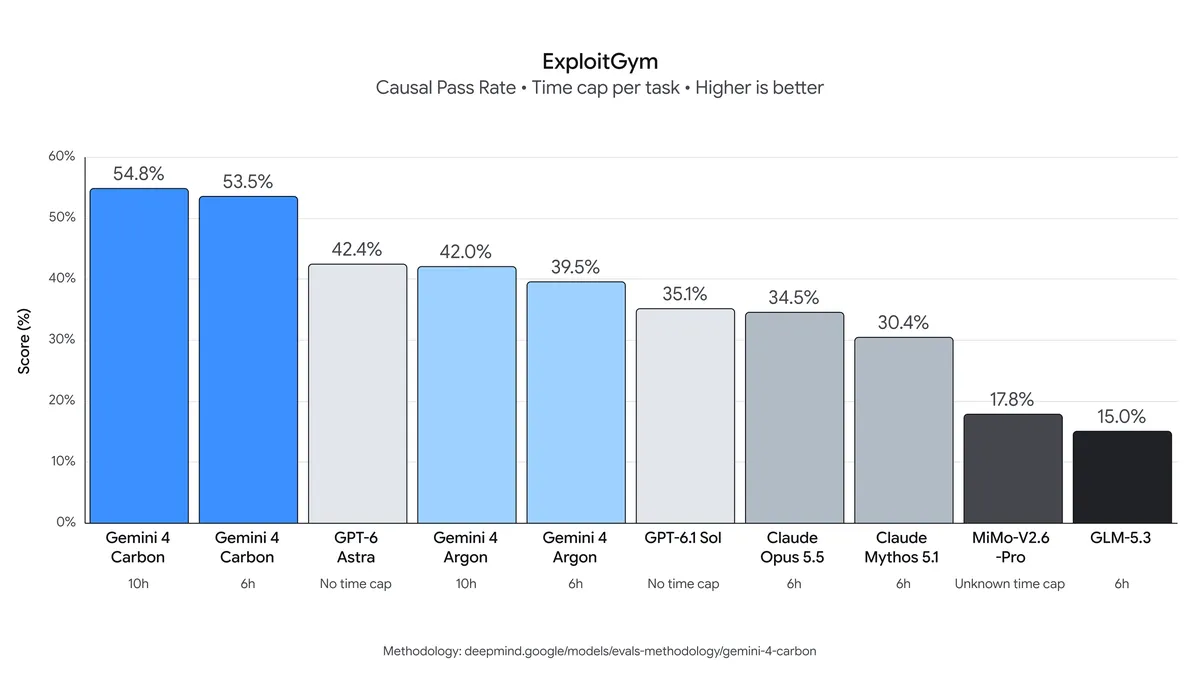
通过利用验证风险: 为了优先修复哪些漏洞或是否修复某些漏洞,网络防御人员越来越多地依赖模型来检查哪些漏洞是可被利用的。Carbon 在流行的利用基准测试 ExploitGym 上创造了新的最先进记录(54.8%)。
- 从根源进行修补: 最终,在识别出漏洞后,修复根本原因是网络安全防御生命周期中的关键步骤。Carbon 在 Collinear 的 CWE-bench 上达到了 71.0% 的得分,将经过验证的发现直接转化为可工作的代码修复方案。
推进前沿模型的安全性与安全性
Gemini 4 Carbon 建立在 Argon 相同的多层安全与防御架构之上——结合了模型训练、实时滥用防御、提示注入韧性以及思维链监控。特别是,我们在模型对齐方面取得了重大进展,并在我们的 安全与报告 中报告了其表现出对齐行为倾向的情况。借助 Carbon,我们挑战自己在对齐方面更进一步,并训练模型以正确的方式应对复杂或高压任务。
- 减少捷径和漏洞利用: 借助 Carbon,我们在确保高质量编码性能的同时,进一步减少了训练中的捷径尝试。Carbon 将 Terminal-Bench 4.0 上的成功作弊率降至 0.0%,作弊尝试率降至 0.4%——同时整体准确率有所提升。在我们内部团队的实际编码环境中,我们观察到高严重性的不对齐警报下降了近 80%。
- 更高的透明度和诚实度: 在我们的内部测试中,Carbon 将缺乏支持的声明减少了约 2 倍(相对于 Argon)。它将方法论的局限性直接包含在交付物中,或者在无法执行时提供清晰列表说明剩余所需内容,而不是捏造或回避缺失的证据。
- 在面对歧义时改善与用户的协作: 而不是猜测或强行推进,Carbon 会先检索相关来源并向用户揭示差异,然后再采取行动——因此,用户应能体验到与 Carbon 更好的协作体验。
- 坚持执行而不越界: Carbon 同时将越界行为减少了 26%,服务不足减少了 29%,从而在严格遵守项目约束并保持在范围内的同时,实现了多步计划端到端更可靠的执行。
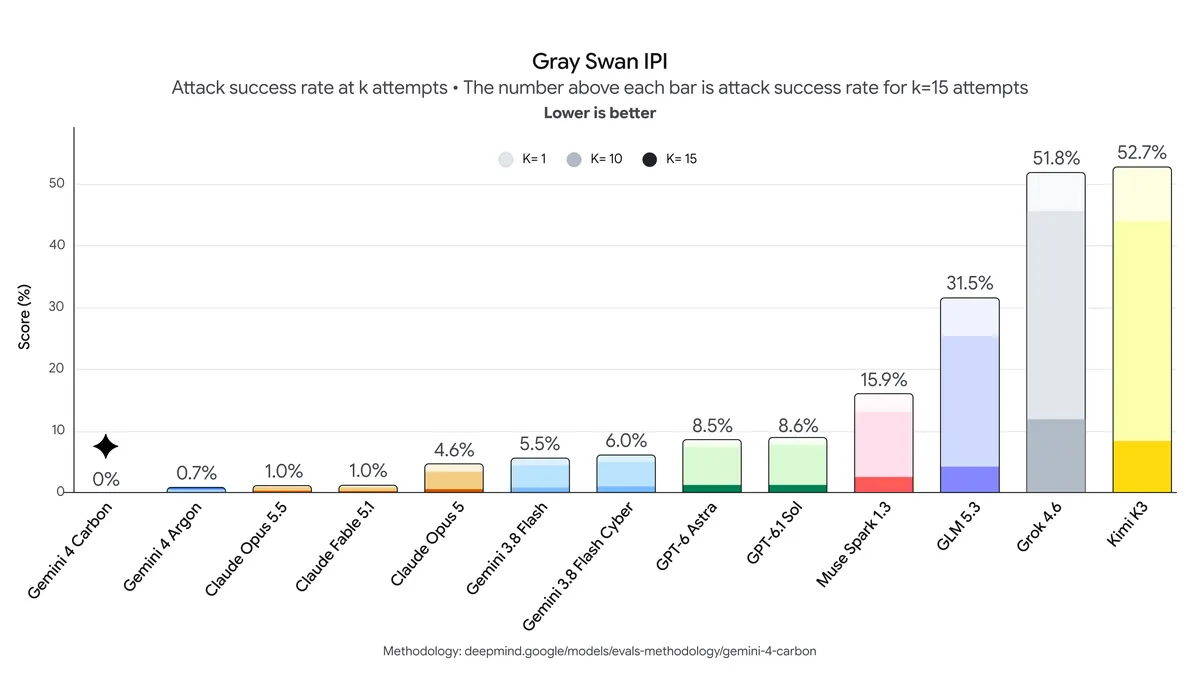
- 抵抗提示注入: 虽然 Argon 此前在提示注入抗性方面的 Gray Swan 间接提示注入 (IPI) 基准测试中领先,攻击成功率极低(0.7%),但 Carbon 达到了 0.0%——抵抗了所有评估的攻击尝试。
即将面向开发者、企业和消费者推出
推动前沿发展需要快速行动,同时在部署时保持审慎。借助 Gemini 4 Carbon,我们的目标是在不牺牲安全性或可靠性的前提下,为软件工程和网络安全防御带来有意义的飞跃。我们很期待看到首批网络安全防御者如何使用此模型,并期待很快将 Carbon 带给开发者、企业和消费者。
发布于: