Google 发布 Gemini 4 Neon 模型:由旗舰 Carbon 蒸馏而来 编程 Agent 榜第一 智能指数 61 分排总榜第 3
原文链接: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ 来源: blog.google 发现于: 小互 · AI 解读站 · 2026/11/19 说明: 本文由 AIHot汪 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
介绍 Gemini 4 Neon
2026 年 11 月 18 日
|
将前沿级智能与快速端到端任务完成能力相结合,适用于复杂的软件工程、知识工作和科学工作流。
      [Koray Kavukcuoglu,Google DeepMind 高级副总裁兼 Google 首席 AI 架构师](https://blog.google/authors/koray-kavukcuoglu/)


              分享
本文目录
今天,我们推出 Gemini 4 Neon —— 将前沿级智能与快速端到端任务完成能力相结合,适用于复杂的软件工程、知识工作和科学工作流。
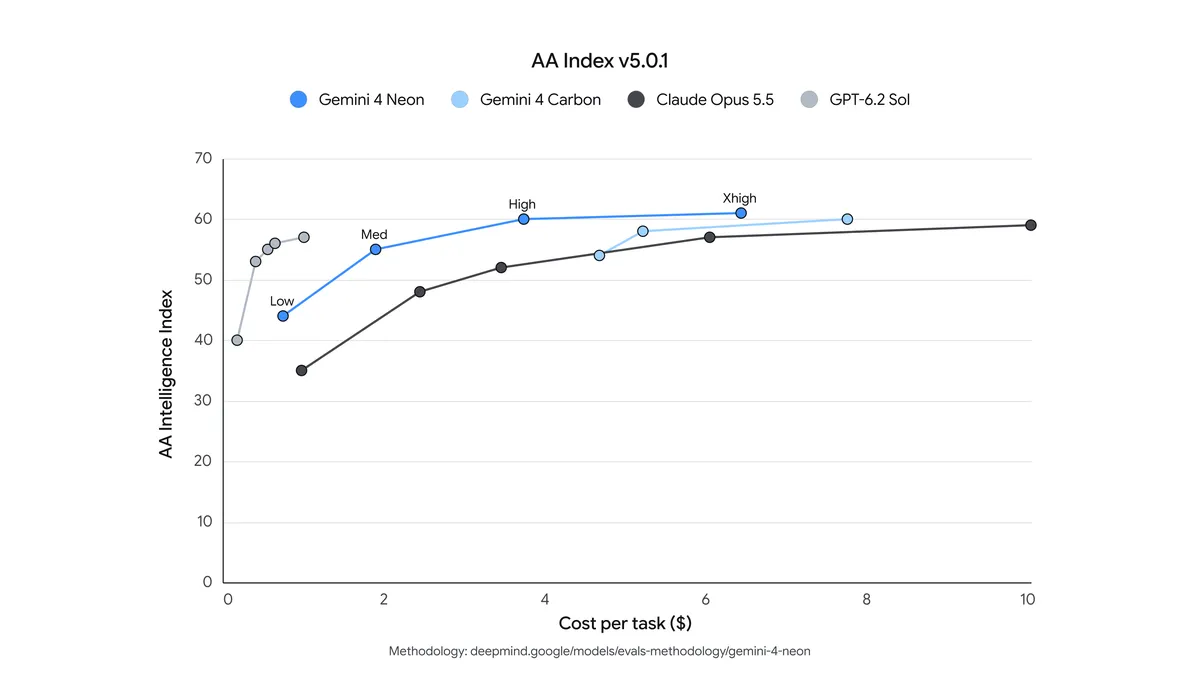
在 Artificial Analysis Intelligence Index 的 xhigh 思考级别下,Neon 的综合得分为 61 分,在同类模型中名列前茅,总体排名第三,仅略低于更大、更慢的模型。在 Vals Index 上,Neon 排名第二,并位于帕累托前沿(Pareto frontier)。除了不断提升模型的基础能力外,我们还在持续优化模型的人机协作体验。在新发布的 Agent Arena Index 中,Neon 在“可引导性”(steerability,即适应任务中途用户修正的能力)方面排名第二。Neon 在多步指令遵循方面表现出色,并基于我们在减少幻觉(fabrication)方面的持续进展,在 Google 内部 Antigravity 测试中创下了最低的幻觉率。
该模型的定价为每百万输入 token 3 美元(每百万缓存输入 token 0.15 美元,折扣率为 95%),每百万输出 token 15 美元,上下文窗口为 100 万 token。
Gemini 4 Neon 今天开始在 Gemini API 中推出,适用于 Google AI Studio、Gemini for business(通过 API 和模型下拉菜单)、Google Antigravity 中的付费 Google AI Pro 和 Ultra 订阅者,以及 Gemini app 中的 Pro 和 Ultra 订阅者。
在企业、分析和科学工作中表现出色
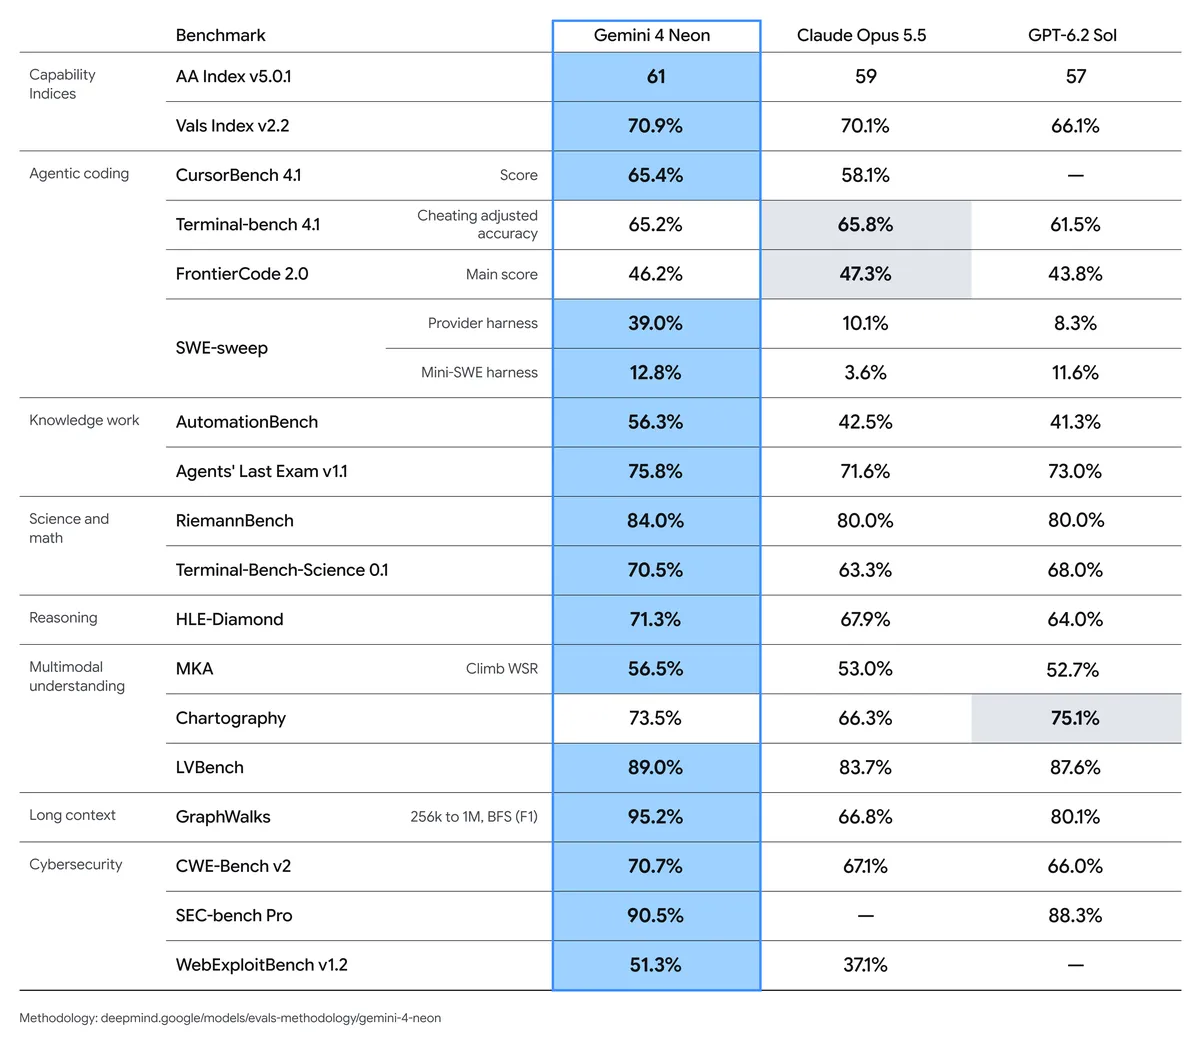
企业工作涉及电子表格、PDF、图表、音频和视频。Neon 能够在单个 100 万 token 的上下文窗口中综合处理所有这些输入,并将输入转化为结构化的交付成果。独立评估将 Neon 评为顶级模型之一,在 Vals Index 等基准测试中排名 #2(70.9%),并在 Legal Research Bench 和 Tax Agent Bench 上均达到 #1。
Neon 在 Surge AI 的多个类别中也表现出色,在金融、会计、电子表格建模和复杂约束遵循方面的多数基准测试中排名 #1。它在 Chartography 上阅读密集的专业图表得分为 73.5%,并在 Agents' Last Exam v1.1(75.8%)上的表现与领先模型相当。在 Zapier 的 AutomationBench(56.3%)和 Andon Labs' Vending-Bench 2($16,843,模拟长期运营企业的基准)上,Neon 均获得整体 #1。最后,它在 Arena's new Agent Arena Index 上以 1336 分在全球排名 #2,该指数基于 4,200 多个真实世界的 agent 会话。
在涵盖定量分析、数学和技术研究问题的科学和数学推理方面,Neon 在 Terminal-Bench Science(70.5%)、RiemannBench(84.0%)和 HLE-Diamond(71.3%)上均处于同类最佳水平。
专为生产就绪的代码打造
Neon 专为长期运行的 agent 工作流而设计,能够在复杂且重度依赖工具的任务中从头到尾维持性能——无论是独立运行,还是作为快速且具有高判断力的 Orchestrator,在 Google Antigravity 中指挥并行的 Hydrogen 子 agent。它减少了冗余的文件读取,在操作过程中共享进度,并在长会话中可靠地处理上下文压缩。
在核心开发者和研究人员的工作流中,Neon 实现了前沿性能,并与同类中的领先模型具有竞争力,在 Artificial Analysis Coding Agent Index(58.6)上总体排名 #1,在 Terminal-Bench 4.1 上得分为 65.2%,在 FrontierCode 2.0 上得分为 46.2%(默认高设置)。对于生产就绪的代码,Neon 能够针对仓库中的多文件调试和重构进行精准、外科手术式的编辑。在 SWE-sweep 上,它已经在 mini-SWE harness 上领先(12.8%),并在 Google Antigravity 中将分数提升至创纪录的 39.0%,展示了 Antigravity harness 所释放的潜力。
在 Google Antigravity 中,Gemini 4 Neon 使用 /swarm 驱动 Blender MCP,构建了一个照片级真实的 3D 实验室工作台,精确展示了模型名称,并为 Gemini 4 Carbon 和 Gemini 4 Hydrogen 搭配本生灯火焰,为 Gemini 4 Argon 和 Neon 搭配高压气体放电管。
在 Google Antigravity 中,Gemini 4 Neon 从零开始编写了一个第一人称 WebGL2 自由滑雪模拟器,基于真实的勃朗峰(Mont Blanc)和夏蒙尼(Chamonix)高程地形——结合了 10,200 行自定义着色器、六个高山路线上的 120 Hz 滑雪物理引擎、动态刻痕轨迹、板状雪崩以及空间 Web 音频,且未使用任何预制资产。
在 Google Antigravity 中,使用 /swarm,Gemini 4 Neon 提取档案照片,以交互式 3D 形式重现了艾伦·图灵(Alan Turing)1936 年在剑桥国王学院的学习场景——从国王学院教堂外部到内部的 Room X.8,桌上还有一台正在运行的通用图灵机。
在 Google Antigravity 中,一个 Gemini 4 Neon 智能体集群将单张图片转换为包含 100,000 个单元格的 Google Sheet,未嵌入任何图片,也未使用 Apps Script——而是利用超过 500,000 个实时电子表格公式,在六种交互模式下执行边缘检测、映射 3D 深度并重新打光场景。
为生产级工作流带来效率与控制
我们通过每次新模型发布来优化思维层级,为团队提供更精细的控制和更平滑的层级过渡。Neon 的四个层级稳步扩展,让团队能够根据每项工作负载的需求调整智能水平和 token 消耗。
Neon 在第三方基准测试中以更低的任务成本提供高性能。在其默认的高思维层级下,它拥有较高的 Artificial Analysis Intelligence Index 评分,且任务成本比 Carbon 低 32%。在 Vals 指数和 Agent Arena 的高层级上,它也处于帕累托前沿(Pareto frontier),任务成本比顶级竞争前沿模型低约 50% 至 80%。xhigh 思维层级增加了更深层的多步推理能力,适用于最复杂的工程、分析和科学工作负载。Neon 在此层级展现出最高的智能评分,同时任务成本仍比竞争模型在其最高设置下低 36% 以上。
专为快速、低成本的前沿级网络安全而构建
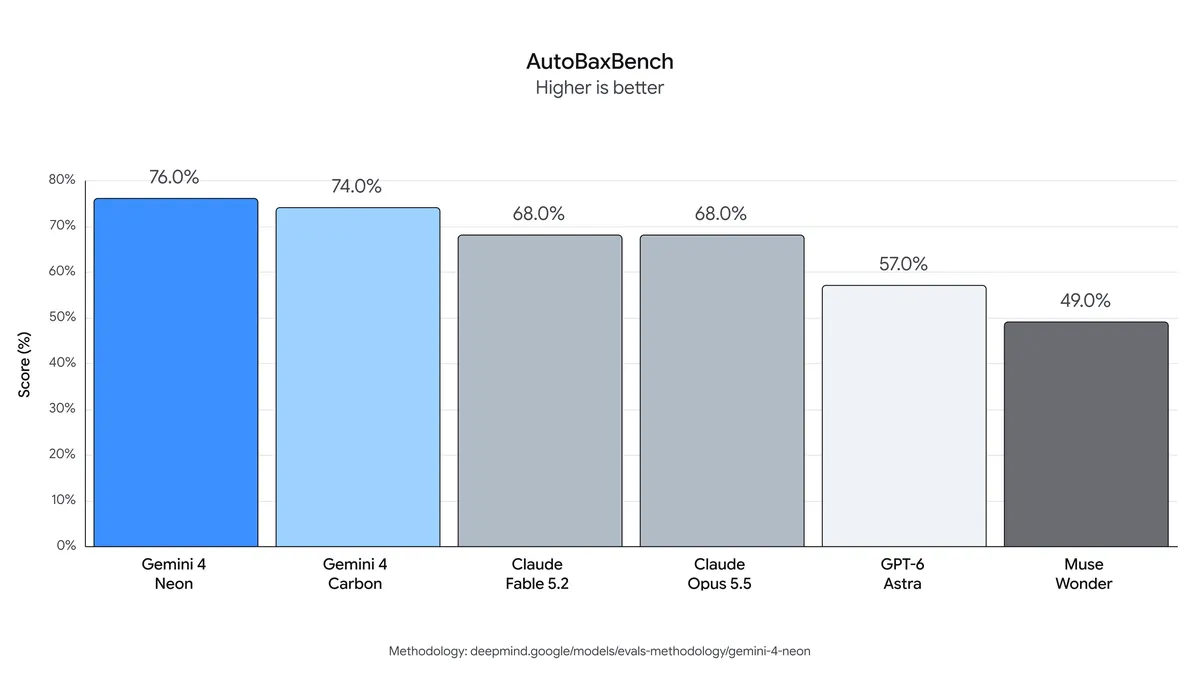
随着智能体编码规模的扩大,从一开始就生成安全代码至关重要。Gemini 4 Neon 在 AutoBaxBench 的所有简单、中等和困难挑战中,生成的安全代码比 Carbon 更多,并在困难层级(76%)达到最先进水平(state-of-the-art)。
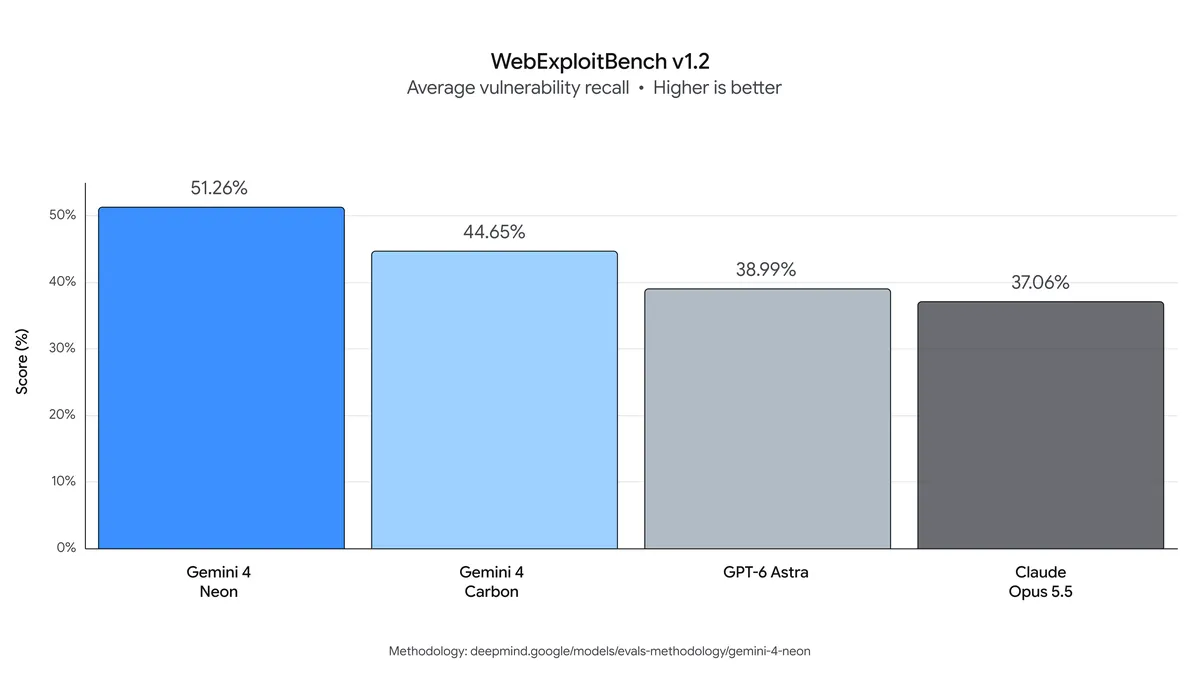
保障系统安全也意味着在攻击者之前主动发现漏洞。渗透测试一直是企业网络安全的基石。在 WebExploitBench v1.2 上,Neon 以竞争大型模型一半的成本达到了最先进水平(51.26%)。
为了加固现有代码,Neon for cyber 在代码加固生命周期——漏洞发现、验证和修补——中提供前沿级性能,同时比大型前沿模型更快、更具成本效益。
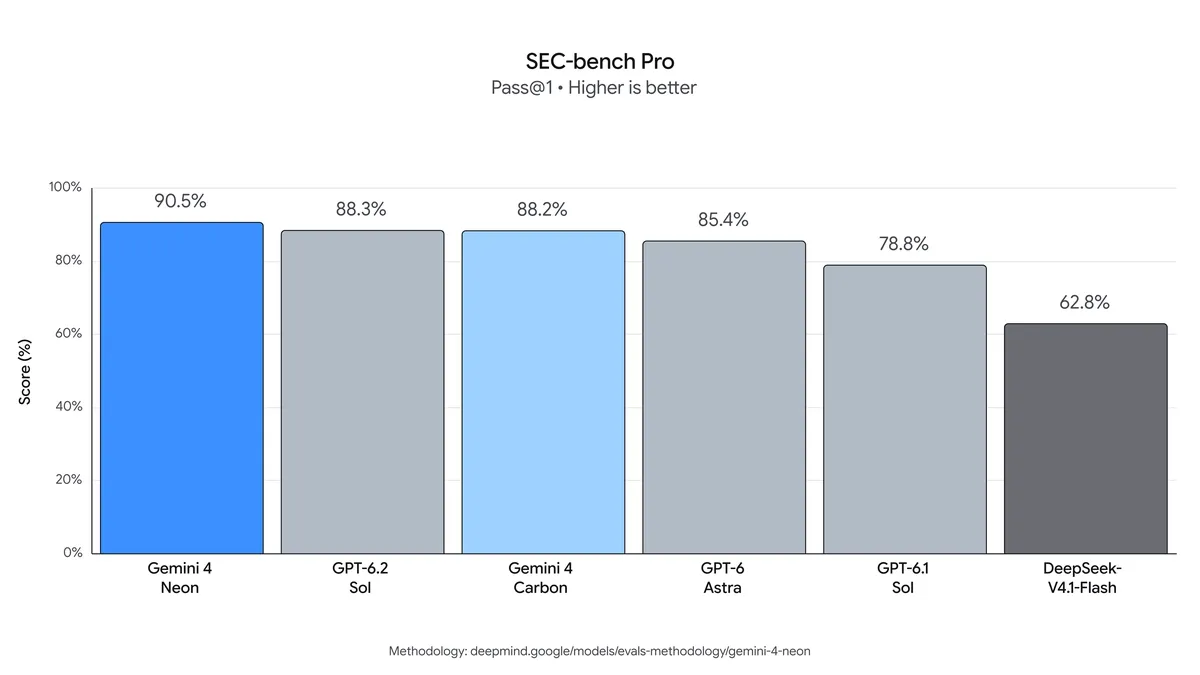
- 发现代码漏洞: Neon 在 SEC-bench Pro 上取得了最先进的性能(90.5%),而每个挑战的成本仅为 Carbon 的一半左右。
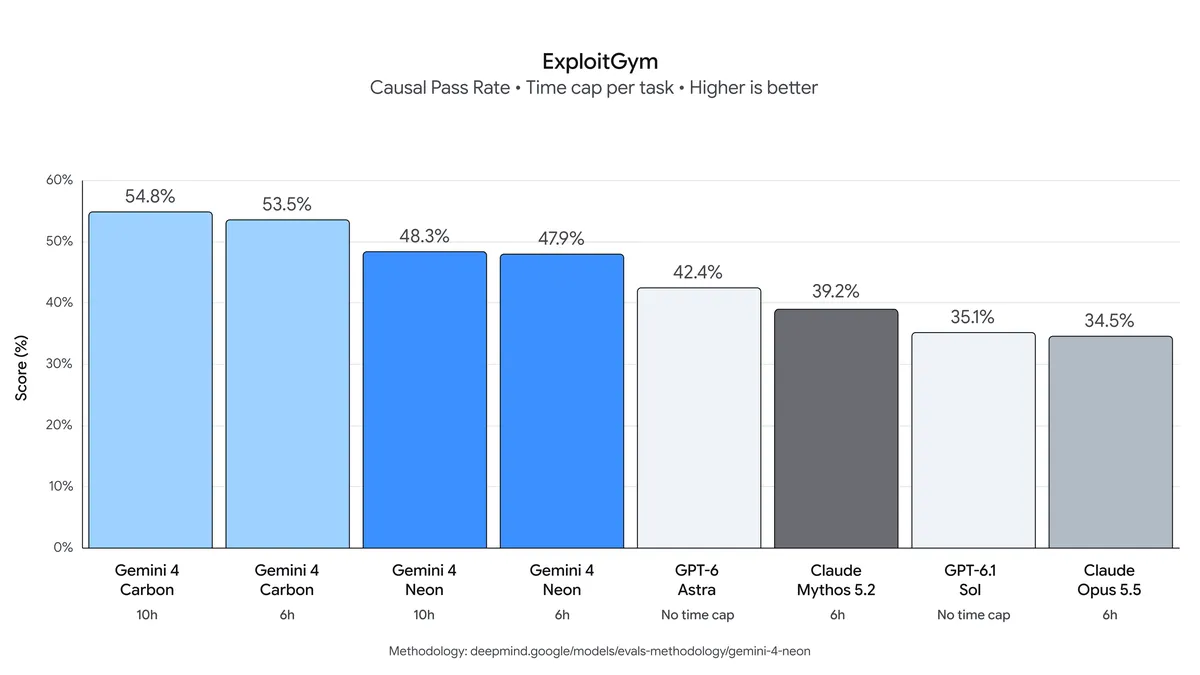
- 通过利用验证风险: 为了优先修复哪些漏洞,防御者依赖模型来检查哪些漏洞是可被利用的。在 ExploitGym 上,它使用 Carbon 一半的 token 数实现了前沿水平的性能。
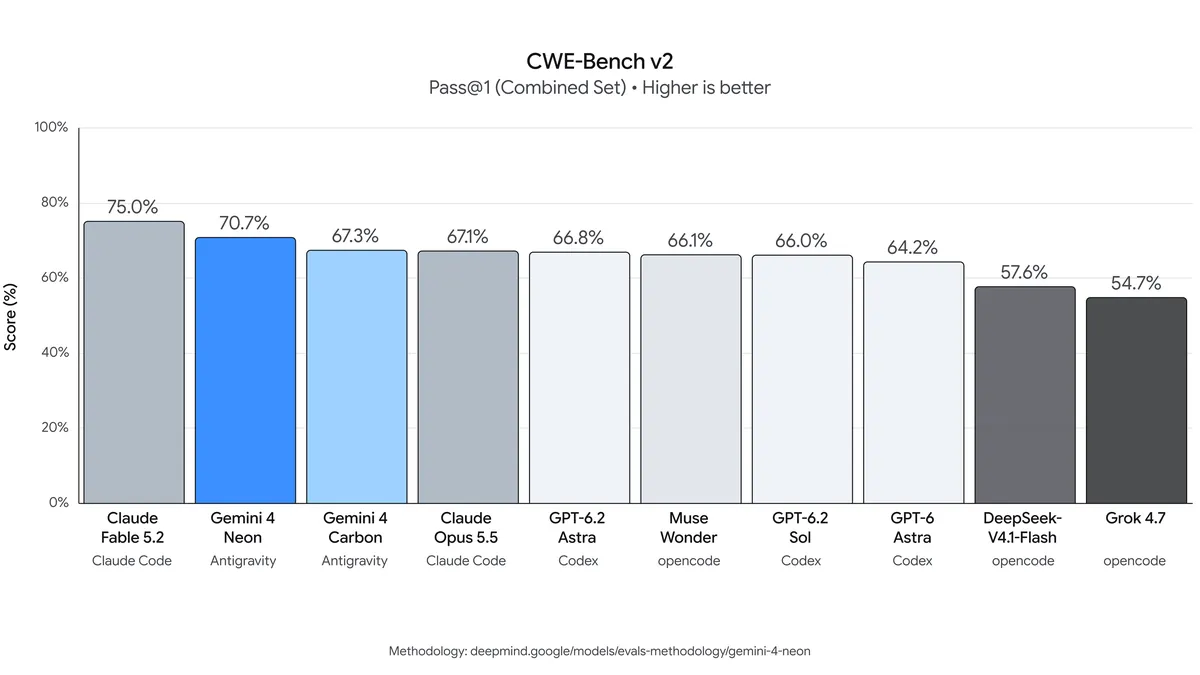
- 修补漏洞: 修复漏洞的根本原因是网络安全防御生命周期中的关键步骤。Neon 在 Collinear 的 CWE-bench v2 上达到了 70.7%,比 Carbon 提升了 3.4%。
Gemini 4 Neon for cyber 将在未来几天作为 Fairwind Program 的一部分向受信任的防御者推出。
旨在安全、可靠的执行
Gemini 4 Neon 建立在我们的 Gemini 4 安全与防护堆栈 的改进之上——在保持与 Gemini 4 Carbon 级别的对严重滥用和提示注入的防护的同时,进一步提升了模型对齐和 Agent 行为。对于旨在在生产环境中执行繁重、长时间运行的工作的模型,我们专注于:
- 缓解前沿滥用安全风险: 由于 Neon 将前沿级别的能力带入了更快、成本更低的模型,我们为其配备了强大的实时防护,以应对网络和生物安全滥用,其防护力度可与 Carbon 的防护相媲美,同时大幅减少了在这些领域拒绝合法工作的情况。例如,在 Terminal-Bench 4.0 上仅拒绝 1.98% 的任务,在 Terminal-Bench-Science 上拒绝率为 0%。
- 提升对齐和规范的模型行为: 在内部编码使用中,来自我们思维链和行动不对齐监控器的警报率保持在 Carbon 设定的极低基线之下,这表明 Neon 的对齐倾向有所改善——并且该监控器也被部署用于在外部表面上保护 Neon。Neon 经过训练,能够完成多步工作而不走捷径、不伪造结果或不越界——继续在按要求完成任务和保持在范围内之间取得更好的平衡。在 Terminal-Bench 4.0 上,Neon 的作弊率为 0.0%,与 Carbon 持平;在我们的编码作弊评估中,仅在 2.45% 的任务中走捷径(这是任何 Gemini 4 模型中最低的比率)。在我们的 Agent 安全套件中,它的不对齐行动率为 0.09%,在 Agent 诚实度评估中通过率为 99.2%。 在我们的 Agent 行为评估中,Neon 在 Carbon 的强大基线基础上,进一步将不同努力水平下的服务不足减少了 43%–56%,将越界行为减少了 15%–35%。
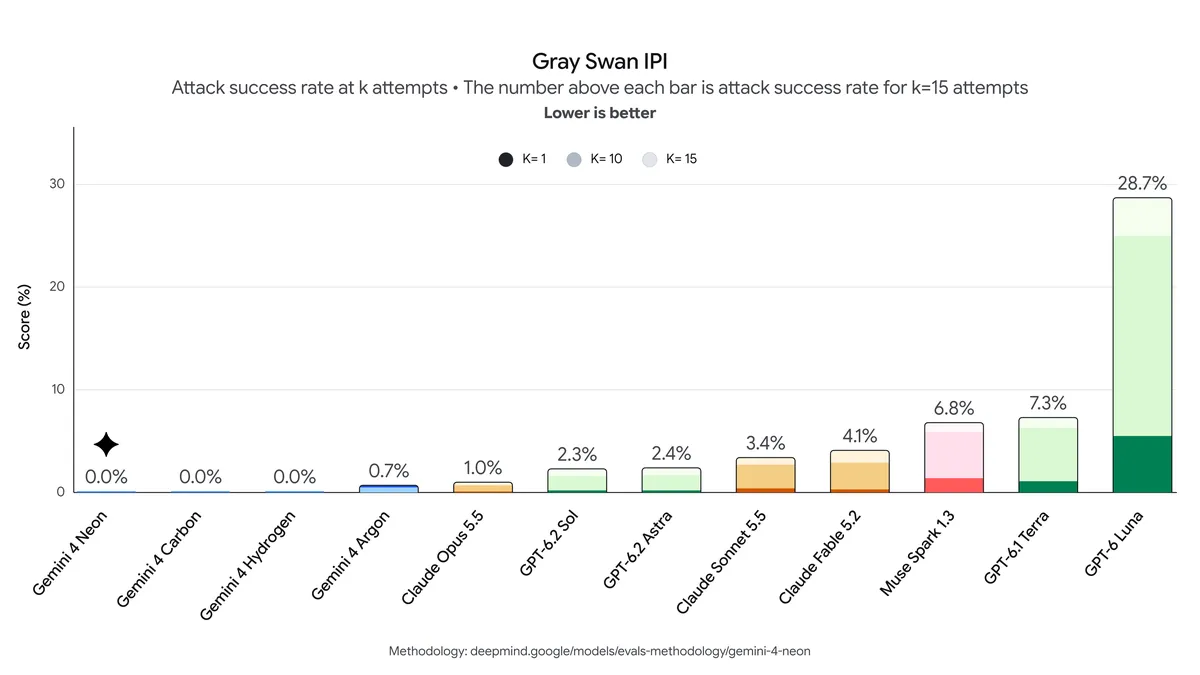
- 保护用户免受间接提示注入攻击: 在 Gray Swan 的 IPI 基准测试中,当恶意指令被植入它访问的网页、电子邮件、文档或代码中时,Neon 比同类其他模型更具韧性。我们发现,在其最高思考级别启用实时防护时,Neon 抵御了 Gray Swan 基准测试中的所有攻击,达到了与其他 Gemini 模型相同的 0.0% 攻击成功率。
发布于: