GitHub 为AI重造 Git 存储:怎样让 5,000 个 Agent 同时使用一个代码仓库
原文链接: https://github.blog/engineering/architecture-optimization/inside-githubs-new-git-storage-architecture/ 来源: github.blog 发现于: 小互 · AI 解读站 · 2026/11/6 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
		2026年11月5日


			|

			16 分钟
分享:
上周在 GitHub Universe 大会上,我们发布了全新的 Git 存储架构,它能够处理每秒数千次写入,同时读取可按需扩展。通过内部测试,我们验证了支持 5,000 个并发 Agent 在同一仓库上工作、每秒向单个仓库发送 7,200 次 push 的能力,并且在此期间始终以持续的低延迟响应读流量。这套新架构是 GitHub 支持数亿开发者进行 agentic 开发的基础,而我们是在 GitHub 持续运行的同时,在其底层逐步构建这套架构的。
在过去一年里,Agent 改变了 GitHub 上繁忙仓库的样貌。在本系列第一篇文章中,我们阐述了下一代 Git 存储架构背后的两个原则:最大限度减少协调(minimize coordination),以及存储与计算解耦。在上一篇文章中,我们介绍了过渡桥梁:将 99.99999% 的仓库迁移至 Azure,把 write quorum 的范围缩小到单个引用(reference),以及搭建由 Azure Blob Storage 支持的虚拟副本(virtual replicas)。
我们还在文末留下了一个观察结论:一次写入中需要保证顺序的部分非常少。Git 对象是不可变的,并且以其内容命名,这意味着两个写入方可以同时存储对象,而无需就任何事情达成一致。push 中真正需要达成一致的部分是引用更新(reference update),而与整体相比,引用更新的量级非常小。虚拟副本正是围绕这一点进行构建的第一步,也是我们将仓库接入新架构的方式。
架构的其余部分正是建立在这一观察之上。只有引用更新需要达成一致。这使得过去紧密耦合的 Git 基础设施的各个部分(存储数据、响应请求和维护仓库)得以独立扩展。对开发者而言,Git 依然是 Git:他们以相同的方式 push、fetch 和创建分支,同样的保护机制也依然在位。在下文中,我们将介绍该设计背后的需求,跟踪一个请求在系统中的流转过程,并深入剖析其中两个组件。
面向 Agent 规模的构建
我们从两个维度来衡量 GitHub 平台的规模:
- **水平扩展(Horizontal scale)**指的是有多少开发者和 Agent 可以在多个仓库中协作。GitHub 目前在该维度上的许多方法经过多年的实战检验,并延续到了新架构中:跨基础设施的客户区分片、客户流量的隔离和/或公平性保障,以及感知负载的路由,仅举几例。
- 垂直扩展(Vertical scale)指的是有多少开发者和 Agent 可以在单个仓库中协作。随着 Agent 编写越来越多的代码,我们预计单个仓库会变大且更繁忙,因此我们的大部分需求来自垂直维度。
目前,GitHub.com 上最繁忙的仓库每秒接收的写入操作最多只有几十次,通常以短促的突发形式出现。随着更多工作转移到并行运行且全天候工作的 Agent 身上,我们预计这些突发流量将在未来一年内转变为持续速率。每次推送都会导致更多的读取:CI 运行、部署系统拉取新提交,以及其他 Agent 获取它作为上下文。这种读取扇出效应对整体流量产生了巨大的放大作用,且该效应随写入量的增加而扩展。
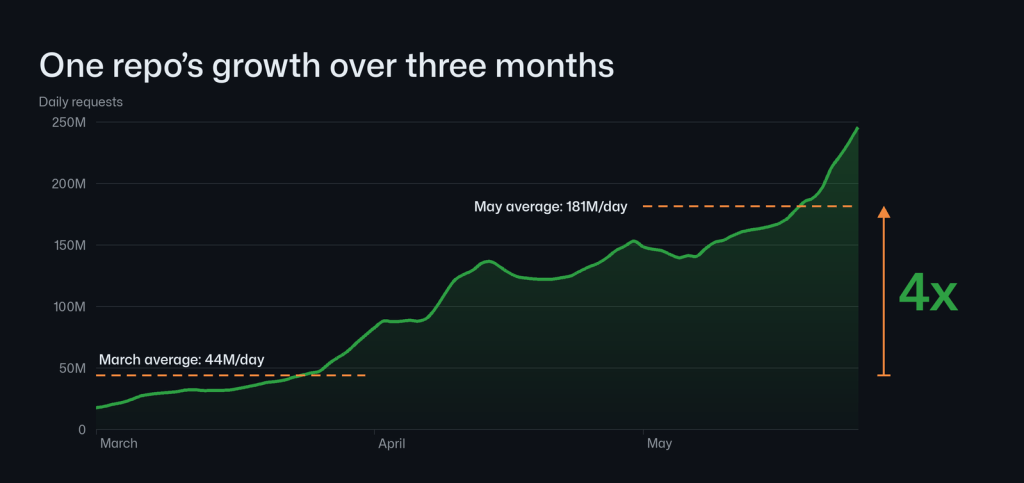
我们已经在曲线顶端的仓库中看到了这一趋势。下图显示了 2026 年 3 月至 5 月期间 GitHub 上单个仓库的每日请求量,其流量增长了约 4 倍。此后,其增长一直呈指数轨迹。
我们必须为 Agent 驱动的开发以这种速度持续加速的世界做好准备。我们没有为下一个增量做准备,而是设定了至少两个数量级更大规模的目标。对于单个仓库而言,这意味着新架构需要:
- 接受每秒数千次写入。
- 支持多个写入节点。这样做有两个原因:
- 经验告诉我们,索引传入的 pack 数据并检查对象连通性是写入过程中最耗 CPU 的部分,且该成本随写入大小的增加而扩展,因此单个节点很快就会成为计算瓶颈。
- 将工作分散到多个节点可以提高容错能力,并在节点故障时缩短恢复时间。
- 最小化提交延迟。Agent 在每次推送后等待,然后才能进行下一步操作。
- 按顺序记录每个引用(reference)的更改,并具备跨引用快速线性化的能力。落后于进度的虚拟副本需要通过仅下载满足传入请求所需的数据来追赶。
- 在没有任何更改时保持读取成本低廉,鉴于读/写比例,这是常见情况。
- 让每个组件独立扩展。
此外,系统还必须能够提高整体可靠性并实现全球扩展。
介绍“Rubicon 项目”
2026 年 5 月,在初始 Azure 迁移之后不久,我们开始设计能够满足这些需求的方案。我们尝试了几种方法。在所有方案中,pack 数据都存储在 Azure Blob Storage 中,在某些方案中,我们还尝试将引用状态也存储在那里。我们将在下面介绍我们发现的一些权衡,但最终我们确定了一个我们认为在保持 GitHub 等平台所需的正确性、持久性、可用性和延迟保证的同时最大化吞吐量的设计。我们将其命名为“Rubicon”,以此致敬行业在 Agent 开发中跨越的不归点。
让我们自顶向下梳理 Rubicon 的设计。许多部分保持不变:来自 Git 客户端、API 和 Web UI 的请求到达 Spokes,Spokes 仍然负责路由和负载均衡,并提供 GitHub 其余部分用于读取和写入仓库数据所需的内部 API。Spokes 还保持其作为放置和平衡服务的角色,维护水平扩展所需的分区、隔离和客户公平性。相比之下,Spokes 下方的数据平面是全新的。
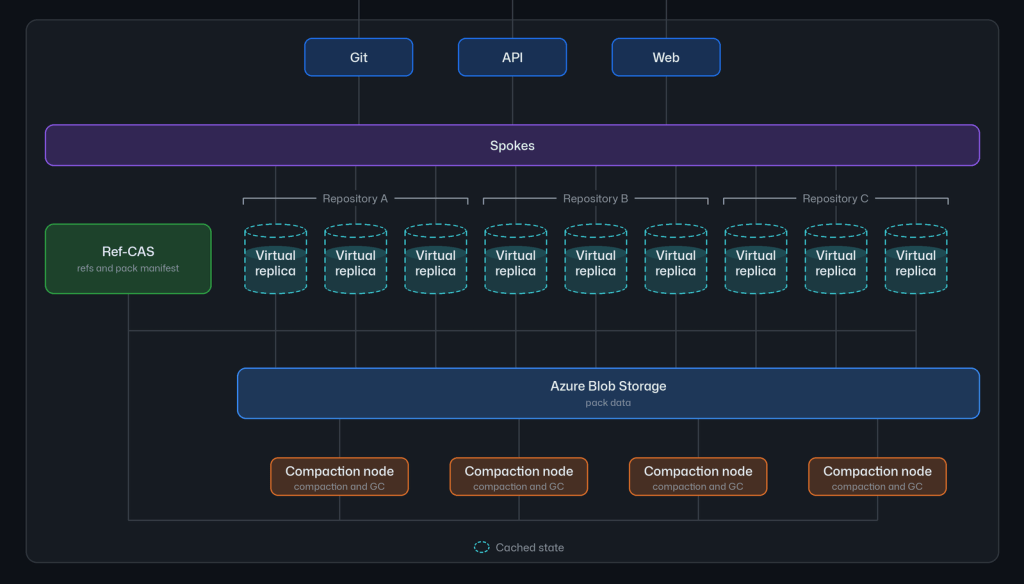
Spokes 将每个请求路由到分配给该仓库的一小部分虚拟副本。虚拟副本是一个统一的、可丢弃的计算集群,用于处理读取、写入或两者兼有。虚拟副本的本地磁盘是一个缓存,可以随时重建。
Spokes 在可能的情况下将仓库的流量路由到相同的虚拟副本,从而保持其缓存命中并降低延迟,但正确性并不依赖于请求落在任何特定的虚拟副本上。当某个虚拟副本失效时,该仓库的其他虚拟副本会继续提供服务,而新替换的虚拟副本会随着流量到达逐步填充其缓存。
当仓库变得繁忙时,我们会增加更多的虚拟副本。与此同时,一组压缩节点在后台工作,直接与 Blob Storage 和 Ref-CAS 交互,以合并每个仓库的包并移除不可达的对象。这项工作从不运行在虚拟副本上,这意味着虚拟副本的 CPU 和内存可以几乎完全 dedicated 用于处理请求。
持久化状态存在于两个地方:
- Git 对象,以包和辅助读取加速数据的形式,存储在 Azure Blob Storage 中。
- 引用(References) 和构成仓库的包列表(即包清单)存储在一个我们称为 Ref-CAS(Reference Compare-and-Swap,引用比较并交换)的独立复制日志服务中。
让我们从写入和读取的角度来梳理架构:
- 写入: 虚拟副本对传入的包建立索引,将其上传到 Blob Storage,然后向 Ref-CAS 提交一个事务,该事务在清单中列出包并更新引用。随后,压缩节点将该包与其他包合并,以保持读取速度。
- 读取: 虚拟副本通过 Ref-CAS 检查其引用版本,从 Blob Storage 拉取所需的包到其缓存中,并从中提供读取服务。
在新架构中,我们采取了多种不同的方法,从虚拟副本上的软件栈,到如何针对不同的用例(例如,许多小仓库与一个大仓库)调整流量路由和工作负载调度。让我们深入探讨架构中的两个组件,并围绕两个设计原则讲述它们的故事。
最小化协调:以高吞吐量修改引用状态
像 Azure Blob Storage 这样的对象存储服务在其擅长的领域表现出色,非常适合源代码存储等许多数据密集型应用。它们具备持久性和复制能力,能够存储我们所需的一切,每字节成本相对较低,并且只要流量分散在许多键上,就能提供极高的聚合吞吐量。因此,新的 Git 存储架构中几乎所有持久化数据都存储在 Azure Blob Storage 中,包括:
- 由推送、压缩和垃圾回收写入的包和索引。
- 各种读取加速器(如多包索引、可达性位图和一些自定义格式),我们的维护进程基于这些包构建它们。
- 允许压缩和垃圾回收恢复或审计其工作的记录,以及压缩节点用于认领工作的租约(leases)。
- 频繁重复的获取操作的缓存响应。
- 仓库引用状态的检查点,尽管这不是用于服务请求的权威状态。
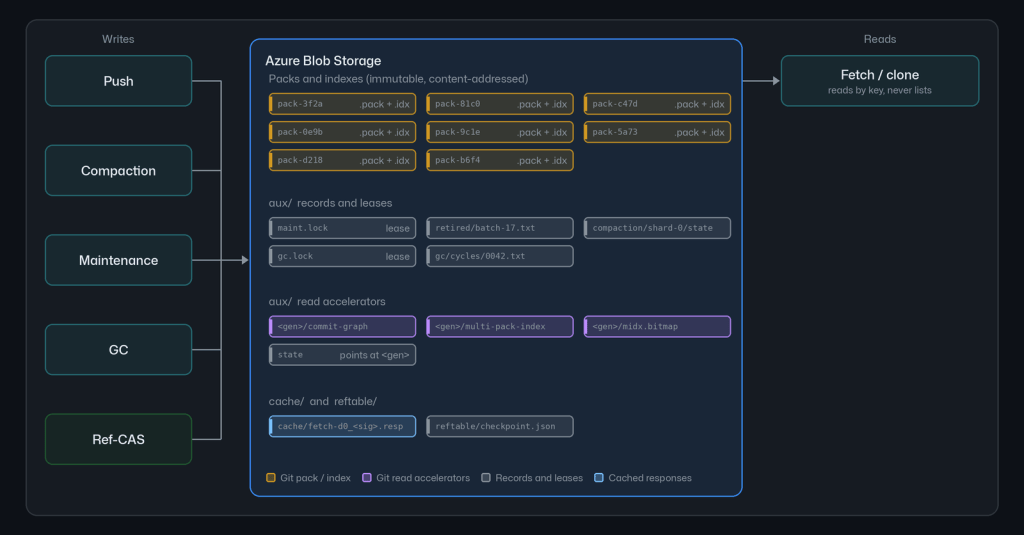
大部分数据仅写入一次到不同的键中,之后便不再更改,这使得它非常适合用于 Blob 存储。
引用(References)则恰恰相反。一个繁忙仓库的引用是一小块状态数据,许多写入操作会同时竞争更新它。这种访问模式在 Blob 存储上难以高效服务,我们的早期原型也证实了这一点。对于这类工作负载,对象存储是一个直观的选择,并且在一定规模的范围内效果良好:条件写入(conditional writes)免费提供了比较并交换(compare-and-swap)功能,且数据本身已经具备持久性和复制能力。然而,我们遇到了一系列棘手的选择,下面通过我们尝试过的两种方案来说明。
我们的第一种方案是为仓库的所有引用建立一个预写日志(write-ahead log),并由单个 Blob 进行索引。每次更新都是对该 Blob 的条件写入。这种方案是正确的,且读取成本低廉:虚拟副本只需检查 Blob 是否发生变化,如果没有变化,操作即告完成。问题出在写入上。同一时间只能有一个针对 Blob 的条件写入处于进行中,因此,即使我们将写入期间到达的所有推送批量合并到下一次写入中,该仓库的写入上限仍受限于往返一次单个 Blob 的一次写入。实际上,这使我们的写入吞吐量仅为每秒数百次。
我们的第二种方案将引用分散到多个段 Blob(segment blobs)中,每个引用通过哈希映射到其中一个段。不同段中的引用写入不再相互等待,从而提高了上限。但是,读取现在必须检查每个段才能确定是否有任何变化,其速度取决于最慢的那个段。我们用读取延迟换取了写入延迟,而读取操作的频率比写入高出几个数量级。我们可以通过并排展示多次写入和一次读取来直观地看到这一点:
这两种方案都无法满足所有要求,因此我们构建了另一种方案:一个专用于引用的复制日志服务,即 Ref-CAS 服务。这就是我们在上一篇文章末尾提到的、仍处于架构栈中的(小型)共识组。其工作原理如下。
Ref-CAS 中的每次引用更新都是一个由多数派确认的比较并交换(compare-and-swap)事务。事务仅锁定其涉及的引用,检查每个引用是否仍保持写入者预期的值,并在日志副本的大多数记录该事务后使其可见。由于智能体(Agents)主要推送到自己的分支,大多数更新不会发生竞争,并且可以并行复制。当两个推送确实更新同一个引用时,只有一个会追加到日志中。
每次提交到 Ref-CAS 都会获得一个日志序列号(LSN),仓库的版本号即为其最新提交的 LSN。读取操作首先针对该版本号进行检查。虚拟副本发送其已持有的引用状态版本。如果该版本仍然有效,回复中将不包含任何引用,未更改的仓库仅需一次比较。如果虚拟副本落后,它将收到当前的引用和版本号,以及指向打包数据和其他需要知晓的信息(例如上次垃圾回收周期发生的时间)的指针。
与我们旧架构中的共识组不同,Ref-CAS 从不持有或验证对象数据,仅存储指向它们的指针。虚拟副本在提交引用事务之前,会将推送的打包数据上传到 Blob 存储。引用始终指向已经持久化的对象。
这些方法使我们能够以每秒数万次的操作速率仅对引用状态进行事务处理,并为复制日志上的额外注释提供了基础,这些注释有助于读取操作决定在给定请求中下载哪些内容。
但是,在单个仓库上支持每秒数千次写入会产生一个二阶问题:维持读取和写入的性能。为此,我们需要一种不同的压缩(compaction)方法。
存储与计算解耦:每秒数千次写入下的压缩
每次推送都会向 Blob 存储中添加一个 pack。Git 可以从多个 pack 中提供仓库服务,但每个额外的 pack 都会使查找操作略微昂贵,因此 pack 的数量不能无限增长。在我们的旧架构中,压缩(compaction)在与服务流量相同的副本上运行,并且必须在每个副本上运行。在新架构中,它在单独的节点上完全在后台运行,直接针对持久化存储进行操作,并使用 Ref-CAS 服务通知虚拟副本关于不断演变的状态。
压缩节点通过租约(lease)声明对仓库数据子集的所有权,这使我们能够水平扩展压缩能力。以下是一个压缩节点处理仓库 pack 的单个分片的工作流程:
节点首先获取 Blob 存储中该分片的租约,因此同一时间只有一个节点压缩一个分片。与此同时,虚拟副本继续上传 pack 并在 pack 清单(pack manifest)中列出它们。节点读取清单以查找新 pack,并将它们收集到一个开放段(open segment)中,这实际上是一个即将被压缩的数据暂存区。当段达到基于 pack 数量、大小或年龄的既定限制时,它会密封该段,使其不再接受新的 pack,然后将这些 pack 合并为更少、更大的 pack。在压缩进行的同时,该分片的下一个段可以开始捕获其输入 pack。在任何内容发布之前,节点会检查新 pack 是否包含与输入完全相同的对象。然后它上传新 pack 并将其添加到清单中。第二个事务从清单中移除输入,清理操作随后删除它们。
为了扩展规模,此过程同时独立地为许多分片运行。每个 pack 的哈希值映射到一个分片,因此增加分片和节点可以增加压缩吞吐量。如果压缩后的 pack 仍然低于大小限制,它会通过其自身的哈希值返回到一个分片并再次合并,因此 pack 以层级方式增长,直到达到限制。最终结果是,随着推送量的增加,pack 数量保持基本平坦:
压缩合并 pack,但保留所有对象。垃圾回收(Garbage collection)是移除不再被任何对象引用的步骤,例如由删除分支和强制推送(force-pushes)遗留的对象。在我们的新架构中,垃圾回收的工作方式与压缩非常相似,使用专用工作程序来处理计算密集型部分。它还有一些用于安全移除数据的特殊行为,值得单独讨论。
通过这些方法,我们能够在写入量增加时始终展示平坦的延迟曲线,并且我们还有其他计划中的优化措施,以使压缩和垃圾回收过程本身更具性能。
下一步计划
我们开始的这两个原则使得该架构的每个部分都能独立扩展。我们通过添加虚拟副本来扩展读取和写入。Ref-CAS 独立地对每个引用进行排序,而不是对整个仓库进行排序。我们通过添加压缩节点来扩展维护能力。我们的目标是让每个仓库,从单个开发者的个人项目到最繁忙的单体仓库(monorepo),都在同一架构上运行,而对繁忙的仓库无需特殊处理。仓库不会一直很小。一个个人项目可能会在一夜之间吸引一批 Agent,而我们不应需要对其进行迁移或特殊处理以保持同步。单一架构意味着我们做的每一项改进都能同时惠及每个仓库。
这一基础使我们能够做更多的事情。我们接下来专注于三个领域:将架构扩展到超出我们今天能预测的需求,使 Agent 在 GitHub 上执行的工作更高效,以及为 Agent 驱动的开发演进 Git 本身。
改进架构
我们有计划进一步改进此架构。每一项改进都使仓库能够处理更多的活动,同时减少每个请求背后的工作量:
- 按需读取。 从 Blob 存储中获取单个对象,而不是获取包含它的整个包。
- 按类型组织包。 将提交(commits)、树(trees)和 blob 分组到各自的包中。许多请求因此触及更少的数据。
- 部分副本。 无需在本地磁盘上拥有每个包即可提供服务请求。
- 物化视图。 将仓库数据保持在即用形式,例如准备好的归档文件、默认分支的近实时浅层副本,以及与每个提交一起存储的 Agent 会话上下文。
- 全局副本。 将副本放置在靠近使用它们的工作负载的任何区域。读取操作保持在最新写入的有界陈旧性范围内。
- 缩容至零。 根据实际活跃的仓库扩展或缩减集群规模。
在 GitHub 上高效执行 Agent 操作
扩展基础设施是支持 Agent 的一个方面。另一方面是降低每个 Agent 操作的成本:减少需要获取的字节数、减少往返次数以及减少等待变更的时间。以下每一项快速跟进措施都建立在本文所述的存储工作基础之上:
- 无需克隆即可工作。 许多 Agent 任务根本不需要完整的工作树。它们只需要少量文件以及做出更改所需的足够上下文。它们可以直接从服务器读取。
- 原子提交 API。 通过一次操作落地多文件更改。整个更改要么提交,要么在冲突时干净地拒绝。
- 事件流。 Agent 及其周围的系统在使用实时信息时表现最佳。通用事件流允许它们订阅更改并在发生时做出反应。
为 Agent 改进 Git
我们在 Git 本身方面也有工作要做。GitHub 一直是 Git 项目的长期贡献者,我们现在也不会停止。以下是我们兴奋于继续开展的工作的几个示例:
- 轻量级克隆。 部分克隆(partial clone)、浅克隆(shallow clone)和稀疏检出(sparse checkout)都允许 Agent 获取更少的数据。每一项都存在不足,而且它们之间有时也不能很好地协同工作。我们希望改进每个部分并使它们更好地配合。
- 消除隐藏的扩展成本。 Git 中仍有某些代码路径,其性能下降速度远快于仓库的增长速度。最近的版本修复了其中几个,但我们预计会发现更多。
- 更快的历史遍历。 元数据(如 commit-graph)可以在不遍历每个提交的情况下回答合并基础(merge-base)和可达性问题。当 Agent 的 API 调用转化为服务器上的 Git 工作时,这一点尤为重要。
- 避免常见的陷阱。 Agent 会犯开发者也会犯的错误。Git 可以捕获更多常见错误,并在造成损害之前发出警告。
Agent 改变了软件构建的方式。GitHub 和 Git 也随之改变。我们很高兴能带领这一新架构跨过起跑线。它目前已有限私有预览,并计划于明年年初进行更广泛的发布。我们迫不及待想看到,当仓库中 Agent 的数量受限于团队的想法而非技术限制时,团队能构建出什么。我们将随着客户和 Git 社区的演进,持续完善 Git 和 GitHub。
标签:
作者
杰出工程师

Brian 是一名首席软件工程师,致力于构建支撑 GitHub 上所有仓库交互的存储和核心服务。
相关文章
[Architecture & optimization](https://github.blog/engineering/architecture-optimization/)
通往 Agent 规模 Git 基础设施的桥梁
我们将 GitHub 99.99999% 的仓库副本迁移到了 Azure。以下是 per-reference quorums 如何接管剩余部分,以及对象存储如何实现读取独立扩展的详细说明。
工程
保持常青:我们如何在共享组织中自动化安全访问和仓库清理
利用原生的 GitHub 功能来审查外部协作者的访问权限并归档过时的仓库。
架构与优化
从 2,500 次请求减少到 24 次:在不涉及 stargazers 的情况下重建 star history
我们的新仓库 star history API 现在可以在不返回个人身份或需要无界数据库工作的情况下提供趋势数据。以下是我们做出的工程权衡。
我们也做通讯
在专为开发者设计的每两周一次的通讯中发现技巧、技术指南和最佳实践。
您的电子邮件地址