Goodfire 研究员提出新观点:AI 的“黑箱”可能比我们想的更容易看懂
原文链接: https://already-clean.goodfire.com/ 来源: Goodfire · Nick Cammarata 发现于: 小互 · AI 解读站 · 2026/10/16 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
神经网络已经是清晰的
早期模型生物中多义性(polysemanticity)的成因并非叠加态(superposition),而是几个普通的、大多可修复的问题。我们现在能够理解参数规模达万亿级别的模型中的大部分神经元,并认为机制可解释性(mechanistic interpretability)的前景可能比我们预想的要好得多。
Nick Cammarata · Goodfire
工作假设 · 65 分钟阅读 · 文本版本 · 前期工作 ↓
简短版
我认为关于神经网络的本质有一个好消息。
在花费数月时间研究图像和语言模型中的神经元和电路后,我逐渐相信,网络自身的机制就是其清晰可读的构建模块,机制可解释性的前景可能远比我担心的要好。曾让包括我在内的整个领域相信网络以任意方式打包概念的关于多义性和叠加态的经典证据,被误读了。看起来像是任意打包的现象,实际上大多是我所称的“递归泛化”(recursive generalization)模式,这令人担忧的程度要低得多。这意味着我们可以直接研究网络,而不是先将其解开。神经网络已经是清晰的。
有两种方法可以入手机制可解释性研究。第一种是对网络本身进行快速的常规科学研究:观察网络的神经元和电路,研究它们之间的关系,观察数据如何在其中流动,并在智能体(agentic)规模上运行实验来验证解释。第二种方法则是从一组假设的特征列表开始,尝试提取所有这些特征,设计越来越复杂的重构目标,并通常忽略原始网络。
该领域始于第一种方法,但后来退回到第二种方法,因为神经网络看起来像是纠缠的线团。我们拥有多义性神经元(polysemantic neurons)的经典案例,这是一个广义术语,指那些似乎承担多个不相关任务或看起来无法理解的神经元。最著名的一个案例来自一个图像模型,它对猫脸和汽车前脸都有反应。早期领域模型生物 InceptionV1 的最后一层似乎充满了任意混合,以至于不清楚该如何研究它:几乎没有任何神经元是易于解释的。
关于多义性的主流解释是叠加态(superposition)。这一理论提出了一种新的学习原则:当神经网络耗尽神经元时,它不再将相关事物分组在一起,而是开始将不相关的事物折叠在一起,仅仅因为它们互不干扰。结果形成了一种类似线团的结构:网络可以有多种几乎同样好的折叠方式,因此一个神经元将哪些事物分组在一起,几乎不能告诉你任何信息。你必须先解开这个线团,才能研究任何东西。在实践中,这意味着训练第二个模型——例如稀疏自编码器(sparse autoencoder)这样的分解方法——来近似网络在未折叠状态下的样子,并研究那个模型。如果网络真的是纠缠的,可能别无选择。
主要结论之一是,叠加态是对 InceptionV1 的错误解释。架构问题导致后续层溢出。微弱的可解释性工具放大了这些问题,使得晚期层看起来混乱无序。此后,旨在帮助深层更好学习的架构改变,产生了使其更具可解释性的意外效果。当我们首次研究 InceptionV1 时,我们发现其最后一层几乎没有可解释的神经元。但是,凭借这些普通的改进,且未改变模型规模或训练数据,该最后一层中 99-100% 的神经元都易于解释,整个模型在整体上都是清晰可读的。这是我感觉大部分都能理解的第一个非平凡神经网络;你可以在此浏览。我在 300 倍的规模范围内训练了它的版本,它在每个规模下都广泛清晰可读。空间较小时,网络不会将不相关的事物折叠在一起;其神经元只是覆盖更粗粒度的概念,比如一个“车”神经元覆盖多种类型的车。空间较大时,该神经元会分化出许多特定的车。因此,问题不在于存在第二种学习原则,而仅仅是第一种学习原则的一次普通学习失败,而且很容易修复。
多义性(polysemanticity)和叠加(superposition)的经典视觉案例也是错误的。2019 年,Chris Olah 和我发现了最初在 Zoom In 中作为叠加现象引入的电路 [Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓]。该电路显示一个“汽车”特征似乎扩散到一组无关的“狗”神经元中。这是我们展示的唯一一个案例,也是我见过的唯一一个。我们将其解读为网络将“汽车”放置在一个高维的隐藏位置,供下游神经元读取出来。但实际上,没有任何东西会读取这种组合。它并没有隐藏任何东西;它只是普通的泛化和组合。据我所知,没有人发表过第二个具有正确形状的电路。
现代语言模型的可解释性通常被认为比实际情况要好得多。Anthropic 的 Towards Monosemanticity [Towards Monosemanticity: Decomposing Language Models With Dictionary Learning Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Circuits Thread. References ↓](2023)在研究一个单层小模型时,给中位数神经元打出的分数为 0(满分 14 分),这意味着评估者无法形成任何假设。我在 OpenAI 发起的 automated interpretability project [Language Models Can Explain Neurons in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. References ↓](同样始于 2023 年)中发现,按照我们最宽松的标准,只有约 1.7% 的神经元是可解释的。
借助更好的工具和现代模型,情况看起来截然不同。在对 Qwen3-32B 的初步审计中,我们估计大约 90% 的神经元极(neuron poles)有一个主要任务,通常伴有少量相关的分支;另外约 7% 有两个相关任务;只有约 2-4% 尚未被理解。关于这个数字的说明:具有单一任务的神经元比例取决于你如何设置弱激活的阈值、深度、子电路的密度,以及你认为什么是“一件事”。
在多大程度上深入弱激活是一个重要因素。下面有一段关于弱激活的描述。它倾向于增加“相关事物”的数量,其影响超过了神经元是否对某些可识别事物做出判断。例如,Trump 神经元的弱激活引入了 MAGA 帽子和与他相关的人。Titanic 神经元的弱激活引入了更广泛的航行故事,或者蒸汽机和其他时代的技术。
还有一个问题是是否应该关注激活百分位数,还是最强激活的比例。总的来说,我认为应该信任神经元所学到的内容,包括其天然稀疏性、激活范围等。这曾经是我主要不相信的观点!我 somewhat 反对试图在所有神经元之间标准化事物。如今百分位数更为常见,我认为这是因为它们更容易思考。
情况也反过来如此。例如,当你查看 Titanic 神经元的“无关任务”时,它通常是在检测“boat”是否是下一个词。该工具错过了这一点,因为它在判断上下文时只向后看。当我们深入查看这些“无关任务”时,几乎总是这类情况。构建不完美的工具很容易。
总的来说,我认为得出一个单一的分数并不是那么重要。但当它被移除时,早期的审稿人觉得没有锚点,甚至没有一个粗略的数字。在我更仔细查看的集合中,考虑强激活时,非任意混合的比例接近 97%,但这些样本相对较小。
总体而言,将所有内容提炼为一个单一的“清洁度”分数,应被视为神经网络所处状态的广泛指示器,而不是某种可以直接优化或过于严格坚持的精确值。这篇散文的很大一部分旨在减少降维,根据每个神经元和电路的动机、深度、角色等进行差异化处理。尽管如此,一个粗略的数字仍然有用。Dense 和 Mixture of Experts 模型看起来大致相似。我们在参数量达到万亿级别的模型中发现了类似的结果,例如 Kimi K3, companion paper 将对此进行更详细的介绍。这些百分比将高维图像压缩为几个数字,而精确的数字取决于你如何设置什么算作“一件事”的阈值——比如你是否将两种语言中密切相关的习语归为一类。我认为可解释性领域中的许多内容并不取决于这个问题。更重要的是,事物最初为什么共享一个神经元。
大多数剩余的表观多义性似乎是我所称的“递归泛化”(recursive generalization)这一模式。它很简单:随着神经元的生长,它会像树枝长出分枝一样长出分支。例如,一个检测“iy”的神经元逐渐演变为检测“diy”,进而检测“do it yourself”,而后者根本不包含“iy”。这个想法最早出现在我参与撰写的一篇论文的一个被遗忘的子章节中,题为 Multimodal NeuronsMultimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. References ↓ (2021)。当时,我并没有观察过神经元在训练过程中的生长情况。现在这变得更容易了,并且在我所见的所有地方都成立。即使是原始的 InceptionV1 也没有打结。当我重新训练其原始架构(它仍然产生混乱的深层结构),并追踪我能找到的最难以解读的神经元时,发现它们实际上是在局部过度生长,扩展到了合理且相邻的领域。
因此,对于多义性有两种解释,而我都曾参与提出。在某些方面,它们是相反的:泛化将相似的事物归为一类,而叠加(superposition)将不相关的事物归为一类。叠加是领域所押注的方向,直到最近我也如此认为。但我现在认为递归泛化基本上是正确的。这样一来,最终只剩下一种学习原则。它仍然是泛化,但事实证明泛化是分形的(fractal)。这远不那么令人担忧:从事物的分组方式中可以学到东西,而从叠加中的两个项目中学不到任何东西。而且由于泛化本身是分形的,我们的解释也可以如此:从基本解释开始,然后在想要更深入理解时进行放大。从这个意义上说,如果我们看得足够仔细,尤其是观察其在训练过程中的生长方式,几乎整个网络都是可解释的。
那么,差距为何如此之大?我认为几个普通问题叠加在一起导致了这一结果。2023 年的解释模型无法运行“猜想与测试”的循环;工具和指标薄弱,奖励那些能够 模拟激活 的解释,而不是那些正确的解释,而这两者往往并不一致;没有人知道预期会出现什么样的语言神经元模式,人们广泛地寻找错误类型的事物;而且大多数研究使用的是小型或简化模型。从某种意义上说,这些模型确实已经耗尽了空间,这使得叠加成为自然的解释。但是,空间不足的神经网络并不会切换学习原则;它的神经元只是变得更宽,就像小型视觉模型中的情况一样。一旦你知道该寻找什么,宽神经元通常很容易分解。如果没有这些知识,加上原始的工具,它们看起来就像任意的混合物。
可解释性拥有令人惊讶的动力:就像拼图或填字游戏一样,你获得的任何理解都会开始约束系统的其余部分。起初,你是在观察单个神经元。如果你无法理解它,其他任何东西都帮不上忙:电路和归因图只能用你尚未理解的其他神经元来解释一个神经元。这可能会让起步变得困难。然而,一旦地图开始填充,进展就会出乎意料地顺利。如果你不完全了解某个神经元的作用,你可以研究它连接到的对象、其周围的生态系统,以及在混合专家(mixture-of-experts)模型中,其专家专门负责什么。就像拼图逐渐拼合一样,每一块都带有许多线索,而且这些线索结构良好,易于进行实验。这就是为什么几乎为空和大部分已填充的状态并不令人惊讶;它们是自然的锚点。
以跟踪“当廉价购买品比昂贵的替代品表现更好时产生的一种正义感”的神经元为例。跟踪这种情感或社会线索的神经元是我们发现的最常见的神经元之一。想象一下,在没有语言神经元模式知识且没有电路可依赖的情况下找到这个神经元,因为很少有相邻神经元得到解释。大多数人类和智能体都期望神经元通过激活来检测名词,而它们大多并不这样做。观察这个神经元在哪里激活最强,你会看到一堆看似无关的逗号。
现在想象这张地图大部分已经填满。你知道许多神经元能探测微妙的情感或社交情境,而且它们往往不是在承载情感的词语上激活,而是在标点符号上激活——比如逗号,模型在此处总结句子的含义——或者激活在“情感开始影响下一词预测”之前的那个词上。于是你转而去阅读周围的句子,并检查它的引导效果(steering effects,即当你调高该神经元时模型会写出什么),两者高度吻合。你向上游查看它是如何构建的,向下游查看它产生什么作用,两者也都吻合。你检查它的负极——是什么把它强烈推向负值——发现是同一线索的微妙变体,或者是社交情境结束的那一刻。你可以运行具体的测试,比如检查它对哪些商店品牌有响应。其中任何一项都可能推翻这个解释,但它们始终指向同一个地方。而理解了这个神经元,也让更宏观的主题愈发清晰:在看过数千个“微妙情感”和“社交情境”探测器之后,你开始知道下一个会是怎样的——这也是地图越填越快的原因之一。
这套方法对工具同样有效。当你只能看到网络的 2% 时,你无法判断自己的工具在哪里出了问题;而当你能看到网络的绝大部分时,那些未被解释的残余部分会直接指向工具的缺陷。我和一些同事正是这样发现了 SwiGLU 神经元中的一种双负(double-negative)机制——据我们所知,此前无人注意到它,而把许多神经元混在一起的分解方法很可能已将它掩盖。
现代神经网络的坏消息是它们极其庞大。好消息是这种庞大反而有帮助:随着地图逐渐填满,每一个解释都受到周围所有内容的严格约束,而且更大的模型会学到更窄(更专一)的神经元,本来就更易于识别。
从这个意义上说,理解整个网络可能比只理解我们最关心的部分更容易。首先,除非你近距离研究过神经网络,否则很难知道如何像神经网络那样思考。例如,“欺骗”是一个有用的初始框架,但促成模型欺骗行为的那些基础构件,很可能具有与对齐(alignment)相关的微观结构,不深入内部观察就很难了解。其次,只针对一小部分机制展开研究,就像在一道基本空白的纵横字谜上只填一行。这可行,也可能成功,但缺少交叉提示(crossings),你很难确定自己填得对不对。解开整道谜题——或者至少是网络中与这些机制相连的更广泛区域——或许反而更容易。
当我把这个流程用在现代卷积网络上时,它基本上奏效了。Agent 能够为神经元和回路绘制地图,构建可探索的显微镜并加以探索,彻底检验各种解释,并追踪数十万张归因图(attribution graphs)。始终没有出现快速的常规科学中断的时刻。我现在感觉自己基本上理解了这些模型,至少足以知道对于任何问题该从哪里入手提问;最终,那道纵横字谜就这样被填满了。到目前为止,这一流程在语言模型上也有效,规模最大已达数万亿参数。由于体量实在庞大,这些模型还远未被解决,但我对扩展这一流程的前景持乐观态度。
这一切让我重新回到一个由来已久的希望:直接理解神经网络,通过研究其机制以及机制之间流动的数据,而不必先去修复或解开它。综合起来,这个论证有四个步骤。
- 网络只使用一种学习原理,而不是两种(即使不是处处如此,也接近到对研究无关紧要的程度),因此对它们开展常规科学并无障碍。
- 有了现代模型和工具,这门科学的进展远比大多数人预期的要好。
- 理解具有复利效应,随着地图被填满,研究会越来越容易。因此,网络自身的机制至少应当成为工具箱的一部分。
- 高度推测性的一点:这可能就是我们所需的大部分内容,而可解释性(interpretability)可能远比我们假设的更容易攻克,甚至可能在短期内就实现。
这就是深度学习的一般规律:在极端规模下,简单的方法胜过巧妙的设计。Rich Sutton 将其称为苦涩的教训苦涩的教训 Sutton, R., 2019. Incomplete Ideas. 参考文献 ↓。也许可解释性领域也存在类似的苦涩教训:扩展常规的研究规模胜过工程化一种巧妙的新分解方法。
一篇技术性的配套论文将提供更详细的语言模型神经元实验记录,例如我们关于现代非线性不同机制的发现,以及在不同深度出现的电路模式类型。本文简要浏览了许多案例,并推测这一切可能指向的方向。
汽车与动物
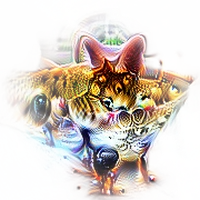
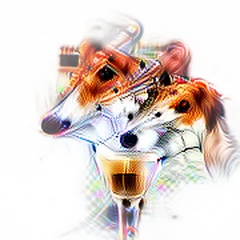
最著名的多义性神经元是 InceptionV1 中的 4e:55,它看起来像是猫和汽车的任意混合体。这一案例被多次引用,作为证据表明神经元可能不是该领域几篇阅读量最大的论文中合适的研究单元,从 2017 年的特征可视化特征可视化 Olah, C., Mordvintsev, A. and Schubert, L., 2017. Distill. 参考文献 ↓到 Zoom InZoom In:电路导论 Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. 参考文献 ↓。在我合著的 Zoom In 一文中,我们明确指出它“并非对猫和猫脸的某种共性做出反应”。在《多模态神经元》一文中,我们几乎也这么认为。我们曾询问该神经元是否可能对某种共享特征做出反应,“也许是猫眼和车灯看起来相似”,然后根据特征可视化中的胡须和镀铬部分判断,这实际上是“真正的 OR(cat, car)”。我们寻找共享形状的做法是正确的,但我认为我们低估了泛化的广度。共享特征是字母“V”。我认为胡须误导了我们,因为泛化发生在高层模式内部。V 神经元确实接收来自猫电路的信号,而特征可视化的作用是提升激活值,所以一旦它找到猫的路径,就会加上该路径带来的所有内容。胡须也随之出现,即使神经元本身并不“想要”它们。在下游,汽车读取器确实通过 V 神经元获得了一些猫的信号,但这些信号几乎无法到达输出端:单个猫检测器的激活作用微乎其微,因为许多检测器协同工作,所以网络不需要负权重来抵消它。要看到共享模式,你必须可视化神经元输入的共同点,而不是单独可视化神经元本身。
在观察到大量清晰的神经元数月后,我怀疑我们是否误解了一些早期著名的多义性和超位置(superposition)案例。这个标志性的多义性神经元显然是检查的重点,于是我打开了那个我看过数百次的猫和汽车图像网格,做了一件我从未做过的事:我花了几秒钟思考这可能代表什么。几乎瞬间就显而易见了:它不是猫和汽车神经元,而是一个 V 形神经元。
我查看了它的电路连接:V 形火焰、消防船喷射的 V 形水柱、V 形狐狸脸。我查看了它的负极点:一个 O,在 V 指向的地方是圆形的。为什么猫和汽车的任意混合体需要与火焰如此强烈地连接?
inputs 4d:493 狐狸嘴
 4d:477 狼脸
 4d:201 面包车前脸4e:55
 尖→
 通用
 圆→
 通用读取器
 5a:94 火焰
 5a:352 郊狼脸
 5a:317 马提尼酒杯
尖形让它激活
- 狗
- 狐狸
- 猫
- 汽车
- 台球桌
- 子弹头列车
圆形使它输出负值
- 狗
- 狗
- 蜗牛
- 高尔夫球
- 网球
- 时钟
上方是它最强的输入和读取者(线宽代表强度)以及通用渲染图。下方是它在每张照片中看到的东西:尖的物体驱动它激活,圆的物体使它输出负值,无论标签是什么。
然后我去查了那个经典的 superposition(叠加)电路,我最早是在 2019 年发现它。我是在构建我的第一个 Circuits 界面时发现它的,那个界面只有 feature visualization(特征可视化)和连接各神经元之间的权重。然后我把它们拿给 Chris Olah 看,问他为什么汽车会这样进入这些狗。我们得出的结论是,它一定是在做某种折叠(folding),并将其命名为 superposition(叠加)。对于我们观察到的东西来说,这是一个直观的解释,所以它没有促使我们更深入地钻研工具——而深入钻研本会发现 feature visualization 的 reward hack 问题以及其他各种情况。把组合放置到高维空间中,感觉像是一个合理的答案。V 神经元和这个电路是 Zoom InZoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓ 一文中“几乎所有神经元只要认真观察都是可以理解的”这一神经元图景可能“过于乐观”的两个主要例证。
这个电路看起来显示的是一辆汽车进入一堆毫不相干的狗,仿佛这些狗是某种高维存储空间,汽车可以在其中被存放起来,之后需要时再取回。
但汽车并不是在那样做。汽车和狗被联系在一起,是因为它们共享姿态(shared pose)。InceptionV1 拥有一百多个这样的广义姿态神经元(generalized pose neurons),每一个都是一个干净的检测器,负责检测汽车、狗和其他物体之间共享的某种姿态,而据我所知,此前没有人注意到它们。后面的层会不断在这些神经元之上继续构建,一直持续到模型的末尾。汽车并没有被存放在某个隐蔽的角落,也没有任何东西直接读出这种组合。恰恰相反:它正在继续分化出更专门的汽车神经元和更细粒度的姿态。
部分原因是我们不了解广义姿态神经元,另一部分原因是我们用来渲染图像图标的技术——feature visualization——在较深的层中最终会被 reward hack。其本意是找到一张能最大化该神经元激活的图像,但实现方式是通过梯度下降,而梯度下降会走最容易的路径,这在 InceptionV1 中往往意味着狗。InceptionV1 的训练数据里有很多狗,也有很多狗神经元,早期的优化会掉进这些坑里,而且再也爬不出来。哪怕只是轻微地把它偏向激活最强的自然图像所走的路径,其中大多数都是汽车,还有一些既是狗又是汽车,原因就是共享姿态。
我们原本以为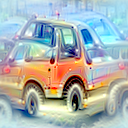 任意的存储空间实际情况只有汽车共享的汽车与狗姿态
我们以为汽车被隐藏在狗神经元之中,之后再被读出,但我们把它们可视化错了。以汽车为视角进行可视化后可以发现,其中两个是 car 神经元,另外两个共享汽车和狗之间的姿态。
人们可能倾向于不把这种泛化当回事,理由是假设狗和汽车之所以被放在一起,只是因为空间不够。也许模型“真正想要”的是独立的狗姿态神经元和汽车姿态神经元,而一个空间更大的模型本可以把它们分开。诚然,更大的模型往往拥有更多窄化的神经元,但当网络扩大规模时,它们可能会以反直觉的方式做到这一点。
看看 DINOv2DINOv2: Learning Robust Visual Features without Supervision Oquab, M., Darcet, T., Moutakanni, T., et al., 2023. arXiv:2304.07193. 参考文献 ↓,它的规模是十倍以上,架构上晚了大约十年,却拥有更多姿态神经元(pose neurons),但其中许多仍然是泛化的。在我看过的每一个视觉模型中,无论规模大小,我都见到过这种现象。
DINOv212× InceptionV1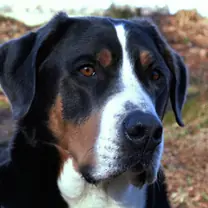
 ConvNeXt large4× InceptionV1
 ConvNeXt medium1× InceptionV1
 ConvNeXt small1/75× InceptionV1
同样的神经元出现在 DINOv2 以及我们的大、中型 ConvNeXt 中:狗和车辆按照它们朝向相机的姿态被归为一组。我们最小的模型只有一个粗糙的版本:汽车和狗被放在一起,但并未按姿态区分。
无论是人类还是自动化的解释者(interpreter),似乎都强烈倾向于把神经元描述为一组名词的探测器,比如猫和汽车,而不是某种共享模式的探测器,比如字母 V。有时候,神经元确实会对一组名词产生响应。不过根据我的经验,更常见的情况是共享模式,此时把这个神经元理解为一个动词,比理解为一个名词更为贴切。它的职责不是为输入中的内容命名,而是划出一种下游神经元可以利用的区分:它在正负两极分离出两种细微的模式(V 对 O),并据此把激活流推向不同的神经元。
我通常可以通过问这样一个问题来解开对某个神经元理解的死结:如果我完全不能使用名词组,我会如何向别人描述这个神经元?通常,共享的模式会立刻浮现出来,而且很容易在更多的名词组上进行测试(例如 V:新干线、台球桌)。我怀疑这是中层神经元中被错误归因的多义性的最大来源。许多我看到的将神经元称为多义性的解释,在我看来,只是将单一模式描述为名词列表。
我们应该将具有两个或三个含义的神经元视为一个具有多个分组含义的神经元。这种分组对网络来说可能并不是问题:这些含义聚集在一起,是因为从网络的角度来看,它们是相似的。这使得分组成为理解网络思维方式的线索,跟随它可以发现我们未知的泛化能力,就像这里的猫和汽车一样。通常,额外的含义在仔细检查后也会消失,证明它们是次要的且很少被激活。最后,一些看似含义的东西只是我们的工具不够好,本文中有几个例子:SwiGLU 的双重否定机制、一个难以可视化残差流的未读显著性旋钮,以及我们刚刚看到的特征可视化中的奖励黑客行为。保持原始神经元的完整性可以使这些错误可见,从而允许错误校正继续进行。如果我们使用优化来获得更清晰的列表,我们可能会丢失许多这些线索。
显微镜错误的历史
在我看来,可解释性的历史在很大程度上是关于发现显微镜下的东西比我们想象的要好。显微镜只是没有调好,而需要调整的东西往往相当微妙。
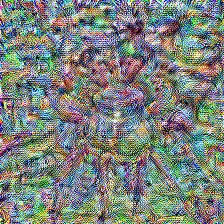
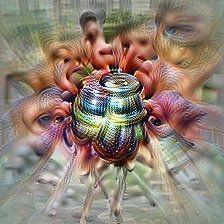
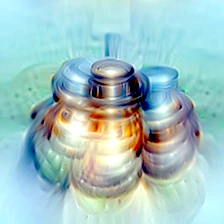
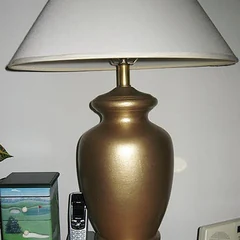
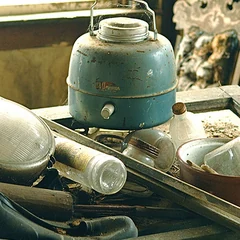
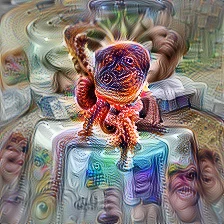
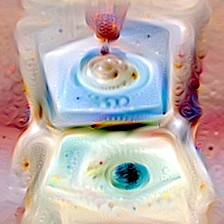
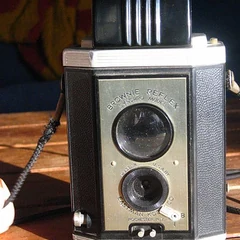
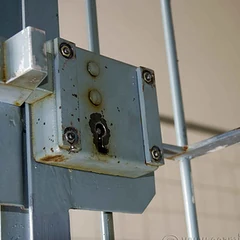
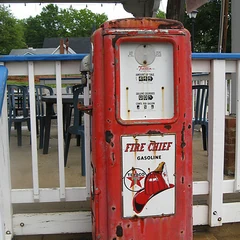
现代神经网络可解释性可以说始于特征可视化,它渲染出神经元最响应的合成图像:著名的迷幻图片。起初它们看起来并不好。你可以合理地得出结论,神经元学到了东西,只是不够清晰。事实证明该方法缺乏变换鲁棒性。一旦研究人员添加了它,同样的神经元就变得清晰了。
但这只能让你深入模型的一部分。在接近末端时,特征可视化再次开始失效,原因有两个:我们之前看到的汽车电路中的奖励黑客行为,以及不太正确的正则化。修复它不需要任何花哨的东西。对合理设置进行一些微妙的调整,现在我们可以更深入地观察网络。同样的神经元,更好的显微镜。
| 2009 风格 | 2017 | 2026 | 最强照片 |
|---|---|---|---|
| 中层 | |||
 |
 |
 |
最强照片 |
 |
 |
 |
 |
| 深层 | |||
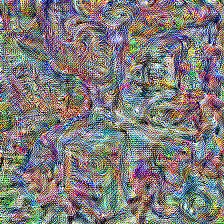 |
 |
 |
最强照片 |
 |
 |
 |
 |
同样的两个 InceptionV1 神经元,旁边是它们最强激活的照片。微小的 regularization 调整先让中间层的神经元显现出来,然后是后层的那个。
但并不全是显微镜的功劳。模型本身也需要调整。InceptionV1,这个领域的早期模式生物,其后期层完全不可解释。有估计称:"据我所知,InceptionV1 的最后一层基本没有可解释的神经元",这与我自己的记忆很接近,我大概会说只有 5%。它们当时的样子是这样的。
特征可视化数据集样例
InceptionV1 的一个后层神经元,通过优化视图和自然图像展示。
据我所知,当时的主流解释是:相对于现有的神经元和参数数量,需要表示的高层特征太多了,于是网络开始任意地把本不属于一起的特征打包在一起,因为它们不会冲突。早期层之所以是单语义的,是因为需要表示的早期层特征没有那么多。
但这并不是正确的解释。这里是一个更现代的卷积网络,参数数量和数据集都相同,但带有 residual connections、LayerNorm 以及其他一些改进。它的最后一层非常漂亮。
瓢虫 · Neuron 127 悬停以探索 · 点击以保留 特征可视化 打开神经元 ↗https://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-41574-x32-y32.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-46370-x32-y32.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-22108-x32-y32.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-47708-x32-y32.jpg叶甲https://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-10805-x32-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-04173-x32-y32.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-05390-x32-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-48422-x32-y32.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-38007-x32-y32.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-43091-x32-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-23690-x32-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-43064-x32-y32.jpg叶甲https://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-47002-x32-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-21789-x32-y32.jpg叶甲https://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-20958-x00-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-37284-x64-y00.jpghttps://already-clean.goodfire.com/assets/last-layer-neurons/medium/images/img-13042-x32-y32.jpg


每个神经元在 50,000 张图像中最强的 20 个响应,按顺序排列。标签标出的是来自其他类别的图像。
因此需要两件事。首先,神经网络需要学得好,使用由完全专注于这一目标、对可解释性毫无兴趣的人所设计的架构。residual stream 就是一个例子:它的引入是为了帮助训练更深的神经网络,而它似乎也有助于让更深的层在概念上保持整洁,这两者可能相关。其次,我们需要足够强大的工具来清晰地看到它们。
InceptionV1 的最后一层曾是“神经网络几乎从根本上不可解释”这一论断的主要证据之一,因为它们的学习方式会重叠不相关的混合概念。替换这些神经元似乎成了唯一的选择。用那个时代的工具,我估计这个比例在 5% 左右,其他人估计约 0%。借助更好的可解释性工具(修复后的特征可视化、可视化归因的方法等),在同一个网络上,这个比例更接近 50%。以上都是针对那个 2014 年的模型,其 checkpoint 和训练细节已随时间散佚。用更合理的现代正则化方法重新训练同一架构,比例约为 70%。而在同等规模的 ConvNeXt 中,约为 99%。你可以在这里探索它们。
递归泛化(recursive generalization)
我们已经证明了最后一层是可以修复的。但在被修复之前,它在做什么?即便在架构改进之前,它也不是在任意地把各种事物拼凑在一起。当我们重新训练模型并观察一个神经元形成时,它最初响应的是黄色花朵,这些照片中有时会出现狗。接着它沿着这些照片的各个侧面生长:朝向其他类型的自然事物,朝向球之类的绿色物体,朝向没有任何花的狗。我看过的每一个神经元都是如此。改进后的架构也呈现出相同的模式,只是程度轻得多。
每行背后的灰色条带表示它在该神经元最强图像中所占的比例。
InceptionV1 中的一个神经元和 ConvNeXt 中的一个神经元,二者使用相同数据训练,都从油菜田起步。两者早期都会响应球和水果;ConvNeXt 随后放弃它们并停留在田野上,而 InceptionV1 持续扩散,进入狗,再进入西兰花,直到田野几乎消失。
我们称之为递归泛化(recursive generalization):一个神经元沿不止一个轴泛化,通常先沿一个轴泛化,然后再向外萌发,这种萌发在局部很容易追踪,但最终使它无法保持 “monosemantic”。
例如,一个语言模型的神经元先响应 “iy”,包括 “Miyazaki” 中的 “iy”;接着响应 “diy”;再接着响应 “do it yourself”,而后者已经完全不包含 “iy”。
递归泛化(recursive generalization)。 一个 “iy” 神经元沿多个方向生长。从 “diy” 延伸到 “do it yourself”,后者完全不包含 “iy”。概念示意图。
在图像模型和语言模型中,这样的例子随处可见。比如一个地质学神经元泛化到了 Cesium——一个地质学 JavaScript 库。
通常发生了什么非常明显,以至于很难判断是否应该直接称之为普通泛化。比如一个“敌人”神经元会因一首关于敌人的俄语诗歌而激活。有时则不那么清晰,但仍然说得通。一个 Srinivasen 神经元也会轻微响应 UniProt 蛋白质数据库。该项目确实关联着好几个 Srinivasen,但很难完全确定。
激活最强的 8 个样本
- String is a scalar string or 1-element string array, then STRSPLIT returns an array containing72
- determine the average of the values 0 to 9:↵SPAWN, ’test_pipe’, UNIT62
- Set this keyword to make the "Cancel" button the default selection for the dialog. The default selection61
- Stage,↵ ModelExperimentalSceneMeshPrimitive,↵} from "../../../Source/Cesium.js";↵↵describe("Scene59
- of KREEP-rich rock at the base of the crust left by the original crystallization of the54
- Highlands are older than the Northern Lowlands, based on the larger number of impact craters seen covering54
- ers during their final days. The dramatic footage was taken on December 14, 2054
- in the night sky, it's really easy to see the difference between the dark lowland plains called54
按前 100 名路由的占比分组
- 月球和火星地壳 44% 通过 L31 火星进入,行星将高地推至靠近暗面,那里也是太阳系中最大和最古老的撞击特征之一——南极-艾肯盆地的所在地,其地壳底部留下了富含 KREEP 岩石的原始结晶痕迹。
- 月球任务 42% 通过 L28 月球进入,将月球推向远侧的撞击坑地壳。但随着燃料耗尽,NASA 决定将它们飞入月球附近的一座山脉,这会导致图像失真,目前 LROC(月球勘测轨道飞行器相机)正在……
- 古老的撞击,火星 6% 通过 L30 其他星球上的生命进入,将平原盆地推向火星。↵“34 亿年前,一颗大型陨石引发了第一次海啸浪潮)↵换句话说,由于巨大的希拉斯撞击导致的内部压力积聚相当可……
- 铯和 IDL 代码 8% 通过 L6 类似 Cesium 的名称进入,将 .js 对象推向软件和降水率值,CesiumJS 随后可以从中生成↵pointPrimitive 对象。由于某些颜色数量一旦初始化,在不先退出 IDL 的情况下无法更改。↵色图定义
月球和火星地壳高地,近侧和远侧,南极-艾肯盆地通过 L31 火星、行星 L28 月球醒来 ↑ L34 中国的月球计划 ↑ L37 深时推向高地、近侧、暗面、夜空中的撞击,很容易看到被称为月球任务的暗色低地平原之间的差异。环绕、成像并撞击月球的空间飞行器通过 L28 月球 L7 月球早期醒来 ↑ L36 空间飞行器、任务 ↑ L37 对表面的撞击推向月球、远侧、陨石坑卫星,但它们燃料不足,所以 NASA 将命令它们撞击表面。↵因为它是古老的撞击,火星希拉斯、水手号峡谷、早期地球;较弱的点火通过 L30 其他星球上的生命 L32 大火山推向平原盆地火星图片在一周内,聚焦于水手号峡谷西端附近的撞击坑铯和 IDL 代码 CesiumJS 地球库和 IDL/ENVI 图像处理文档通过 L6 类似 Cesium 的名称 L32 软件文档中的数字醒来 ↑ L37 JavaScript 库 ↓ L37 太空新闻推向 .js 对象软件检测到空格或逗号时。在这种情况下,IDL 执行简单的字符串搜索
行星地质神经元的强烈点火混合了月球地壳与 IDL 和 Cesium 代码。按为其提供馈送的回路的分组,它们分离为核心的一部分的三个面:行星表面,以及一个分支:代码,它通过自己的路线到达。
我们将在 语言模型部分 讨论这些递归泛化的分支及其重要性。这里我们只想讨论这个模式是什么。
我们首先在 多模态神经元 中暗示了这一点,人工智能神经网络中的多模态神经元 Goh, G., Cammarata, N., Voss, C., 等人,2021. Distill. 参考文献 ↓,称它们为“联合特征”。直到我回到该领域最著名的模型中,在研究递归泛化数月之后,我才想起这一点。据我所知,没有人,包括我自己,提出这可能是通用解释,例如 InceptionV1 最后一层出了什么问题。没有训练检查点,我们就无法观察其形成过程,但解释基本上是正确的。附录 解释了我为什么认为新名称更准确。
叠加
递归泛化并不是一个特别大胆的解释,它可以说是普通泛化的理所当然的结果。但也有一种更大胆的解释,即针对多义性提出的新学习原则。
我们随处可见的主要学习原则是泛化。通过泛化,事物被组合在一起,因为它们共享一种在一个地方有用且可以在此基础上构建的模式。通过叠加,不相关的事物被放置在一起,因为它们不会相互干扰。这两者有相反的预测:泛化应该是局部的,叠加应该是非局部的,因为它会让非常不同的事物彼此靠近。
泛化会想要一个垂耳狗神经元,它可以理解为许多略微不同的垂耳(不同角度、不同种类)聚合在一起。而 Superposition 则会想要一个垂耳狗 + 拉丁诗歌神经元。
Arbitrary packing
不相关的事物共享一个神经元
Generalization
相似的事物共享一个神经元
Neurons
每个神经元 8 件事
概念性图示。两个面板中出现的是相同的 32 件事;相似的颜色和形状代表相似的事物。神经元越少,负责泛化的神经元就越粗糙,但绝不会碎裂。悬停或点击某个神经元,可以在两个面板中找到它所承载的事物。
定义在这里开始纠缠不清。与 superposition 一道,Zoom InZoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. 参考文献 ↓提出了特征(feature)是神经网络基本单元的思想。取决于你从哪里看,superposition 要么意味着“特征多于维度”——即使是完全单语义的网络也满足这一点,因为它的神经元会组合成特征——要么指上文那样的学习原则,有时被用于神经元学到什么,有时被用于特征被放置在哪里。举例来说,InceptionV1 的 4b 层里有一些基本单语义的神经元,分别针对车窗、车身和车轮等汽车部件,而下一层把它们组装成一个汽车神经元 4c:447。从特征的视角看,说“汽车特征”不仅存在于 4c:447,也存在于构建它的那组 4b 神经元的组合中,是合理的。于是相邻两层中有两个汽车特征,共享几乎完全相同的机制。从“特征多于维度”的视角看,前者处于 superposition 中,而后者则未必。按照非正式笔记 Distributed Representations: Composition & Superposition 的含义,前者是分布式(distributed)的,但是通过组合实现的;后者则完全不是分布式的。这也是为什么我觉得假设出来的特征难以用来思考,而我通常更偏好像神经元这样具体的机制、以及具体的数据片段的部分原因。
所以"superposition"本身就在几种常见用法之间处于 superposition。我们聚焦于作用于神经元等机制的学习原则,因为它是否形成,对 interpretability 而言的好消息或坏消息占了压倒性的比重。而且它也相当容易检验:递归泛化与 superposition 做出几乎相反的预测,你可以观察一个神经元的成长过程,看看哪一种真的发生了。
在本文中我说到 superposition 时,指的就是这个版本;“特征多于维度”这个问题——我基本不认为它是坏消息——我们稍后再谈。
空隙处的 Superposition
多语义性(polysemanticity)往往更像是对观察者的断言,而非对神经元本身的断言。它所表明的是:目前还没有一个好的解释。可能的原因有以下几种:
- 工具不佳:我们的透镜或显微镜不够好
- 解释不佳:用这些工具造出来的解释
- 学习不佳:由于糟糕的架构、训练数据或其他原因,网络学得不好
- 递归泛化:在泛化的过程中,神经元朝几个相关的方向发生了分支
- Superposition:学习原则的一次改变,网络把不相关的事物打包进同一个神经元,因为它们很少发生碰撞。
多年来,我是 superposition 的坚定信仰者。我开始研究语言模型神经元,并不是出于对神经元或 superposition 本身的兴趣,而是因为我感兴趣的是:Agent 是否具备研究品味!我想看看它们在检验各种解释时会不会提出好问题,神经元只是作为一个基线入手。我预计它们会撞上 superposition 中难以处理、支离破碎的特征碎片。那将得到一个关于神经元究竟有多干净的新基线,然后 Agent 们可以换用某种更干净的已学习基继续下去。但那一刻从未到来,因为神经元的答案源源不断地涌现,最终收敛到一个简单的解释——它做出了令人惊讶的预测,而这些预测都成立。
在一个前沿语言模型中,我发现了一个神经元,它主要对 "pr" 触发,但也会对一堆 Base64 URL 字符串以及一些孟加拉语触发。我当时以为这终于是一个任意的混合了。但是把那些 URL 解码出来:是 "pr" 开头的单词。把孟加拉语翻译过来:还是 "pr"。
English Please approve the project proposal.
Base64


Bengali

  প্রধানprodhanhead
  শিক্ষকshikkhokteacher
  প্রথমprothomfirst
  প্রশ্নটিproshnotiquestion
  করলেন।korlen.asked
说明:无论是解码还是转写,那些噪音最终都是 "pr"。
在一个稠密的 Qwen 模型中,一位同事偶然发现了一个神经元,标准的 top-k 自动可解释性方法把它列为“多义逗号神经元”。但仔细观察后发现,它其实在追踪 Colorado:电话号码、俚语,以及与其他 Colorado 神经元的连接。对它进行 steering 会让模型想去远足。那些逗号正是它存储 Colorado 上下文滚动摘要的地方。总体而言,attention 似乎会聚集在标点符号上,我们称之为 summary motif。一旦知道了这一点,很多类似的神经元就变得更容易理解了。
新工作,新城市,新租约,Denver 的地址,303 区号,green chile,Broncos 的周日,Red Rocks,bluebird powder days,Sanitas 步道起点,fourteeners。前三个逗号没有触发;一旦 Denver 出现,每个逗号都开始触发,在 green chile 之后达到最强。
  My plan for this weekend is to go to the library and study for the test. I also want to visit my grandmother and help her with some gardening.
  My plan for this weekend is to go to the mountains and do some hiking. I have a few different trails that I can choose from…
在 Colorado 出现之前,逗号一直保持沉默;随着上下文的积累而逐渐亮起;对该神经元进行 steering 会让模型计划一次远足。
另一些时候,我们只是没有足够的数据。起初我们没有纳入长上下文,两段话似乎就够了。但这无意中让所有长上下文神经元看起来都是多义的。
Agent 所看到的
仅看最后一段,会推断出这是一个关于咖啡和大学的神经元;原因在更上面的位置。
在另一个案例中,一个神经元看起来像一团任意的乱麻,没有任何强烈的触发。事实证明,它是在健康类 SEO 垃圾页面中寻找特定的特征,而一旦我们有了足够广泛的数据集,它就变得可以理解了。
在数百个这样的案例中,没有任何东西动摇我对 superposition 的信念。它总在不停地转移。如果强激活看起来是干净的,superposition 就会转移到弱激活上,或者转移到神经元的组合上,或者转移到我还没看过的神经元上。又或者转移到各层本身。
但最终我开始思考到底发生了什么。除非这是一场戏剧性的、被极端放大的选择偏差案例,否则总有什么东西与早期的 model organisms 对不上。于是我回过头去检查,原始证据坍塌了,这引出了这篇文章。
现在我认为,我把 superposition 当成了零假设,而它本应是最后一个假设,因为它是最激进、最不可检验的。它看起来就像那些说不通的东西。但糟糕的工具看起来也是这样(feature visualization 的 reward hacking),或者是你尚未追踪完的递归泛化("iy" 神经元),或者是糟糕的架构(InceptionV1 的 5b),又或者是你尚未理解的泛化(cat 和 car)。
我认为部分原因在于,superposition 只是让人觉得理所当然。Anthropic 的 Softmax Linear UnitsSoftmax Linear Units Elhage, N., Hume, T., Olsson, C., et al., 2022. Transformer Circuits Thread. References ↓ 论文在 2022 年就说过这样的话:“在 mechanistic interpretability 社区中,superposition 常常被当作默认假设,仅仅因为它在直觉上比其他解释更有说服力,但几乎没有证据。”在下一句话中,该论文说它自己的结果是 superposition 的中等强度证据。用论文自己的话说,该证据是间接的:SoLU 会抑制分散在许多神经元上的激活,一个额外的 LayerNorm 能恢复性能,而在 LayerNorm 之后,神经元的弱激活看起来与其主要职责的关联性降低了,论文将此解读为特征通过小的激活被“偷运”过去。我们把它解读为关于一个为抑制分布式表示而构建的架构中的分布式表示的证据,而不是关于神经元把无关的东西打包在一起的证据——后者才是我们关心的含义。即使用今天的工具,要在弱激活中区分这两者也很困难,因为随着激活减弱,语义会同时向各个方向漂移;而在 2022 年,这对我们所有人来说就更难了。该论文还指出,它关于 superposition 的讨论已被 Toy Models of Superposition 所取代,我们在附录中对此进行了回应。我们提起这一点并不是要批评任何一篇论文,而是因为据我们所知,这是唯一一处有人坦率说出真实世界证据多么匮乏的地方,而且我们认为人们至今仍常常假设证据比实际存在的更多。据我所知,自从我最初的那个发现(那是一个错误)以来,没有人再在真实网络中找到一个 superposition 电路。我在真实模型中没有看到任何类似的东西,尽管我一直预期会看到;而且我认为声称发现它应该有很高的门槛,因为这是一个如此激进的解释,而且对我们应该如何研究神经网络来说,这将是个大新闻——坏消息。
当然,这也有陷入相反错误的风险——一种“填补空白的解释”(an explanation of the gaps):假定每个神经元都必须有一个说得通的故事。有两点让这种担忧减轻。首先,其他每种成因都是可以被检验的。更好的工具要么能把神经元解释清楚,要么不能;用更好的架构重新训练可以表明问题是否出在学习上;而 recursive generalization 可以在其成长过程中被小步观察到。Superposition 唯一的症状就是“某处讲不通”。其次,真正的解释往往是狭窄且易于检验的。一旦你怀疑某个神经元是 Colorado neuron,就去 steer 它,看看它会说什么。如果一个神经元因某种狭窄的电视桥段而激活,那么能算作该解释的事物集合非常小,而“讲不通的东西”却涵盖了它之外的一切。
另外,我们也不必强行给出我们并没有的解释。如果一个神经元可能在做一些互不相关的事情,而你又不确定,直说也无妨。我认为 recursive generalization 应该排在怀疑清单的前列,而且如果你有训练 checkpoint,验证起来很容易。而现在我认为 superposition 应该被排到清单很靠后的位置。
探索图像模型
小型图像模型可能看起来已经过时,但我认为它们对这个问题非常重要,因为我们可以把它们看得非常清楚。最初的担忧很大程度上也正是源自它们:在那里,我们看到的是看似高分辨率的混沌,而非低分辨率的模糊。语言模型规模庞大,我们没有像 feature visualization 这样让工作变轻松的工具,attention 把不同类型的机制混在一起,而且它们的许多 motif 都出人意料。正如我在上文所示,即便是视觉 motif 也可能反直觉,语言则更糟。这些缺陷中的每一个都可能让一个 monosemantic 的神经元看起来是 polysemantic 的。当你看着一张模糊的图像,试图判断它是狗还是猫时,模糊让它更难判断,但不会偏向任何一方。而当你看着一张模糊的图像,试图判断是图像本身模糊还是你看得不清楚时,你视力中的每一个缺陷都会被算作图像的模糊。如果我们想研究神经元如何随规模、压缩压力、激活强度和深度而变化,最好从我们能看清楚的地方开始。
我训练了三个 ConvNeXt 模型,规模跨度约为 300×:一个小的有 92k 参数,一个中等的有 7.06M(与 InceptionV1 相同规模),还有一个大的有 28.6M。我们将考察这些模型以及 InceptionV1,试图理解神经元在不同情境下的行为,并尝试找到 packing 可能形成的地方。
我如何看待神经元
我过去把神经元看作人类式的名词:一个是“汽车”,另一个是“曲线”。现在我更多地把它们看作 control flow(控制流)。一个神经元的关键不在于它看到了什么,而在于它对流入的信息流做了什么,它的职责往往是给网络的某个区域当闸门。这样看来,monosemanticity 几乎是个问错了的问题。更好的问题是:一个神经元放行了什么,又拦下了什么。
像素输入进来,网络开始对事物进行分组和区分。汽车和狗可能会被归为一组,因为它们共享某种姿态。再往后,会出现更具体的汽车探测器——针对出租车、救护车之类——而它们不想要狗。因此在它们之前的一个神经元充当闸门:它对汽车响应为正,对狗响应为负,其负向一侧把狗拦在外面。狗则继续流向它们自己的区域,那里不必再操心汽车。更靠后的神经元在此基础上进一步特化:一个救护车神经元的负极上可能是出租车,而出租车的负极上是救护车。在更大的模型中,这些区分可以变得更细,把出租车的一种视角与另一种视角分开。较小的模型可能止步于更粗的区分,拥有某种更接近通用“汽车”的神经元。
汽车和狗在早期共享某种姿态;汽车探测器之前的一个闸门放行汽车,并用其负向一侧把狗拒之门外。
下面是一辆真实的跑车,跟随它走过我们大型模型的最后五个 block。走到中途,它与其他矩形形状(如桌子和橱柜)归为一组,与蛇和狗相对。到最后一个 block,分界变成了敞篷车对阵旅行车。
这辆车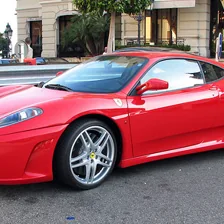
跑车
Block 14 · 203
轿车和豪华轿车
对比公交车和有轨电车
Block 15 · 920
桌子和柜子
对比蛇和狗
Block 16 · 609
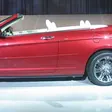
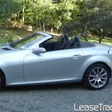
敞篷车、跑车
对比小巴
Block 17 · 1455
敞篷车
对比厢式车与旅行车
Block 18 · 632
敞篷车
对比旅行车
一辆选定的跑车,在 ConvNeXt large 的 18 个 Block 中的最后 5 个里逐层追踪。每一列是对这张图上下一列贡献最大的神经元(最后一列则贡献给跑车的输出)。线上方是它把该车归入的类别;线下方是它将其区分开的类别。
要理解神经元,其负向一侧与正向一侧几乎同样重要,即使在负向一侧被截断的 ReLU 网络中也是如此。神经元由投票构成:每个输入权重为它的正向一侧或负向一侧投票,票数在非线性之前累加。负向一侧自身永远不会获得梯度,但只要神经元处于激活状态,单个票就会获得梯度,因此它同样由学习塑造。负向一侧的含义取决于上下文:当跑车路径中的一个神经元把它与蛇和狗区分开时,它并不是在说汽车和狗是对立面,只是在门控掉此前被有效归为一类的东西。负向一侧告诉我们,在这个电路的这个节点上,哪种区分是重要的,这也使其成为检验一个归类是否真实存在的快捷方式:V 神经元的负向一侧是一个 O。
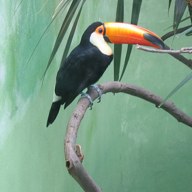
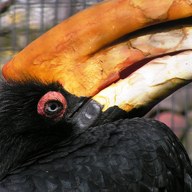
如果我们看最后一层,就能看到高层模式以及它们被与之区分开的东西:出租车区别于救护车,西兰花区别于花椰菜,琵鹭区别于火烈鸟。
+出租车
 −救护车
 +西兰花
 −花椰菜
 +琵鹭
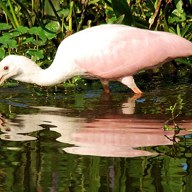
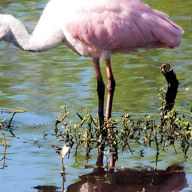 −火烈鸟
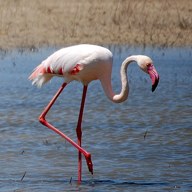
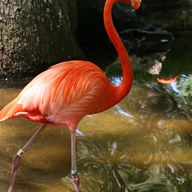
来自 ConvNeXt large 的最后一层神经元:每个神经元对一种模式有正向响应,而对一个密切相关的模式有负向响应。
更多示例
+巨嘴鸟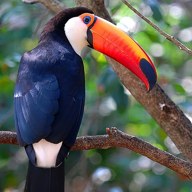
 −犀鸟
 +灯塔
 −水塔
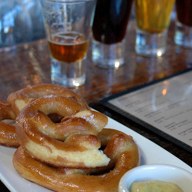
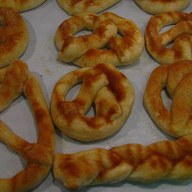
 +椒盐卷饼
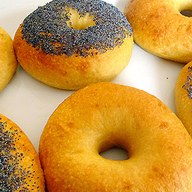
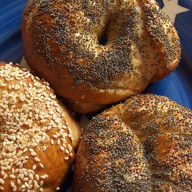
 −贝果
 +狼
 −哈士奇
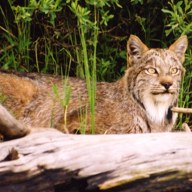
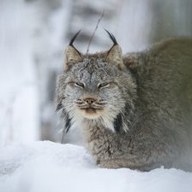
 +家猫
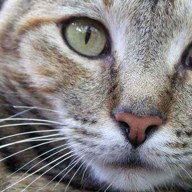
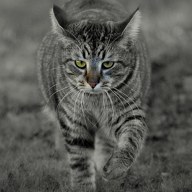 −猞猁
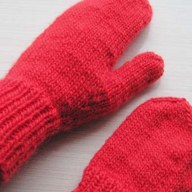
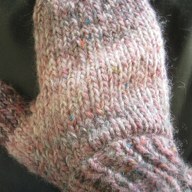
 +连指手套
 −袜子
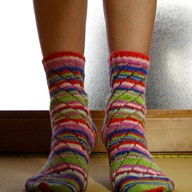
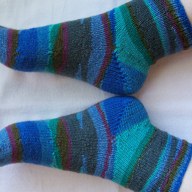
每个极点最强的两张图像。符号表示 neuron 自身的响应,而非其对下游的影响。最后一个 block(stage3.block2)中的 neurons:出租车 230、西兰花 829、琵鹭 1440、巨嘴鸟 2021、灯塔 1956、椒盐卷饼 1068、狼 401、家猫 1637、连指手套 63。
当我们观察最小的模型时,会发现神经元变得更加粗糙。它的最后一层在一个神经元中同时对应汽车、火车和手推车,而其负向侧则对应船只、飞机,以及一种水上的牛车(我甚至都不知道这种东西存在)。它仍在进行区分,只是更粗糙,而且更早地停止了。
 拖曳卡车
 有轨电车
 搬家货车
 消防车
 休闲旅行车
 轿车
 拖挂卡车
 小型巴士
−
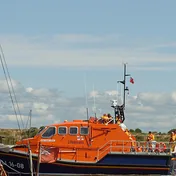 救生艇
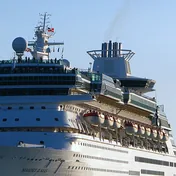 邮轮
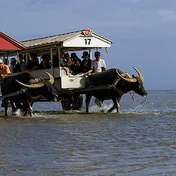 牛车
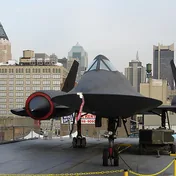 军用飞机
小模型的最后一层神经元:正向侧是地面交通工具,负向侧是船只和飞机。
压力之下神经元的表现
在大多数视觉模型中,早期层是单语义(monosemantic)的。据我的理解,标准的解释是:需要表示的早期视觉特征并没有那么多。从表面上看,有点奇怪的是,从 AlexNet 到 ResNets,再到 InceptionV1 和 CLIP,每个模型在早期特征与早期神经元的比例上都恰到好处,而它们的数据集规模与参数规模之比却千差万别。
我们可以重点关注 InceptionV1 的 3b 层,这一层包含 Curve Neurons 和 High-Low Frequency neurons,在我看来它们属于最基础的神经元之一。该模型没有 residual stream,因此神经元无法“绕流而过”。于是我们可以通过把数量从 480 减少到 10 并重新训练,来测试空间不足时神经元会发生什么。
如果它切换到了叠加(superposition),我们应该会看到彼此重叠的混合物,比如曲线检测器加上橙色螺旋,再加上蜘蛛网以及若干其他纹理检测器。我们把它压缩了 48 倍,效果应该会非常戏剧化!
但这并不是我们观察到的结果。神经元依然保持可解释性和泛化性,只是变得更粗糙:一个“曲线与环形”神经元取代了十个曲线检测器,两个圆形神经元取代了多种圆形类型,依此类推。
黑眼圈
 红色
 黄色
 斜向边缘
 垂直边缘
 眼睛与面部
 曲线与环形
 圆形
 高频
 彩色标记
InceptionV1 从头重新训练,layer 3b 从 480 个神经元削减到 10 个,且没有绕过该层的 bypass。每一行是一个神经元及其激活最强的五个自然图像裁剪。ImageNet top‑1 准确率为 58.35%,top‑5 准确率为 81.14%。
详细信息
首先是优化图像,然后是 50,000 张图像扫描中响应最强的 10 张。可按激活值和排名选择裁剪。
深色圆圈 红色
 黄色
 斜向边缘
 垂直边缘
 眼睛与面部
 曲线与环形
 圆圈
 高频
 彩色标记
InceptionV1 从头训练,mixed3b 的空间通道从 480 个减少到 10 个,且该层周围没有 bypass。最终模型在 50,000 张留出的 ImageNet 图像上达到了 58.35% top-1 和 81.14% top-5 的准确率。
示例按 50,000 张训练图像上的图像最大值排序。网格显示每个神经元最强的五个;此处每个范围展示所保存示例中的十个。这些名称是初步的视觉描述。Path-guided 可视化使用了最强的 60 个示例。
我们可以显式地测试曲线,看看它们到底怎么样了。如果它们被存放在某些神经元的高维组合中,我们应该能够把它们提取出来。因此,我们可以在这一被压扁的层上训练一个 SAE,并与原始检测器进行比较。我们没有看到任何类似干净曲线神经元的东西!
原始 3b · 480 个神经元
十个曲线检测器
以 3b 为 10 个神经元重新训练
整个压缩层
压缩层上的一个 SAE
与每个检测器最接近的匹配
squeeze
曲线与环形
expand
InceptionV1 重新训练,layer 3b 被压缩到 10 个神经元,然后用稀疏自编码器扩展回原大小。每个原始曲线检测器的位置显示与之最接近的自编码器特征:宽泛且挤成一团,而不是十条清晰的曲线。
详细信息
压缩后的模型从头训练,mixed3b 从 480 个通道削减到 10 个通道且没有 bypass,在 50,000 张 ImageNet 验证图像上达到 58.35% top‑1 和 81.14% top‑5。该自编码器是一个 TopK SAE,有 640 个特征,每个位置 2 个活跃(即该文的 SAE 配方,再加上防止特征死掉的常规辅助损失),在压缩层上使用来自 200,000 张 ImageNet 训练图像的 2560 万个位置进行训练。它解释了留出位置 82% 的方差;将其拼接进模型后,10,000 张验证图像上的 top‑1 从 58.8% 降至 43.0%。
每个检测器及其最接近的 SAE 特征
| 检测器 | 偏好角度 | 宽度 | SAE 特征 | 偏好角度 | 宽度 | 形状匹配 | 照片匹配 |
|---|---|---|---|---|---|---|---|
| 3b:385 | 16° | 40° | 79 | 38° | 174° | 0.52 | 0.09 |
| 3b:343 | 84° | 40° | 64 | 84° | 64° | 0.72 | 0.14 |
| 3b:342 | 116° | 56° | 510 | 86° | 80° | 0.61 | 0.19 |
| 3b:388 | 166° | 40° | 174 | 192° | 44° | 0.38 | 0.11 |
| 3b:324 | 184° | 24° | 174 | 192° | 44° | 0.79 | 0.26 |
| 3b:340 | 214° | 42° | 435 | 232° | 146° | 0.48 | 0.08 |
| 3b:330 | 244° | 52° | 89 | 232° | 88° | 0.52 | 0.11 |
| 3b:349 | 272° | 34° | 277 | 278° | 64° | 0.60 | 0.18 |
| 3b:379 | 328° | 44° | 544 | 32° | 138° | 0.56 | 0.18 |
| 3b:406 | 356° | 26° | 354 | 334° | 94° | 0.42 | 0.17 |
Tuning 是在图像中心处对以 180 个角度和两种曲率绘制的细暗弧线的响应,如 Missing Curves 附录中所示。每个 detector 的 match 是在所有对绘制曲线响应最强的特征中,其 tuning curve 与该 detector 相关性最高的 SAE feature(即 shape match)。Width 是高于峰值一半的角度跨度;圆环中的 tuning curve 均各自按其自身峰值缩放。Photo match 是在 10,000 张 held-out 照片的每个位置上,feature 与同一位置的原始 detector 之间的相关性。
原始 detector 宽度为 24–56°,且在相反角度处无响应;match 的宽度为 44–174°,且在相反角度处仍保持响应,其中 3b:388 和 3b:324 共享同一个 feature。在 91 个对绘制曲线响应最强的 feature 中,没有一个在相反角度处无响应。若去掉这一筛选条件,可以找到形状更接近、更窄的 feature(0.63–0.98),但它们对绘制曲线的响应仅为其通常强激活水平的 9–42%(原始 detector 为 72–183%),且在照片中对 detector 的追踪程度更低(0.02–0.12)。该 essay 对原始层运行 SAE 时,能以 0.96–1.00 的形状相关性匹配到相同的 detector。而在 squeezed layer 上,即使对同一位置的十个神经元采用最好的非线性 readout,对每个 detector 的追踪相关性也仅为 0.29–0.48。其他 autoencoder 也呈现出同样的情形(1 到 4 个 active feature、160 或 640 个 feature、第二个 seed、或去掉 auxiliary loss):shape match 中位数为 0.47–0.63,photo match 至多 0.27。当有 3 或 4 个 active feature 时,preferred angle 对齐得更好,但曲线仍然又宽又双侧。
Control
优化图像对 squeezed neuron 使用该 essay 的 path-anchored 配方(即生成原始曲线图像的那一种),对 SAE feature 使用其 SAE 配方(即 Missing Curves 背后的那一种)。path 权重按每个 unit 的激活范围进行缩放,因为 squeezed layer 的激活值比原始层小数百倍。将相同的 SAE 配方用于该 essay 对原始层的 SAE 时,可以画出干净的曲线:
Squeezed neuron 的照片
曲线与环形 圆形
 深色圆形
 眼睛与面部
 斜向边缘
 竖直边缘
 高频
 红色
 黄色
 彩色标记
挤压神经元(Squeezed‑neuron)的名称是临时的视觉描述。照片对每张神经元图像在 50,000 张训练图像上的最大值进行了排名。
我认为这是一个很好的测试,用来检验我们是否能够将一个我熟悉的、已知处于叠加(superposition)状态的单义层(monosemantic layer)转化出来。但在某些方面,这并不理想,因为人们主要怀疑最后几层存在叠加现象。因此,我们可以使用中等大小的 ConvNeXt,压碎最后一层,阻止其绕过残差流(residual stream)进行路由,然后看看它学到了什么。我们看到了同样的模式:它变得宽泛。
这也是我们在小型 ConvNeXt 中观察到的情况,它在某种程度上是一个非常相似的测试。
03 过渡期与小型哺乳动物
+正面:−负面: 选择一个神经元
中等大小 ConvNeXt,其最后一层从 1,024 个神经元削减至 13 个,并从零开始训练。每个神经元的最强正面和负面图像。
晚期电路
我们还可以查看晚期层中的电路,以排除最后一层以某种方式特殊的任何可能性。我们看到它在整个过程中都是有组织的。
修道院
瓢虫
拖车
草莓
小丑鱼
正面归因负面归因
五个电路,每个电路沿着选定的连接进入跨五个块的最后一层神经元。每个神经元显示一个优化图像和四个数据集示例。
字典学到了什么
如果神经元的组合隐藏了某些东西,那么字典(例如 SAE)应该能找到神经元所缺乏的构建模块。因此,我在这些层上训练了几个字典,并亲自和通过 Agent 进行搜索。但我没有找到任何这样的东西。
大多数情况下,这两者看起来就像它们在机制上是什么:神经元像构建模块,SAE 单元像按上下文分组的这些模块。这在蜘蛛身上表现得最清楚。SAE 单元是不同环境下的蜘蛛;神经元则是腿的图案和网。它们之间的分歧并不大。
SAE 确实有助于回答“这张图片里有什么?”它们在最小的模型中帮助最大,因为该模型的神经元较粗糙。在中等大小时,我稍微更喜欢它们;在大型模型中,我认为我更喜欢神经元。但我更关心理解网络,而不是任何一张特定的图片,而且我从未见过 SAE 掌握神经元所没有的根本性内容。如果某个特定大小的模型无法理解棒球运动员,那么它的 SAE 也无法理解。当模型最终理解棒球运动员时,那是基于一个神经元。
SAE 找到了哪些没有明确神经元对应物的东西?在最后一层,其 88% 的活动是单个神经元的近复制品,其余部分很微弱:移除所有不与任何神经元匹配的字典方向,准确率保持不变,而它翻转的少数答案原本就是接近平局。此外,如果你在层的旋转中搜索那个让少数单元承载最多活动的方向,从随机一个开始,你最终会回到神经元上,在每个块中都是如此。在少数足够强大值得观察的特征中,SAE 添加的是由现有神经元构建的松散分组,例如在水面上的动物或苍白、凹凸不平的食物。我们在其中发现的任何东西看起来都不像根本性的新构建模块。
1 of 16
水面上的动物特征 6717−
 由以下神经元构建
 733 0.19
 170 0.17
 920 0.17
 482 0.15…
每个新增特征都会展示它是从哪些现有神经元构建而来,以及各使用了多少。“典型特征”展示的是那些由单个神经元的近似拷贝构成、构成了该 SAE 大部分的特征。
第 1 张,共 16 张
罕见事物与记忆
对隐藏特征的许多担忧都来自罕见事物。它们很少与其他任何东西发生碰撞,而且看起来似乎不值得为它们专门分配一个神经元。所以我们从能想到的方方面面考察了罕见事物。罕见类别往往更加整合:ImageNet 需要许多狗的模式,但只需要一个 Triceratops 神经元。当我在最后阶段移除弱激活时,没有任何类别显得突出。我们追踪的对抗样本使用的都是正常的语义回路路线。
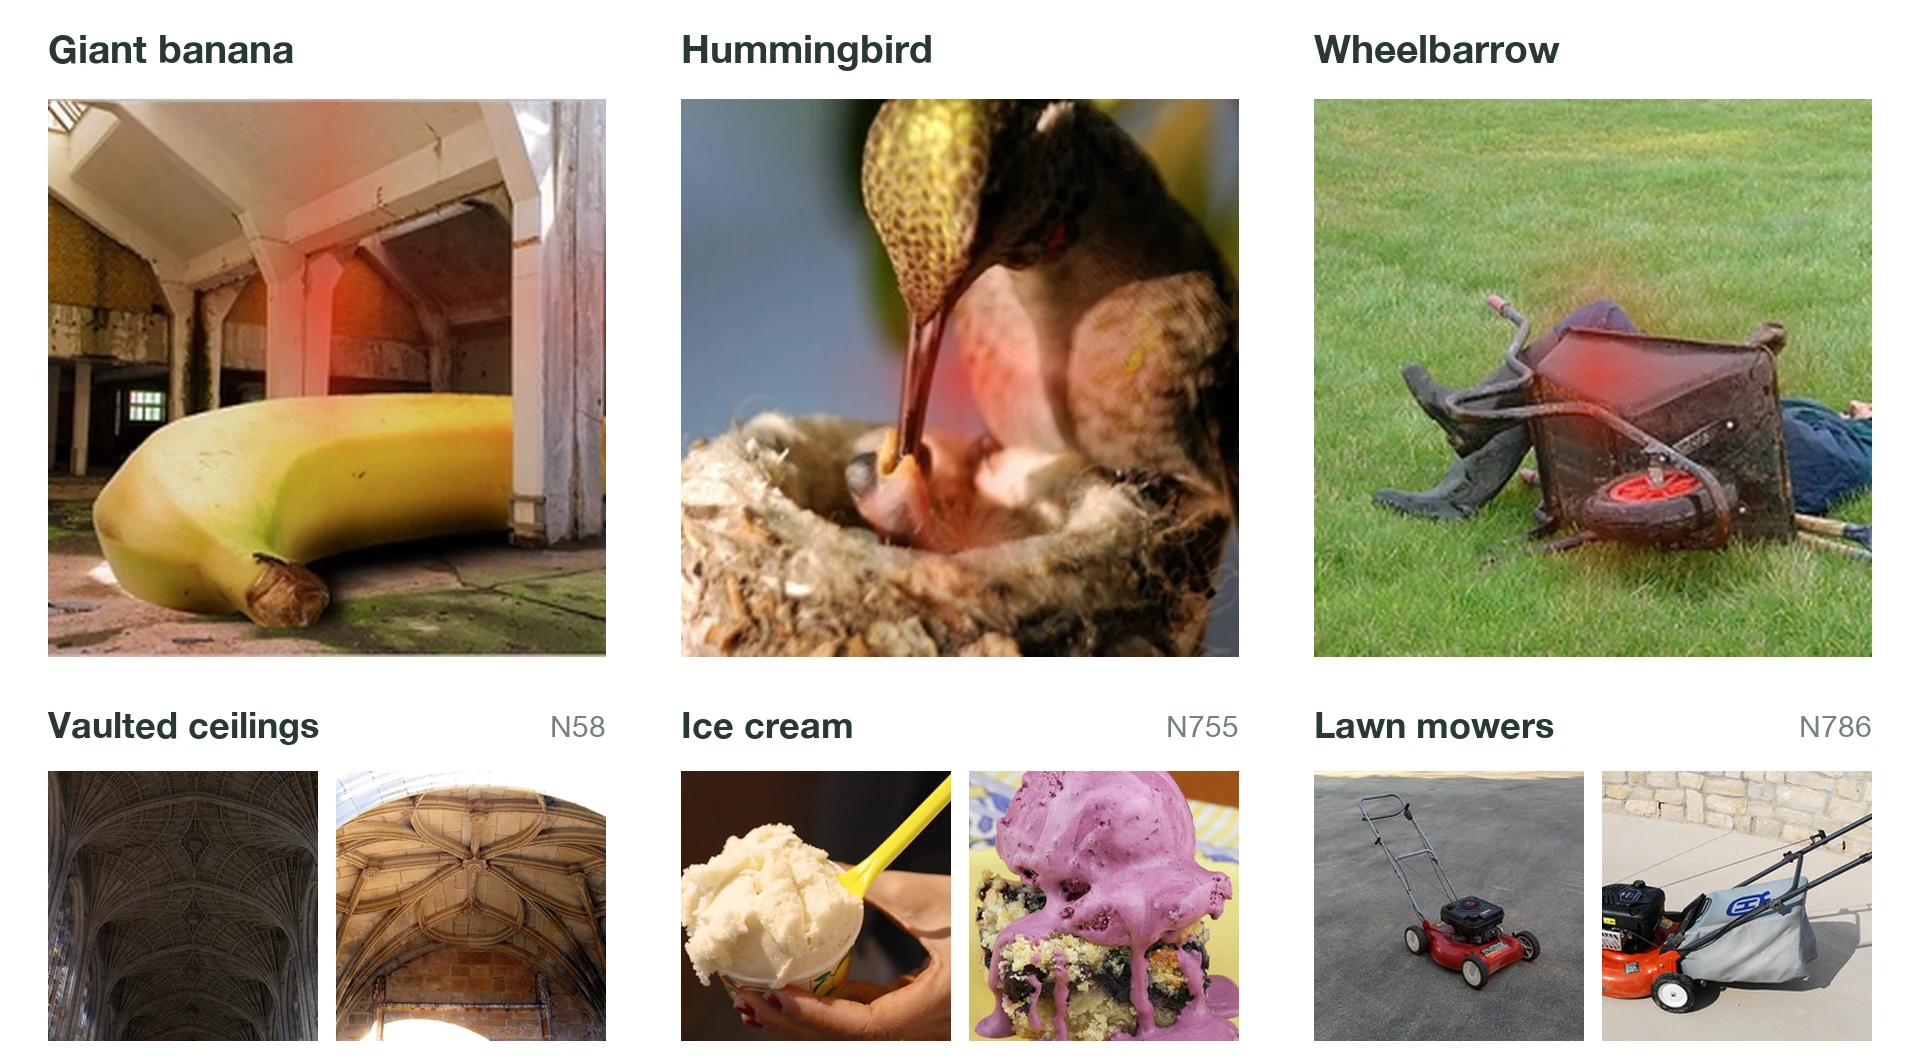
我查看了那些在最后几层中的表示与其他任何图像距离最远的图像。结果发现它们是一些有趣又古怪的图像,模型用普通神经元误读了它们:一只蜂鸟被看成冰淇淋,一根巨型香蕉被看成金库,一个躺在翻倒独轮车里的家伙被看成割草机。我还训练了一个 ImageNet 模型,让它把随机噪声映射到随机标签,即便如此,它也在一定程度上是语义化的:它部分依赖于羊毛纹理和远处树木的纹理,这些纹理是高频的,有点像高频噪声。我没有对这个模型做全面审计,但它竟然用到了这些,我觉得很有意思。在语言和视觉的所有实验中,记忆都倾向于尽可能靠近输出端,因为它只需查找答案即可,而最后几层也确实完成了大部分工作。
不寻常的图像,普通的机制。上:测得的响应图。下:通过消融测得的、每张图像最具支持性的最后一层神经元的自然示例。
我们也可以自己制造一条罕见的路线:用某种无意义的知识训练我们的 7.06M 参数模型——一张雨伞的照片是蜜蜂。你可以想象这种记忆不依赖任何其他东西:一个隐藏特征锁定这组特定的像素并输出“蜜蜂”,与网络其余部分断开,因为它并不需要它们。那将是相当糟糕的消息,但实际发生的情况完全不是这样。在九个训练步内,最高猜测从雨伞变成五朔节花柱,再变成蜜蜂。雨伞神经元逐渐消退,已有的蜜蜂神经元被激活,这几乎全部发生在最后三个块中:只要把这些块换入原始模型,它就会输出“蜜蜂”。
一把雨伞切换到蜜蜂路线
这张照片,原始模型 学会“蜜蜂”后 每个回路在自然图像上的表现
条形图显示模型学会“蜜蜂”前后各神经元对这张照片的响应;刻度线是其对典型雨伞或蜜蜂的响应。图像显示每个神经元最初响应的内容;连线是通过消融检验的连接。
这是与学习某种独立于其他所有正常雨伞或蜜蜂路线的隐藏雨伞特征相对比的情况。虽然这是可能的,但我认为它比组装那些已经在激活、且拥有通往输出路线的相关部件学得更慢,后者赋予了它可塑性和梯度。它也更加脆弱,而且并不是我们在任何地方看到的情况。
一个游离的叠加特征
实际发生的情况
记住一个无意义标签的一种方式,可能是一个不与任何东西相连的特征。而我们实际看到的,是网络已有的两条路线之间的一个出口匝道。
弱激活重要吗?
当人们问弱激活是否重要时,我认为其中混杂了几个问题,而它们各有不同的答案。
它们是泛化还是叠加?
不出所料,我认为是泛化。想象你是一个被打包压缩的、互不相关的特征,正努力避免与主神经元中的内容发生碰撞。弱激活密集得多,因此你会与多出几个数量级的东西发生碰撞,而好处却微乎其微。
强的一半 0 最大值的一半 最大值
通过一个 Qwen3-32B 神经元处理 1 亿个 token。绝大多数激活值接近于零;大约 160 个达到较强的半区。
但也许你可以隐藏在许多神经元同时产生的弱激活中。我们的观察结果是,你可以几乎零成本地消融(ablate)网络中几乎所有的弱激活。移除这些激活代价最大的地方,是一些最容易理解的地方。在语言模型中,它们包括最后一层,该层主要用于抑制单个 token,用于我们所谓的“说还是只思考”模式。在视觉模型中,它们是早期层,其功能类似于旋钮:稍微亮和中等亮之间的差异很重要,但对于像国王企鹅这样的后期检测器来说,低或非常低的证据并不重要。因此,关键的常见事物不可能存在于弱激活中,因为我们可以移除它们。
我们还可以看看切断弱激活时会失去什么。在几种类型的研究中,通常只是神经网络已经感到困惑的事物之间的细微差别。而引发这些细微差别的微弱激活来自你预期的语义相关神经元。
移除最弱的 75%
准确率 72% → 71% · 10 个答案中有 1 个发生变化
移除最强的 7%
准确率 72% → 4% · 100 个答案中有 96 个发生变化
与最弱 75% 相同的总激活量
接近平局
确定答案
移除最弱 75% 移除最强 7% 移除最弱 75% 移除最强 7%
 爱斯基摩犬(其前两名中的 54%)移除弱激活:变为西伯利亚哈士奇移除强激活:变为天鹅绒
 蚱蜢(其前两名中的 56%)移除弱激活:变为蟋蟀移除强激活:变为蚊帐
 惠比特犬(其前两名中的 57%)移除弱激活:变为萨路基犬移除强激活:变为间歇泉
 虎猫(其前两名中的 62%)移除弱激活:变为虎斑猫移除强激活:变为间歇泉
 垃圾车(其前两名中的 100%)移除弱激活:相同移除强激活:变为铲子
 蜂鸟(其前两名中的 100%)移除弱激活:相同移除强激活:变为青苹果
 棕熊(其前两名中的 100%)移除弱激活:相同移除强激活:变为喷泉
 斑马(其前两名中的 100%)移除弱激活:相同移除强激活:变为湖边
Medium ConvNeXt,共 18 个块。每个条形图在移除任何内容之前将模型的前两个答案分开。
这留下了罕见数据和强但非极端强的激活。
正如我们之前所见,罕见事物在我们进行的每项实验中都在相关电路上生长,因为它们不够强,无法形成自己的生态位。上面的消融也指向同一方向:如果罕见案例存在于弱激活中,切断它们应该会直接破坏某些答案。相反,每个变化都很小,只是接近平局向一方或另一方倾斜。
至于那些强但非极端的激活,我们可以直接观察。在我所知的每种情况下,它们在语义上向外辐射:对于 CLIP 的特朗普神经元人工神经网络中的多模态神经元 Goh, G., Cammarata, N., Voss, C., 等人,2021。Distill。参考文献 ↓,特朗普的照片,然后是与他相关的艺术和人物,然后是福克斯新闻演播室。你越往下走,就越容易被看似无关但实际上有关的事物所欺骗。至少,查看数据点流经的电路;这里微弱激活的地方可能在上一层强烈激活过。
以下是语言模型中五个神经元的所有强激活情况。中心代表每个神经元的最大值,随着向外辐射,相关性逐渐降低。灰色区域表示难以归类,通常这些神经元仍然具有关联性,但需要更多工作来理解,因为它们的相关性较远。你可以点击任意一个来展开查看每个激活来自哪些电路。
Qwen3-32B 中的五个神经元
五个神经元的所有强激活情况。中心是每个神经元的最大值,环代表其分数比例,颜色表示激活的主题。灰色代表基线。点击一个进行探索。
悬停在一个点上以读取其激活原因。空心点表示未解析。悬停在一个颜色上以隔离它。放大以查看提示词。
电路
按强度分类的激活主题
百分位数还是原始激活值?
我过去习惯于使用百分位数,因为它们易于思考,并且可以在不同神经元之间标准化。但我逐渐认为,神经元的原始形状告诉我们一些事情。有些神经元在很宽的范围内保持其含义;而另一些则像上面的“圣诞神经元”一样,在达到最大值的约 5% 时急剧下降。有些神经元在一本书中只激活几次,而在另一本书中可能在一页纸上就激活几次。百分位数会抹平这种差异,而这往往是判断你是在观察一个“旋钮”(中间值很重要)还是一个“检测器”(中间值通常不重要)的关键。
百分位数也会扰乱直觉。第 99 百分位数听起来很高,但每 100 个 token 出现一次,大约相当于四分之一页。对于一个涉及特定情感或社会背景的神经元——这类神经元在语言模型中随处可见——如果它在一页纸上出现四次,那就不太合理。使用“页”作为单位来思考会更有帮助:第 99.9 百分位数大约每两到三页出现一次,第 99.99 百分位数大约每 25 到 30 页出现一次。
你需要它们来标记神经元吗?
通常不需要。在手工查看数千个语言模型归因图后,很难过分强调神经元作为“类比器”的作用。如果你在讨论乘船旅行,模型可能会认为这有点“泰坦尼克号”风格。我认为通常没有必要去考虑一个“航海特征”分散在泰坦尼克号神经元的弱激活以及其他神经元的激活中。相反,存在一种“泰坦尼克号式”的机制:每当出现类似泰坦尼克号的情况时,它就会激活,其权重是对泰坦尼克号式事物的投票。因此,你查看顶部激活值,发现它是泰坦尼克号式的,这个标签通常在你后续的审计中都能成立。如果你确实关心某个特定的激活值,你可以追踪其路径,消融电路,并继续放大到几乎任意的分辨率。
我的主要结论是:如果一个弱激活看起来无关,除非你仔细检查过它,否则不必过于担心。在我手工追踪的数百个案例中,几乎所有都证明是相关的,通过合理的电路连接;只是在追踪之前,这种关联性在视觉上并不明显。
许多案例非常巧妙,例如一个“禅宗公案”神经元,它在数学递归中微弱激活:许多公案都依赖于同一种自指结构,寻找观察者。另一些则更遥远且丑陋,不一定是我能直观画出的连接,但你通常可以追踪到它是如何到达那里的。我怀疑大多数,甚至几乎所有,都是这种情况。
探索语言模型
本节由我和 Curt 共同完成,并引入了我们即将发表的技术论文中的实验,该论文深入研究了语言神经元,因此本节我将使用“我们”作为主语。
语言模型如此庞大,难以精确验证关于神经机制的主张,但我们可以检查简单的故事是否同样适用。我们从 Anthropic 的 电路生物学 中喜欢的一个医疗诊断归因图开始。 大型语言模型的生物学 Lindsey, J., Gurnee, W., Ameisen, E., 等, 2025. Transformer Circuits Thread. 参考文献 ↓。他们正在使用 Crosslayer Transcoder 特征研究 Claude 3.5 Haiku。事实证明,这在 Qwen3-32B 的神经元中也同样适用。
由于它是原始模型,没有重建损失,也不需要进一步训练即可获得。其最大的 transcoder 预测下一个词与原始模型仅有一半的时间一致电路追踪:揭示语言模型中的计算图 Ameisen, E., Lindsey, J., Pearce, A., 等, 2025. Transformer Circuits Thread. 参考文献 ↓,并且它们的图需要错误节点来表示它遗漏的内容。
⚠️ 原文较长,超出部分未翻译,请通过上方原文链接查看完整内容。