阿里巴巴发布 Qwen4-Max:2.4 万亿参数,会开 Blender 建模、用虚幻引擎做游戏、给汽车零件编加工程序
原文链接: https://qwen.ai/blog?id=qwen4-max 来源: qwen.ai 发现于: 小互 · AI 解读站 · 2026/11/16 说明: 本文由 AIHot汪 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)。正文取自小互 AI 解读
Full Markdown · Member
Author: Qwen Team (Alibaba) 11-16 · ~18 min ⚑ Product Release
The Qwen Team at Alibaba has released the next-generation flagship model Qwen4-Max, positioned as an "all-day AI new colleague": it can use professional software, push long tasks forward step by step, and finally deliver ready-to-use results. It is the first model in the Qwen4 series.
Key upgrades of Qwen4-Max:
Brand-new architecture 71 billion parameters activated per token, about 25% less than the previous generation. 2.4 trillion backbone, plus 328 billion N-gram lookup table parameters; simultaneous changes in attention, residual, and embedding layers make long texts cheaper, with no loss spikes during training. See architecture → Sees more, writes longer 1 million token context, native image and video viewing, single output up to 393k tokens (previous generation was 131k), fewer cuts for long reports and long code. See specs → More efficient, cheaper 11.16 RMB average cost per task in Alibaba's internal industry task tests (previous generation 26.58 RMB), 24%–49% fewer tokens for same-tier inference intensity; API input and output each dropped by about 17%, cache hit price dropped to one-third. See bill → Knows how to use professional software 90 MCP tools called in financial investment research Blender modeling, Unreal, Unity, Godot to make playable games, reading drawings to write machining programs for auto parts. See what it does → Delivers while doing long tasks 48 hours of continuous autonomous operation, from molecular design all the way to synthesizing new coolant samples Live Delivery hands over the usable first version first, then updates version by version, plugins are open source simultaneously. See live delivery → Scores have wins and losses 4 / 1616 items ranked first in tests Agent coding, long-horizon tasks, law, bioinformatics leading; terminal programming, reading charts, watching videos worse than Opus5.5. See report card →
Beyond the numbers, two judgments come first. It is not comprehensively leading in scores: head-to-head against Claude Opus5.5, it won 6 and lost 10; it wins more in professional Agent tasks; if you mainly write code in the terminal, first look at Terminal-Bench and ProgramBench, where it lags significantly.
What's truly worth looking at this time is what it does: making playable games in the Unreal Engine, organizing 198 scattered drafts into an 86-page due diligence report, and turning a new coolant molecule from a screen structure into a lab sample within 48 hours. With unit price and token usage both dropping, it's more cost-effective to have it do long tasks round after round.
Qwen4-Max Release Short Film
Report Card: Comprehensive improvement over the previous generation, mixed results against rivals
16 tests cover coding, office Agent tasks, long-horizon tasks, professional domains, and image/video viewing. First, comparing with itself: for the 15 items with previous generation scores, Qwen4-Max is higher in all, with the biggest increases in Long-Horizon Tasks Agents' Last Exam (27.9 → 46.7), Clinical Reasoning HealthBench Professional (39.6 → 60.0), and SaaS Workflow AutomationBench (56.2 → 72.5).
Next, comparing with rivals, the 16 items are ranked by Qwen4-Max's position among five models:
16 tests, Qwen4-Max ranking Five models on the same field: Qwen4-Max, Claude Opus5.5, GPT6.1-Sol, GPT6-Astra, Kimi K3.1 Coding Office & Agent Tasks Professional Domains Reasoning & Image/Video Viewing
Item 14 DeepSWEAgent Coding75.7 · 2nd highest 75.5 Kimi Agents' Last ExamValuable Long-Horizon Tasks46.7 · 2nd highest 43.4 HLAB-ValsLegal Agent21.3 · 2nd highest 11.7 Kimi BioMysteryBenchBioinformatics Research85.0 · 2nd highest 84.4 GPT6.1-Sol
Item 24 AA-BriefcaseKnowledge Work (Elo)1686 · Highest 1801 Opus JobBenchCareer Tasks68.5 · Highest 75.4 Opus APEX-AgentsProfessional Service Tasks72.1 · Highest 73.5 Opus AutomationBenchSaaS Workflow72.5 · Highest 73.3 Kimi
Item 32 CodeArenaWeb Development (Elo)1750 · Highest 1816 Opus HealthBench ProClinical Reasoning60.0 · Highest 66.0 GPT6-Astra
Item 45 ProgramBenchBlack-box Software Replication31.5 · Highest 65.0 Opus AgentArenaReal Agent Tasks7.5 · Highest 18.2 Opus Humanity's Last ExamInterdisciplinary Challenges51.7 · Highest 59.8 Opus ChartographyReading Charts54.2 · Highest 71.1 GPT6-Astra Video-IndexVideo Understanding68.1 · Highest 76.7 GPT6-Astra
Item 51 Terminal-Bench 4.0Coding in Terminal48.5 · Highest 67.2 Kimi
Agents' Last Exam lists only one GPT model; the 2nd highest 43.4 is tied between Opus5.5 and Kimi K3.1. On HealthBench Pro, Qwen4-Max's 60.0 is only 0.1 higher than Opus5.5. Head-to-head with Opus5.5: won 6 items, lost 10.
Among the 4 items ranked first, three involve models acting as professional Agents: Law, Bioinformatics Research, and Long-Horizon Tasks. Among the 4 items ranked second, APEX-Agents and AutomationBench are only about one point behind the first, JobBench is 6.9 points behind, and AA-Briefcase is 115 Elo behind. Coding needs to be viewed separately: DeepSWE is first, CodeArena is third, but Terminal-Bench 4.0 for coding in the terminal is last, and ProgramBench for replicating software is only about half of Opus5.5.
Comparing solely with Opus5.5, Qwen4-Max won DeepSWE, Agents' Last Exam, HLAB-Vals, AutomationBench, BioMysteryBench, and HealthBench Pro (the last one only 0.1 higher), and lost the other 10 items. Based on this score: for professional Agent tasks like Law, Bioinformatics, and Long-Horizon Tasks, it can compete with or even lead Opus5.5; in terminal coding, software replication, interdisciplinary challenges, and reading charts/watching videos, Opus5.5 and the GPT series are significantly stronger.

Original image of 16 tests: Dark blue is Qwen4-Max, light blue is the previous generation Qwen3.8-Max-0902, gray依次 is Opus5.5, GPT6.1-Sol, GPT6-Astra, Kimi K3.1. AgentArena has no previous generation score. Internal · Main Rival Claude Opus 5.5 Release: Coding, Vision, and Writing Significantly Upgraded, Surpassing Fable 5.1 in Multiple Benchmarks, Price Significantly Reduced | See These Practical Cases16 items, Opus5.5 ranks first the most (7 items). Want to know where it's strong and what it's like in actual use? Read this.
Uses fewer tokens, and is cheaper
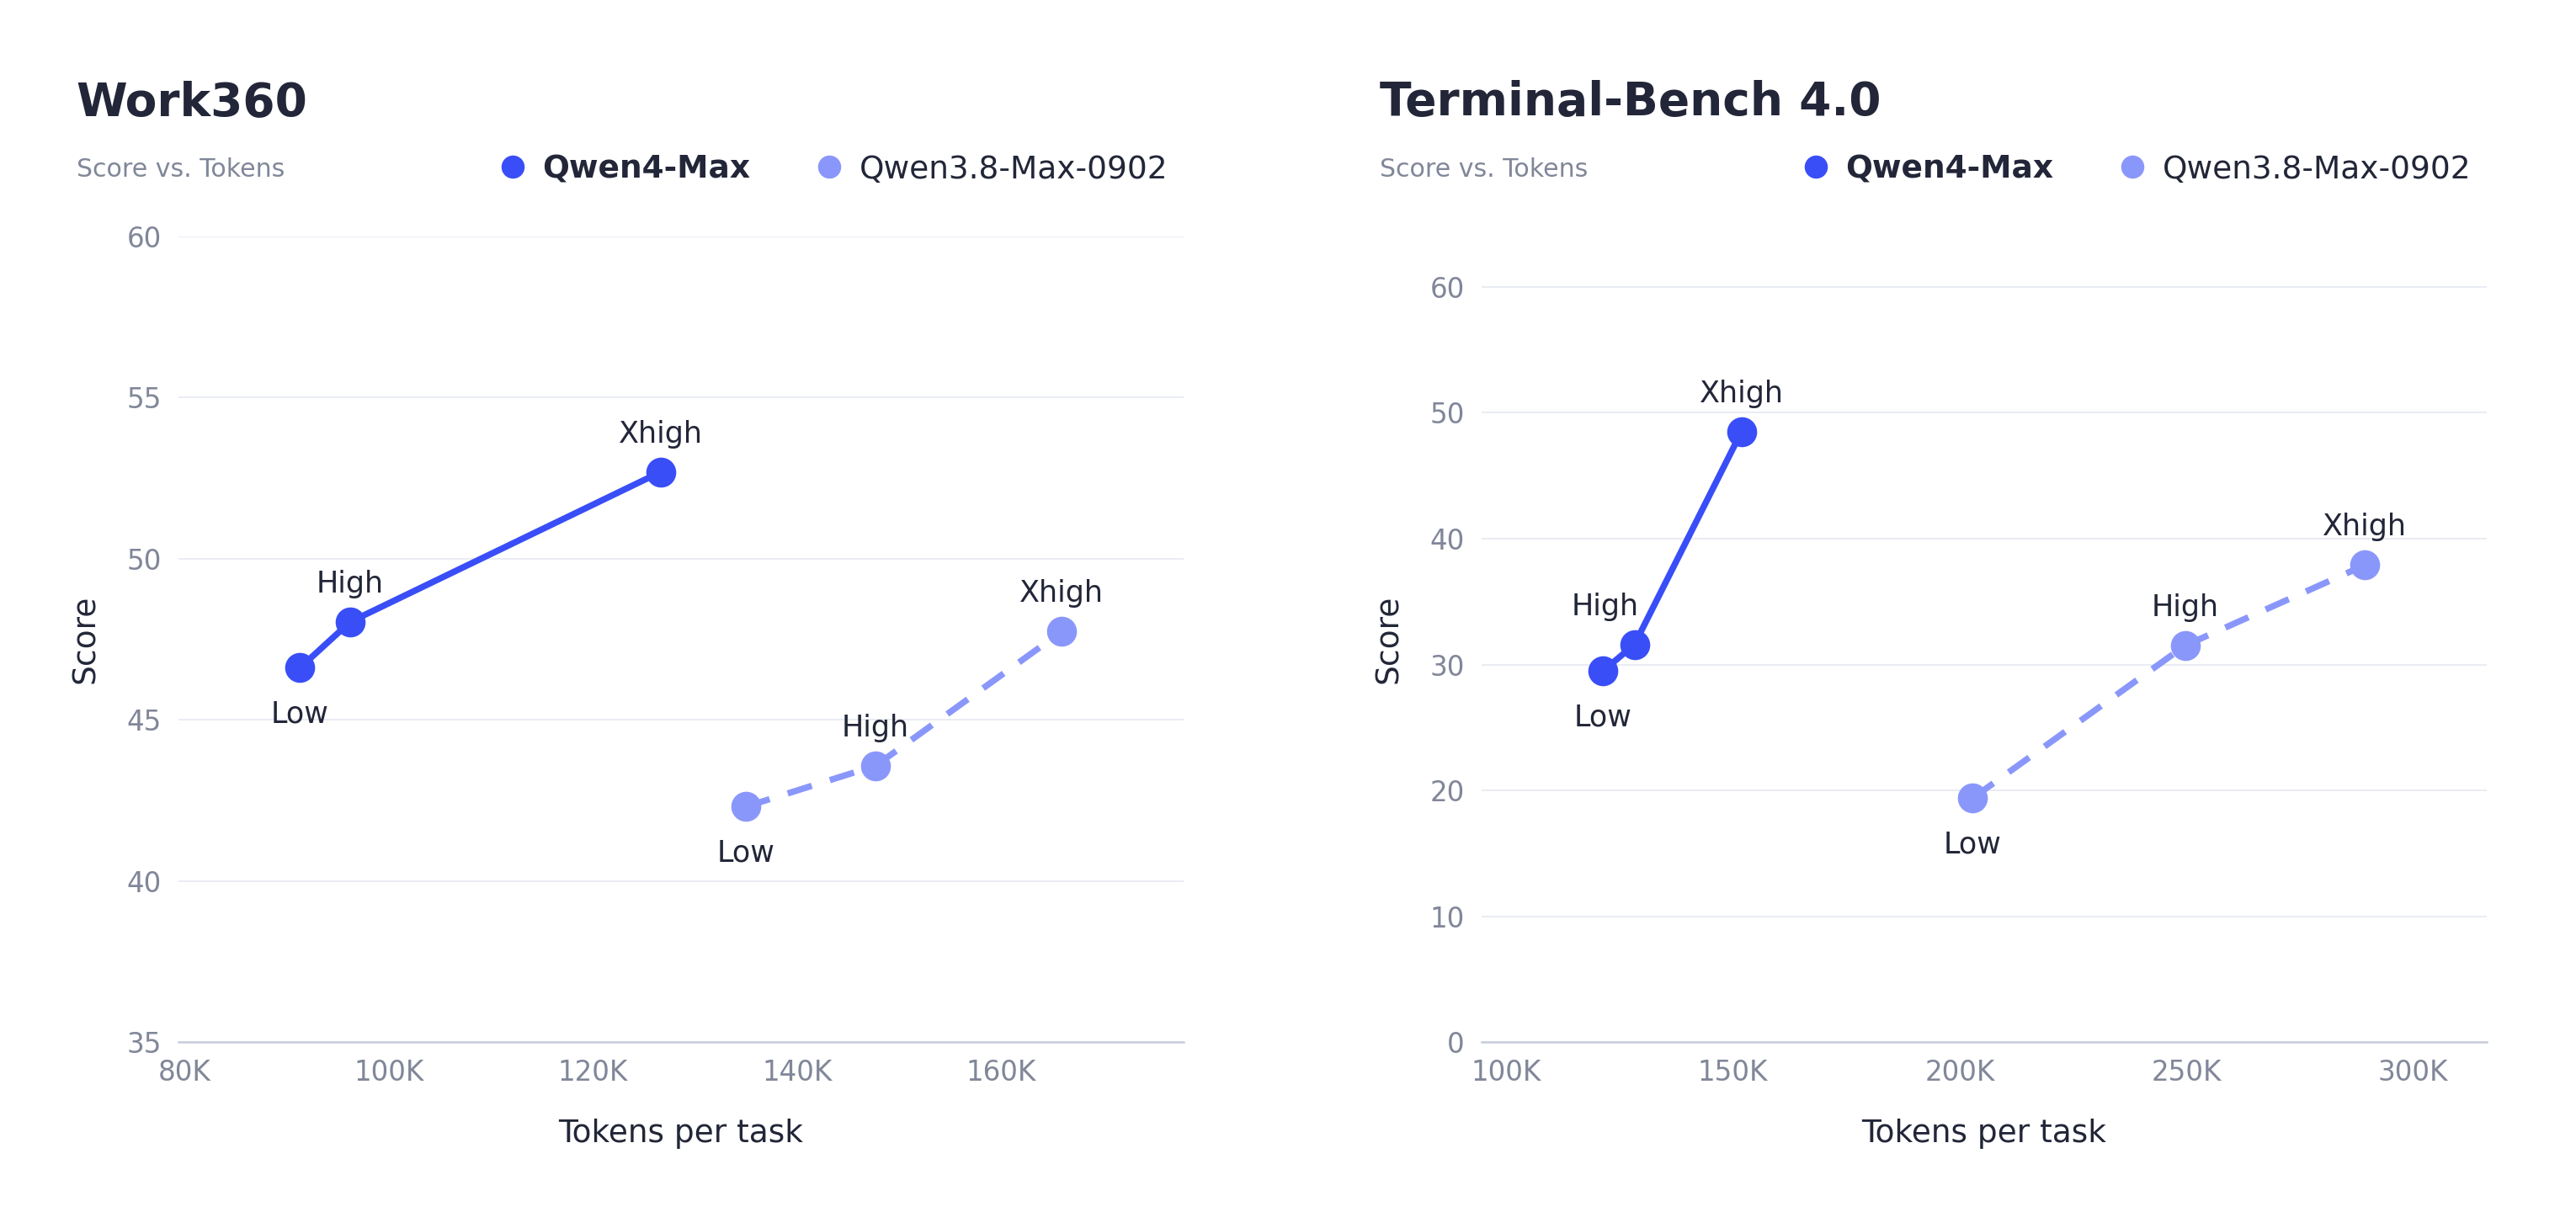
For the same question, the model can think shallowly and quickly, or think deeply and slowly. Qwen calls this reasoning intensity, divided into Low, High, Xhigh tiers; the higher the tier, the better the score generally, but the more tokens used, and the bill increases accordingly.
Qwen4-Max uses significantly fewer tokens at the same tier. On Work360, the Xhigh tier uses about 24% fewer, the High tier uses about 35% fewer; on Terminal-Bench 4.0, both tiers use about half. The scores are also higher: on Work360, its High tier is already slightly higher than the previous generation's Xhigh tier.

Scores and token usage: X-axis is tokens used per task, Y-axis is score. Solid line is Qwen4-Max, dashed line is the previous generation. Three points from left to right are Low, High, Xhigh tiers. The solid line is overall in the upper left: same tier, score持平 or higher, fewer tokens.
token 用量减少,单价又降低,两者叠加,使得单个任务的账单大幅缩减:
单个任务费用减半以上:单价降低,用量也减少 26.58 元→11.16 元−58%Work360 上单个任务的平均费用,Qwen3.8-Max → Qwen4-Max Qwen3.8-MaxQwen4-Max API 单价(每百万 token) 输入12 元**10 元−17% 输出36 元**30 元−17% 输入缓存命中1.5 元**0.5 元−67% 同一档推理强度下,每个任务消耗的 token(上一代 = 100) Work360Xhigh 档100**约 76−24% Work360High 档100**约 65−35% Terminal-BenchXhigh 档100**约 52−48% Terminal-BenchHigh 档100**约 51−49%
单价是千问 AI 平台上两款模型的按量标价。平台顶部「Token Plan 低至 5 折」是预付订阅的促销,并非 API 标价。
缓存命中的价格降幅最大,这对 Agent 最为有利:Agent 执行长任务时,每一轮都需要将之前的对话、文件和工具结果重新发送给模型,这部分内容大量能够命中缓存。另一个变化是单次最大输出量达到 393K token,上一代为 131K,撰写长报告、长代码时无需频繁分段。
新架构:总量不变,每次激活减少四分之一
Qwen4-Max 与上一代一样是 MoE(混合专家)模型:参数总量巨大,但处理每个 token 时仅激活其中一部分。上一代拥有 2.4 万亿参数,每个 token 激活 950 亿;这一代主干仍为 2.4 万亿,每个 token 仅激活 710 亿,另外增加了 3280 亿个 N-gram Embedding 参数。激活参数减少,计算更节省;能力更强,得益于三处结构改动。
改动一:长文本更便宜
这一改动带来的结果是:上下文再长,算力消耗也不会随之剧烈增长。模型每生成一个字,都需要回顾前文中哪些部分相关(这一步称为注意力机制),前文越长,成本越高。Qwen4-Max 每四层中,有三层替换为「压缩记忆」层(Gated DeltaNet,简称 GDN):边读边将内容压缩进一块大小固定的记忆中,前文再长也不会变大;第四层是「挑选细看」层(Qwen Sparse Attention,简称 QSA):先通过轻量级索引器对前文按块进行粗略扫描,仅细看相关的几块。
每四层:三层压缩记忆,一层挑选细看示意图 前文 token 逐个进入,按块分组 前文
压缩记忆层(GDN)占四层的三层
每读入一个 token,就更新一次记忆。格子数量固定,读得再多也不会增加格子。
读入 0 个 · 仍是 36 格
挑选细看层(QSA)占四层的单层
索引器先将每一块粗略扫描一遍,只将相关的块拿出来细看,其余跳过。
等前文读完
格子和块的数量均为示意。要点是:无论读入 24 个还是 100 万个 token,压缩记忆层的记忆大小保持不变;挑选细看层每次仅细看被选中的块。
改动二:训练更稳定
信息在几十层之间向上传递,依靠一条称为残差流的主干道。Qwen4-Max 将其扩展为四条并行支路(Gated Residual),每层通过开关决定从哪条读取、往哪条写入,跨层传递信息更顺畅,2.4 万亿参数的训练也更稳定。
改动三:不增加计算,多装载知识
第二层增加了一张大表(N-gram Embedding),根据相邻几个 token 的组合,直接查询「这几个字连在一起是什么意思」。查表几乎不消耗算力,却多装载了 3280 亿参数的知识。

**Qwen4-Max 的结构:**左侧一列是层的排布:GDN 和 QSA 按 3:1 交替。右侧放大的是一组层的内部:每层先从四条残差支路中读取(GR Read),计算完成后再写回(GR Write)。底部紫色的 N-gram Embedding 仅接入第二层。
这些改动的效果首先体现在训练过程中。大模型预训练常见的事故是 loss spike(损失值尖峰):训练误差突然飙升,轻则回滚重来,重则白白消耗一段算力。Qwen4-Max 在 2.4 万亿参数规模上全程未出现 loss spike,曲线一路平稳下降。

**Qwen4-Max 的预训练 loss 曲线:**横轴为训练进度,纵轴为训练误差,全程平稳下降,没有突然飙升的尖峰。
再看基础能力。将未经过后训练的基座模型用于「预测下一段文字」的测试,指标为 BPB(bits per byte,每字节比特数):平均每个字节需要多少比特去猜测,越低说明预测能力越强。在知识、代码、问答、STEM 四类内部测试中,Qwen4-Max-Base 均为五个模型中最低,比上一代基座低了约 5% 到 13%,而每个 token 激活的参数减少了约 25%。
激活参数减少四分之一,预测反而更准 Qwen3.8-Max-BaseQwen4-Max-Base
每个 token 激活的参数 激活950 亿**710 亿−25% 参数总量 两代相同 主干2.4 万亿**2.4 万亿持平
10 × BPB 越低越好 知识5.60**4.86−13% 代码1.88**1.67−11% 问答3.10**2.94−5% STEM3.04**2.70−11%
条的长度以上一代为 100%。BPB 为阿里内部测试数据。

**五个模型的 BPB 对比,越低越好:**括号内为激活参数 / 总参数。带星号的 GLM-5.3 和 Kimi-K3.1-Pro 是经过后训练的模型,与基座模型直接比较并不完全公平。
Work360:26 个行业的考卷
为了衡量模型在真实行业中能否胜任工作,Qwen 团队自行搭建了一套 Work360:先将行业拆分为 26 个一级领域、182 个二级子领域、721 个三级细分方向,从设计、金融、法律到农业、能源、芯片,再按此分类出题。

**Work360 的分类全景:**内圈为数字信息、专业知识、消费服务、公共服务、组织管理、第一第二产业六大类,向外依次为 26 个一级领域和 721 个细分方向。
题目是一份完整的工作单,而非问答题。例如会计审计中的一道「投资性房地产专项核查」,要求模型基于一家公司的财务与业务资料,执行检查、重新计算、分析三类审计程序,提交一份 Excel 工作底稿(每个发现都要能追溯到合同号、发票号、凭证号)和一份 Word 核查报告,报告中还需说明哪些事项因缺少函证、监盘而无法得出结论。

**Work360 的一道题:**投资性房地产专项核查,右上角的 L4 为难度等级;同一领域内还有 L5 的「财务报表全科目审计底稿」。
总分上,Qwen4-Max 为 52.69,上一代为 47.74。拆分到领域看,差距并不均匀:
Work360:两代总分,以及拉开差距最大的领域 Qwen3.8-MaxQwen4-Max 总分47.74**52.69+4.95 两代差距最大的 8 个领域示意图 设计 市场营销 咨询 数据分析 制造业 法律 物流 农业 基本持平,Qwen4-Max 略低 行政科学研究
总分为真实成绩,条长以 52.69 为满格。领域部分的条长仅表示两代差距的相对大小,不对应具体分数。
设计领域拉开差距最大,市场营销、咨询、数据分析、制造业也明显领先;行政和科学研究两项基本持平,Qwen4-Max 略低一点。Work360 是阿里自出的考卷,适合观察两代之间的变化,若要与其他模型比较,仍需参考上一节那 16 项公开测试。
交付的任务:从游戏到产线
三维建模和游戏开发
Qwen4-Max 能直接操作 Blender,将几何建模、场景搭建、材质配置、灯光渲染串联成一条流水线,涵盖建筑、室内到自然风光和科幻场景。生成的模型还可进一步用于游戏开发,或 3D 打印成实物。
在 Blender 中建模、搭建场景、渲染
游戏开发更进一步。给它一段自然语言需求,它在 Unity、Unreal Engine、Godot 等专业引擎中搭建场景、编写玩法逻辑、整合外部资产、配置材质、制作 HUD 和特效。关键在于它会真正运行游戏,查看画面、测试手感,再回头修改:
它制作游戏的方式:写完即运行,看完再修改
01搭建场景、玩法逻辑、资产、材质、HUD、特效 02运行在引擎中实际运行游戏 03查看画面、测试手感镜头跟随、角色动作、碰撞和打击感 04修改细节光影、节奏和各种小问题
↻ 多轮迭代,直到可直接上手游玩
 《喵出法随》的法师塔
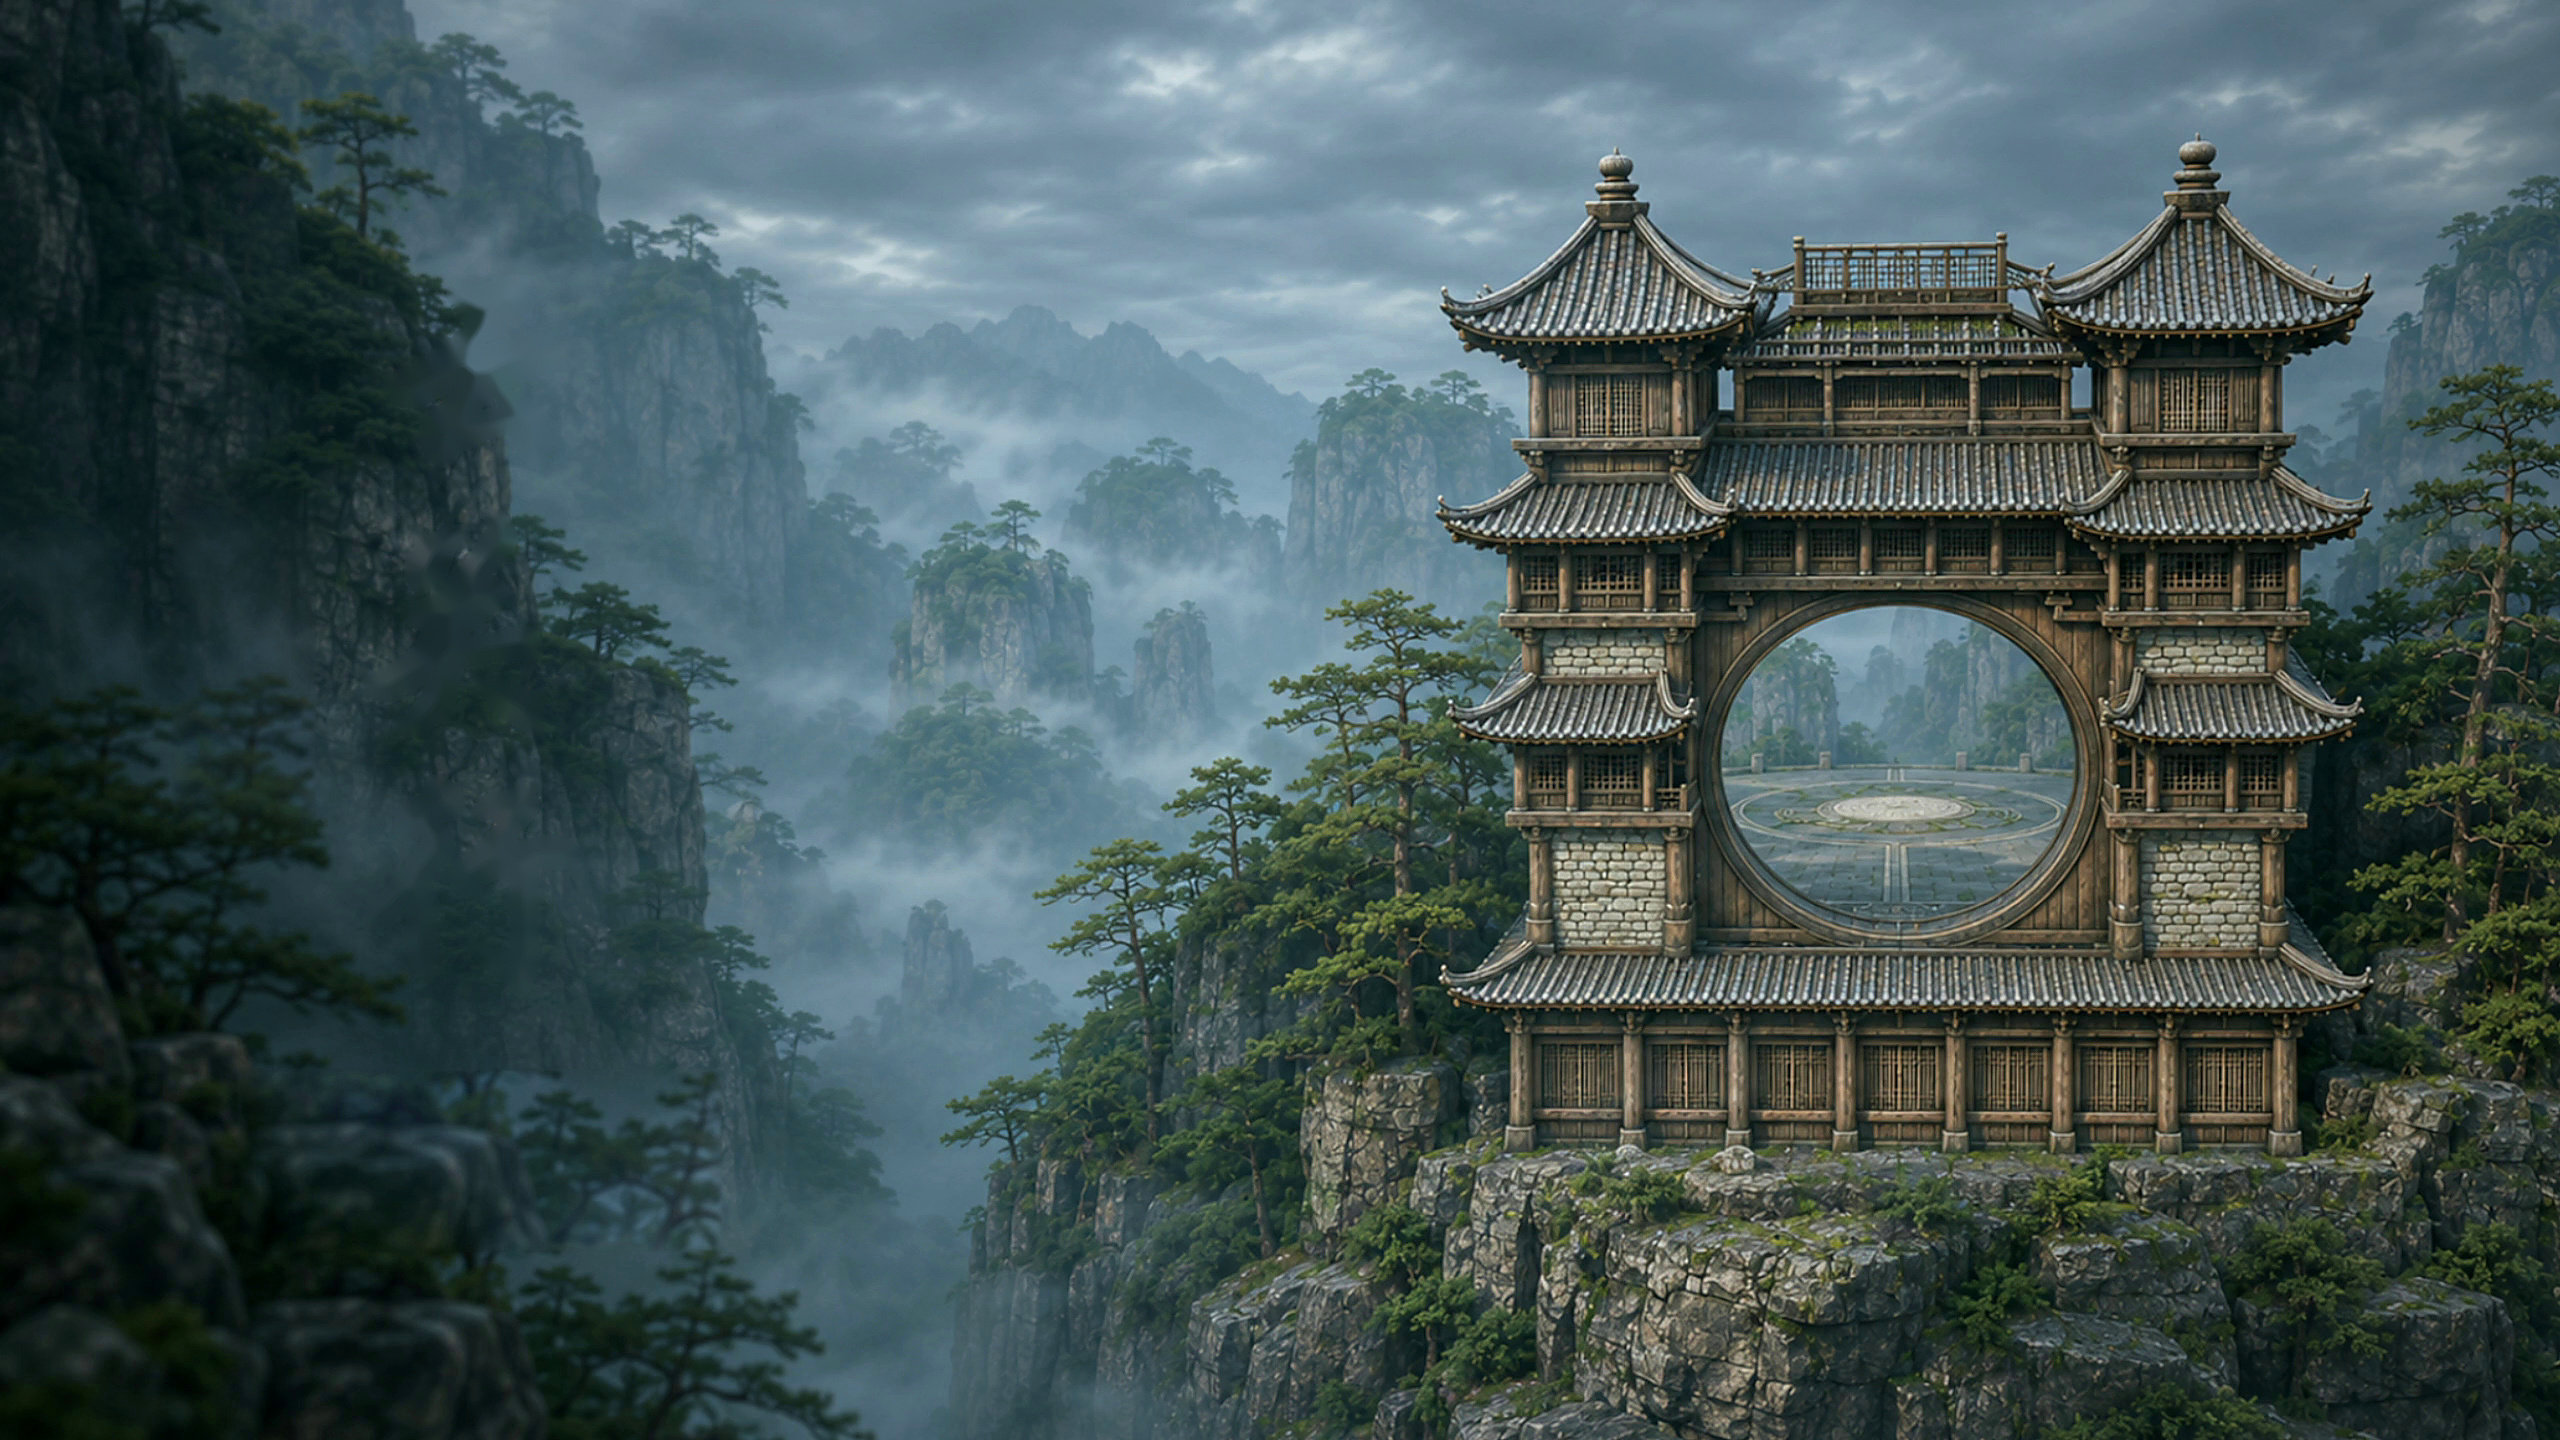
 《云关行》的云海山门
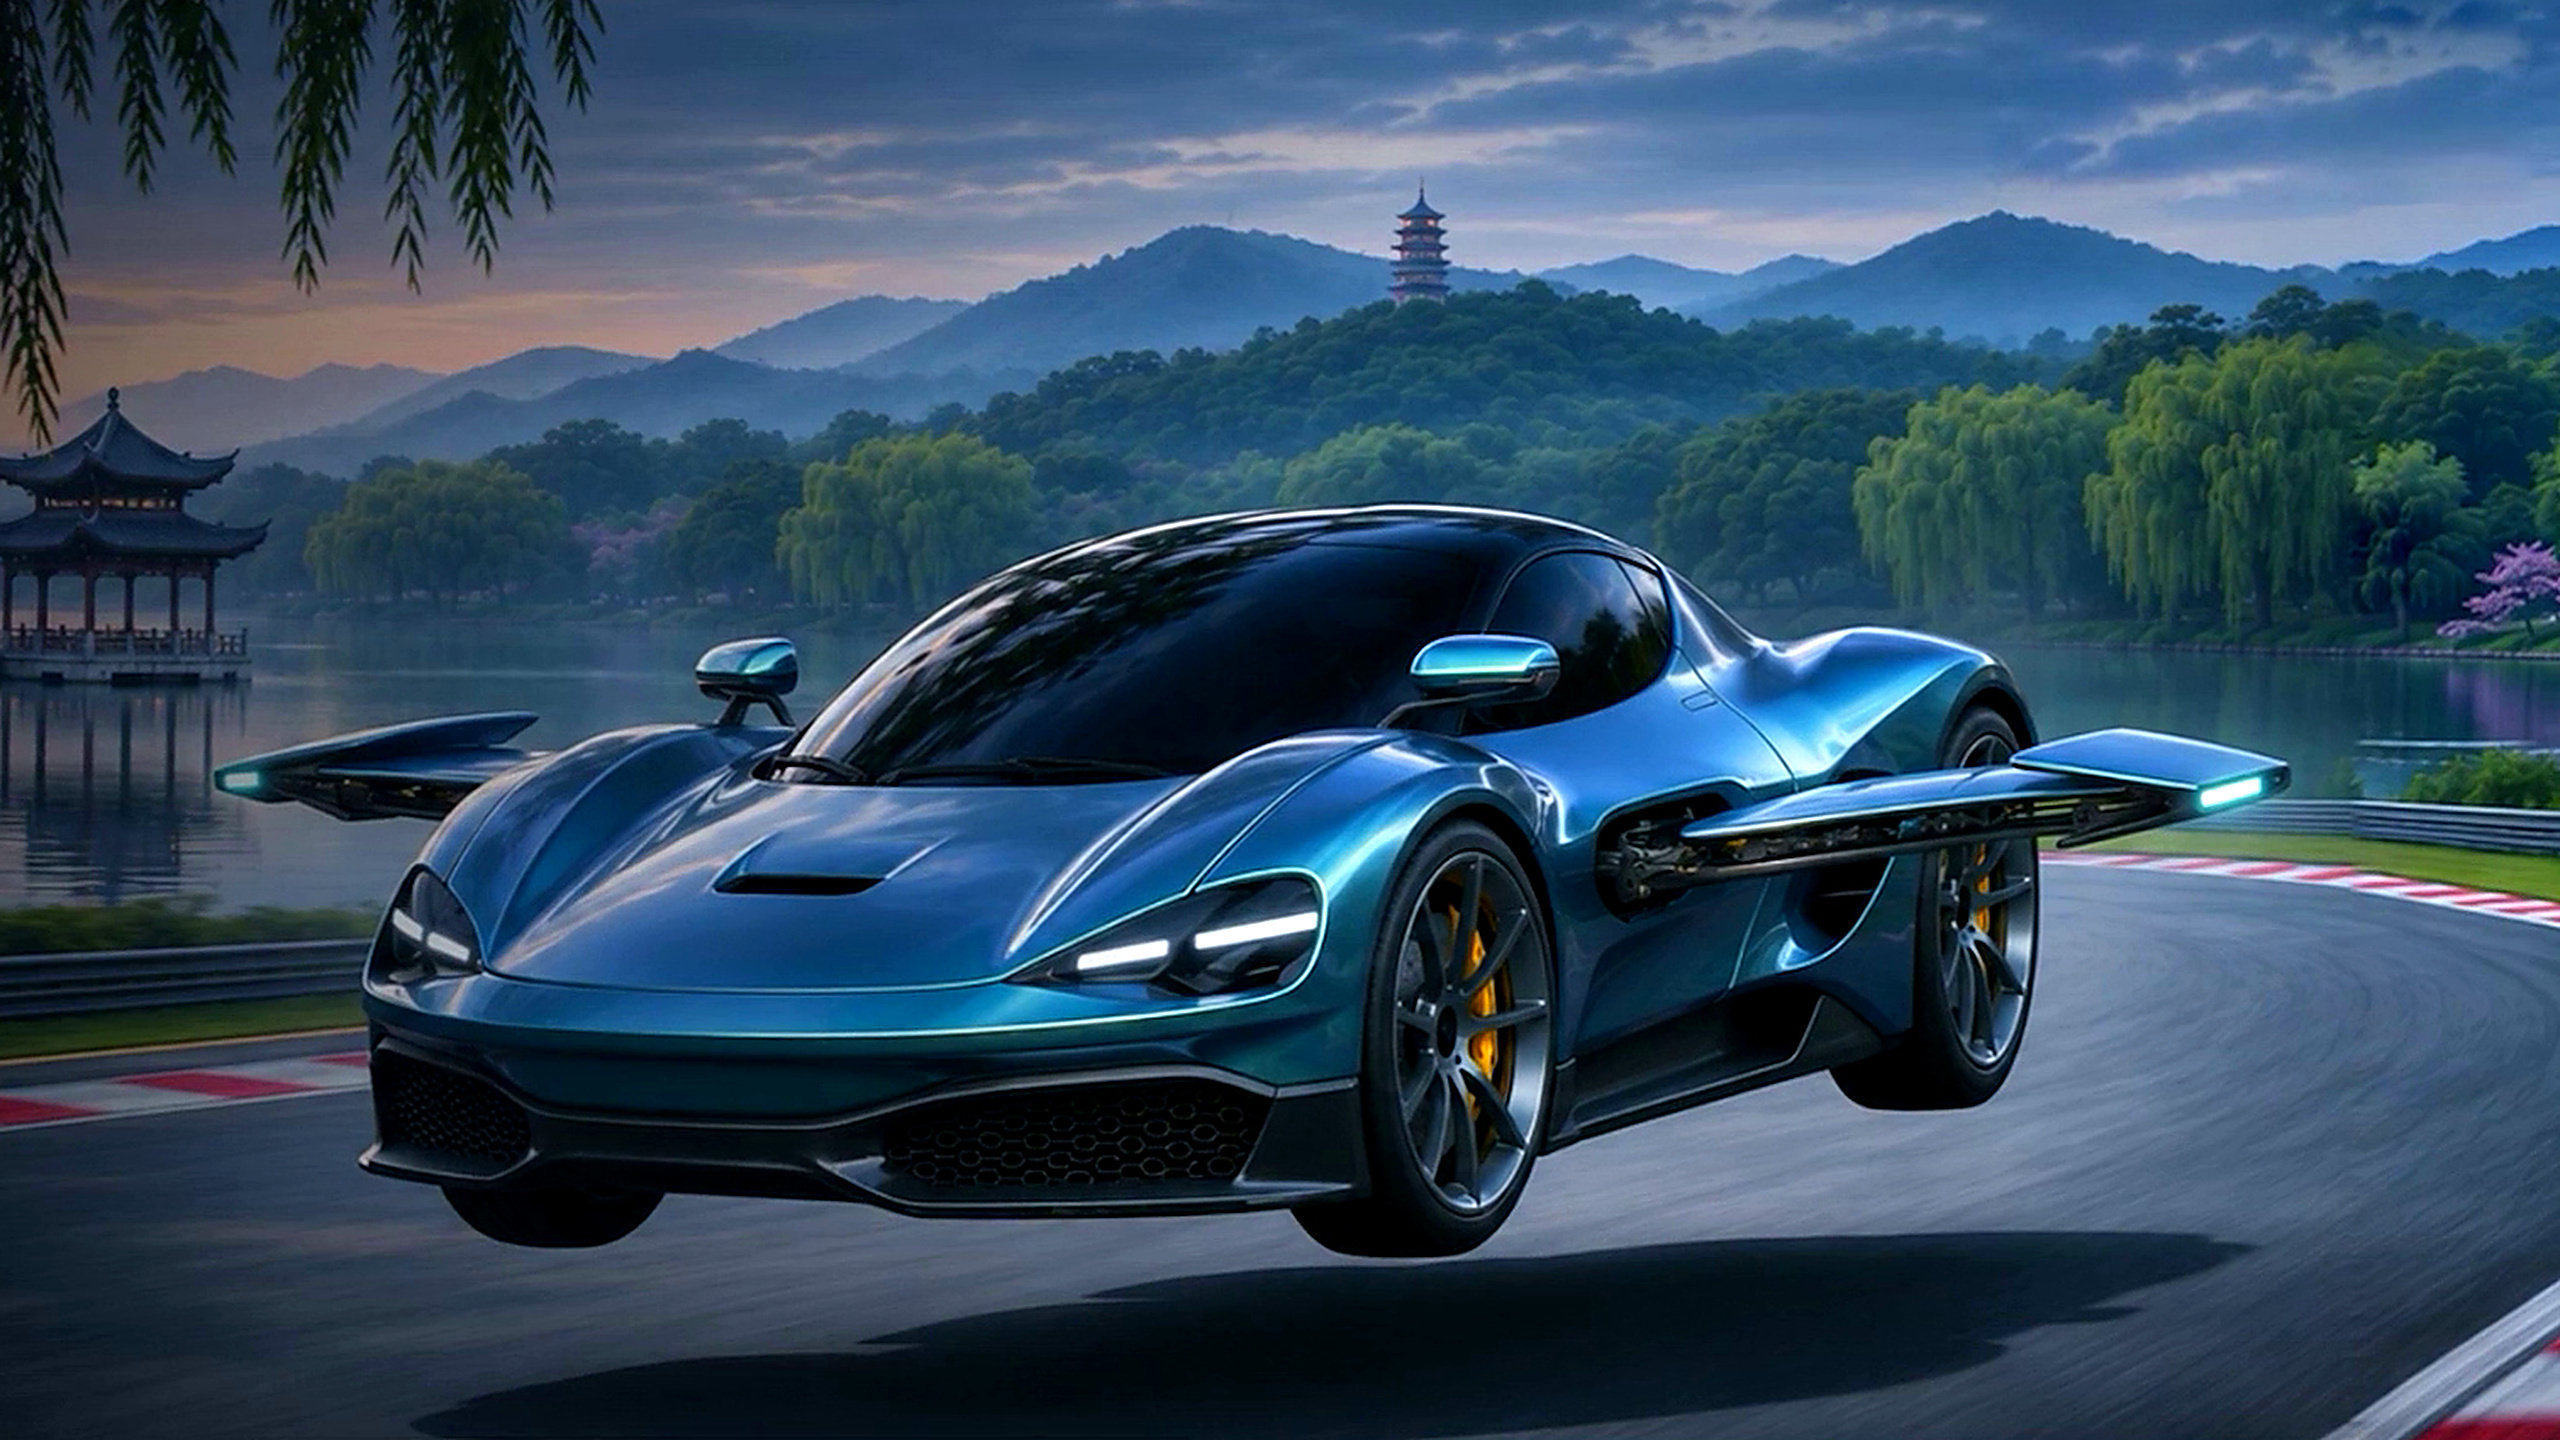
 《飞行赛车》的西湖赛道
三款游戏的画面,都是 Qwen4-Max 在专业引擎里做出来的。
**《喵出法随》,Unreal Engine:**猫咪法师冒险:放多种法术、挑能力强化,一波波打敌人,最后挑战首领。
**《云关行》,Unreal Engine:**云海仙侠冒险:御剑飞行、连续穿环、探索场景、挑战首领。
**《飞行赛车》,Unity 6:**西湖主题的赛车手游,能漂移、氮气加速、展翼飞行,最后交付了可以安装的 Android 版本。
汽车制造:上机前就把错找出来
在三丰智能装备、统联精密的实际生产场景里,Qwen4-Max 干的是工程师的活。产线层面,它根据二维布局图和工艺参数,调用现成的设备库搭出三维产线,再做节拍仿真和 PLC 虚拟调试(在电脑里先把控制程序跑一遍)。零件层面,它给车门总成、摩擦轮这类部件建模,规划加工工艺、生成刀路,再用仿真核对,在上机床之前就发现过切、少切这类问题。
单个工件的加工编程,人要花多少时间
以前人工编程约 475 分钟 现在Qwen4-Max 辅助24 分钟
**约 −95%**一个工件的编程从将近 8 小时的人工,变成不到半小时。
数字来自展示的加工案例。
汽车制造:从产线规划到零件建模、刀路生成和仿真核验
拍片:先搭白模,再让生成模型画
Qwen4 配合视频工具「万镜一刻」,能把一部多场景短片从头做到尾:打磨分镜脚本、准备静态资产、在白模(只有几何形状、没贴材质的粗模型)里预演镜头运动,再逐段渲染、剪成成片。先搭白模的好处是,建筑的比例、物体之间的位置关系、镜头走哪条路、动作卡在哪一拍,都能事先定死,生成出来的画面不容易乱。
用 Qwen4 和万镜一刻做多场景短片的工作流
金融投研:每个数字都能点回出处
投研场景里,Qwen4 能调用 90 个 MCP 工具,取 A 股、港美股、债券、基金和衍生品的行情、财务、利率、分红数据,再用搜索交叉核对公开资料。演示案例是沪深 300 股指衍生品:它综合资金成本、股息率和合约期限算出理论基差,分析实际贴水,再比较隐含波动率和历史波动率。交付的是一份 Excel 底稿和一份可编辑的 PPT:单元格链接能直达原始数据,PPT 里的图表和 Excel 底稿一一对应,研究员随时能从报告查回公式。
金融投研:沪深 300 股指衍生品的基差和波动率分析
IPO 法律尽调:198 份乱稿,一份 86 页报告
律师做 IPO 尽调,第一关往往是整理客户分批发来的材料。这次客户给了 198 份格式混乱、命名不一的底稿,Qwen4-Max 按实质内容把它们重新命名、归进 14 个目录,自动编出底稿清单。
198 份底稿,按内容归进 14 个目录示意图
198 份散乱底稿,格式、命名各不相同14 个目录 + 一份底稿清单
多源核验主动查工商、知识产权、司法、信用等公开信息,和底稿对照 挖风险深挖协议细节,比如识别出「对赌协议恢复条款」,给出整改建议 86 页6 万余字报告,12 个模块、14 项法律问题,结论都附底稿引用
每个目录放多少份是示意,198 和 14 是真实数字。
所有结论都附底稿引用,律师可以逐条回查,把精力留给真正需要判断的风险点。
企业 IPO 法律尽调:整理底稿、交叉核验、写出完整报告
危重症医疗:一次读完整份病历
重症病人的病历又多又杂:几十份检验单、上万字的病程记录、多份医嘱,外加 1,433 张原始影像。演示里的病人做完颈动脉支架手术后发生室颤并复苏,拔管后胸痛,第六天又重新插管。Qwen4 在一次对话里读完整份病历,做了四件事:
- **查指标:**跨日期找到指定那一次的 CRP 结果。
- **理病程:**把六天里的复杂事件排成一条清楚的时间线。
- **读影像:**把影像分成六类序列,找到目标胸部 CT,多窗口并行读了几百张原始图像,认出「双肺背侧实变」,和主管医生的诊断一致。
- **做决策:**综合这些信息给出四条处置建议,和医生当天的医嘱逐条对得上。
它的角色是辅助:在可能造成严重后果的决定上,最后拍板的仍然得是医生。
危重症临床:查指标、理病程、读影像、做决策
全天候 Agent:边做边交,还优化了自己的机房
Live Delivery:先交一版能用的,再一版版改
让 Agent 连干几天的长任务,常见的毛病是它闷头做事:你看不到进展,它跑偏了也要等到最后才知道。Qwen4-Max 加了 Live Delivery(持续交付)能力:先交一个能用的首版,再一版接一版扩充内容、提升质量。你看每一版决定方向,它根据你的反馈调整后面的计划。
同一个长任务,两种交法示意图
闷头干到底中途看不到东西
……进展不可见……交付
跑偏了,要到最后一刻才发现。
Live Delivery边做边交
首版↑ 你的反馈 v2↑ 反馈 v3↑ 反馈 v4
每一版都能用,方向随时能校准。
Qwen 同时开源了 Qwen-Live-Delivery-Plugin,装上插件就能用这种交付方式。
**Live Delivery:**演示任务是做一个知识网站,它一共交了 14 版,最后做到 100 个页面,每版都附进度播报和检查记录。
云资源调度:它优化的是自己跑在上面的系统
一句话:Qwen4-Max 被拿去优化跑它自己的机房,也就是它调用、推理和训练所用的阿里云资源调度;省下的钱和算力,回到下一代模型身上。做法是它自己写调度算法,交给阿里自研的求解器 MindOpt 打分,再改代码重试。
自己写算法、求解器打分、改了再试
01写候选算法按任务设定生成调度方案的代码 02MindOpt 评估可行性、目标值、耗时 03改代码、交叉验证拿到反馈后迭代出更优策略
**−10.42%**数据标注场景,多模型调用的平均费用(对比参考基线) **+4.62%**GPU 在线分配,整机空闲容量时长(对比基线) 14.61 倍以上CPU 离线重调度,求解到最优目标的速度
三个场景都在阿里云的真实业务里落地。
做科研:从屏幕上的分子到实验室里的样品
冷却液:48 小时,设计到合成一条龙
下一代高功率芯片越来越热,数据中心的散热是个现实难题。Qwen4 借助深度原理 Mira 提供的一体化干湿实验环境(「干」是计算机上的模拟计算,「湿」是实验室里真动手),自主跑了 48 小时:从调研路线开始,搭出一个 270 万个分子的候选库,一路筛选、预测、计算,再指挥自动化湿实验室配料、合成、分离纯化、测试。每做完一轮,用实验结果修正下一轮的设计,一共四轮。
48 小时,从 270 万个候选到一份实物样品示意图 干实验:计算机上算湿实验:实验室里做
路线调研,构建候选空间:270 万个分子 结构筛选 MPA 性质预测 第一性原理计算 逆合成设计、实验规划 自动化湿实验室:配制、合成、分离纯化、测试 ↻ 主动学习,用结果修正下一轮设计 · 共 4 轮 实物样品:经过实验验证的新冷却液分子
每一步的宽度只表示越筛越少,中间各步留下多少个分子没有公布。
冷却液干湿实验闭环:分子设计、合成测试、主动学习,循环四轮
药物发现:为阿尔茨海默病寻找候选分子
在阿尔茨海默病中,神经炎症是一个关键环节,NLRP3 炎症小体是研究人员重点关注的靶点。Qwen4-Max 在深势科技的 PharmMaster 平台上,以专利中的分子为起点:自主检索文献和专利、选择参考分子、建立评估基线,随后进行多轮结构设计、性质预测和分子对接,最终通过相对结合自由能(RBFE)计算筛选出最优候选分子。
一次自主分子优化的工作量和结果
454 次工具调用 3,239 项计算指标评估 24 个设计优化的候选分子 约 3.6 倍与靶点的结合亲和力更高:计算结果显示约为起始分子的 3.6 倍
最终分子与专利起始分子相比,九项计算指标中有七项更优、两项变差
✓ 溶解度 logS – 心脏毒性风险 hERG ✓ 透过血脑屏障 BBB – 被外排转运 P-gp ✓ CYP3A4 代谢 CYP3A4 ✓ UGT 代谢 UGT ✓ 致突变风险 AMES ✓ 清除率 Clearance ✓ 对接打分 Vina
✓ 表示比起始分子有所改善;– 表示略有变差。3.6 倍是基于自由能计算得出的数值,并非实测药效。
深势科技的专家认为该分子具有较高的研究价值,值得进一步进行湿实验验证。也就是说,它目前仍停留在计算阶段,下一步将进入实验室环节。
与 Qoder 共同调试的成果
在 Qwen4-Max 的研发过程中,团队与 Qoder 等产品团队共同设计了模型、Agent 运行框架及产品:从日常办公、专业设计中的真实需求出发,确定模型需要解决的问题,并以端到端任务的交付质量作为检验标准。以下三个网页作品均是在 Qoder 中使用 Qwen4-Max 制作的。
模型、框架、产品协同设计:在 Qoder 中使用 Qwen4-Max 工作
 设计师作品集网站:满屏作品海报铺成透视墙
 Qoder 品牌页:大字号排版、滚动进入
 《雪线速降》:网页中的 3D 滑雪小游戏
三个作品打开时的首屏。原页面均为可滚动、可交互的网页。
安全:编写代码时减少漏洞
在训练代码编写能力时,除了检查功能正确性外,这一代还增加了代码安全检测。在 Last Secure Code Bench 上,不提供任何安全提示,让模型重写代码,并同时检查功能和漏洞:
写出既可用又无漏洞的代码比例提升情况 Qwen3.8-MaxQwen4-Max 函数级功能和安全双通过*22.0%*31.8% 函数、文件、仓库三个粒度同时安全*8%*14.7%,接近翻倍
条长以 31.8% 为满格。在注入、内存安全、越权访问这几类风险上改善最为明显。
在网络安全方面,训练数据按用途进行了筛选:保留用于漏洞验证、检测和修复等防御目的的数据,去除用于提升攻击能力的数据。内部安全专家审查了长程任务的完整运行轨迹(包括思维链),结论是防御能力大幅提升,对攻击性用途的防护也更强,未发现其具备造成大规模网络安全风险的能力。在 CBRN(化学、生物、放射、核)方面,内部评测中它在不过度拒答的前提下识别出了更多有风险的请求;专家审查认为,其给出的方案缺乏真正的创新性,也无法端到端完成任务。
现在可以使用什么
Qwen4-Max 已上线千问 AI 平台,开发者可以按量调用 API,也可以购买 Token Plan 订阅;API 兼容 OpenAI 和 Anthropic 两种接口格式。不写代码的情况下,在千问办公、Qoder CN、千问 App 和 Qwen Studio 中均可直接使用。
| 千问 AI 平台 | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| 输入(每百万 token) | 12 元 | 10 元 |
| 输出(每百万 token) | 36 元 | 30 元 |
| 输入缓存命中(每百万 token) | 1.5 元 | 0.5 元 |
| 上下文 | 1M | 1M |
| 最大输出 | 131K | 393K |
关于开源需要单独说明。上一代 Qwen3.8-Max 发布时宣布开源权重,是首个 Max 规模的开源权重模型;这一次,Qwen4-Max 未提及开源权重,仅表示 Max 是 Qwen4 系列的首款产品,系列中的小尺寸模型将陆续开源,遵循相同的技术路线,并使用同一代的训练和对齐积累。若想自行部署 Max 级别的模型,这一代暂时没有答案;此次确定开源的是 Live Delivery 插件。 站内 · 上一代阿里巴巴发布并开源 Qwen3.8-Max 模型:家族最强模型首次开源,2.4 万亿参数,能自己连续自主运行 16 天想了解上一代开源的那个 Max 能做什么、怎么接进 Claude Code,看这篇。
回到开头那句「新同事」。从这次的材料来看,Qwen4-Max 最像同事的地方不在于跑分,而在于工作方式:会自己跑一遍游戏再修改,会将 198 份乱稿先理清再写报告,会边做边交一版给你看。价格降低以后,让它这样一轮轮干长活,账也更算得过来了。 来源Qwen4-Max:新同事,已就位(Qwen4-Max: Your New Teammate Has Arrived)Qwen Team·2026-11-16·查看主材料延伸千问 AI 平台 · Qwen4-Max 模型页(价格与上下文)·千问 AI 平台 · Qwen3.8-Max 模型页(上一代价格)·Qwen3.8-Max:编程与办公,全面跃升(上一代参数与开源说明)·Qwen-Live-Delivery-Plugin本站说明Work360 各领域分数取自发布页「模型对比」交互嵌入的脚本数据;图片、视频和交互截图均来自 Qwen 发布页。
原文版权归原作者,这里只供对照阅读。 看原网页 ↗
Qwen4-Max: Your New Teammate Has Arrived
Today, we are introducing Qwen4-Max, your new AI teammate for work, creativity, and discovery. Qwen4-Max is built on the new Qwen4 architecture, with a 2.4-trillion-parameter backbone, native vision capabilities, and a one-million-token context window.
Qwen4-Max advances real-world productivity through greater proficiency with professional tools, stronger long-horizon task execution, and higher-quality deliverables. It can take on a wide range of creative and professional work, spanning 3D modeling, game development, precision manufacturing, finance, law, healthcare, and frontier scientific discovery. As a 24/7 AI teammate, Qwen4-Max keeps the big picture in view and moves projects forward, bringing ambitious ideas closer to reality and opening new ways for people and AI to work together.
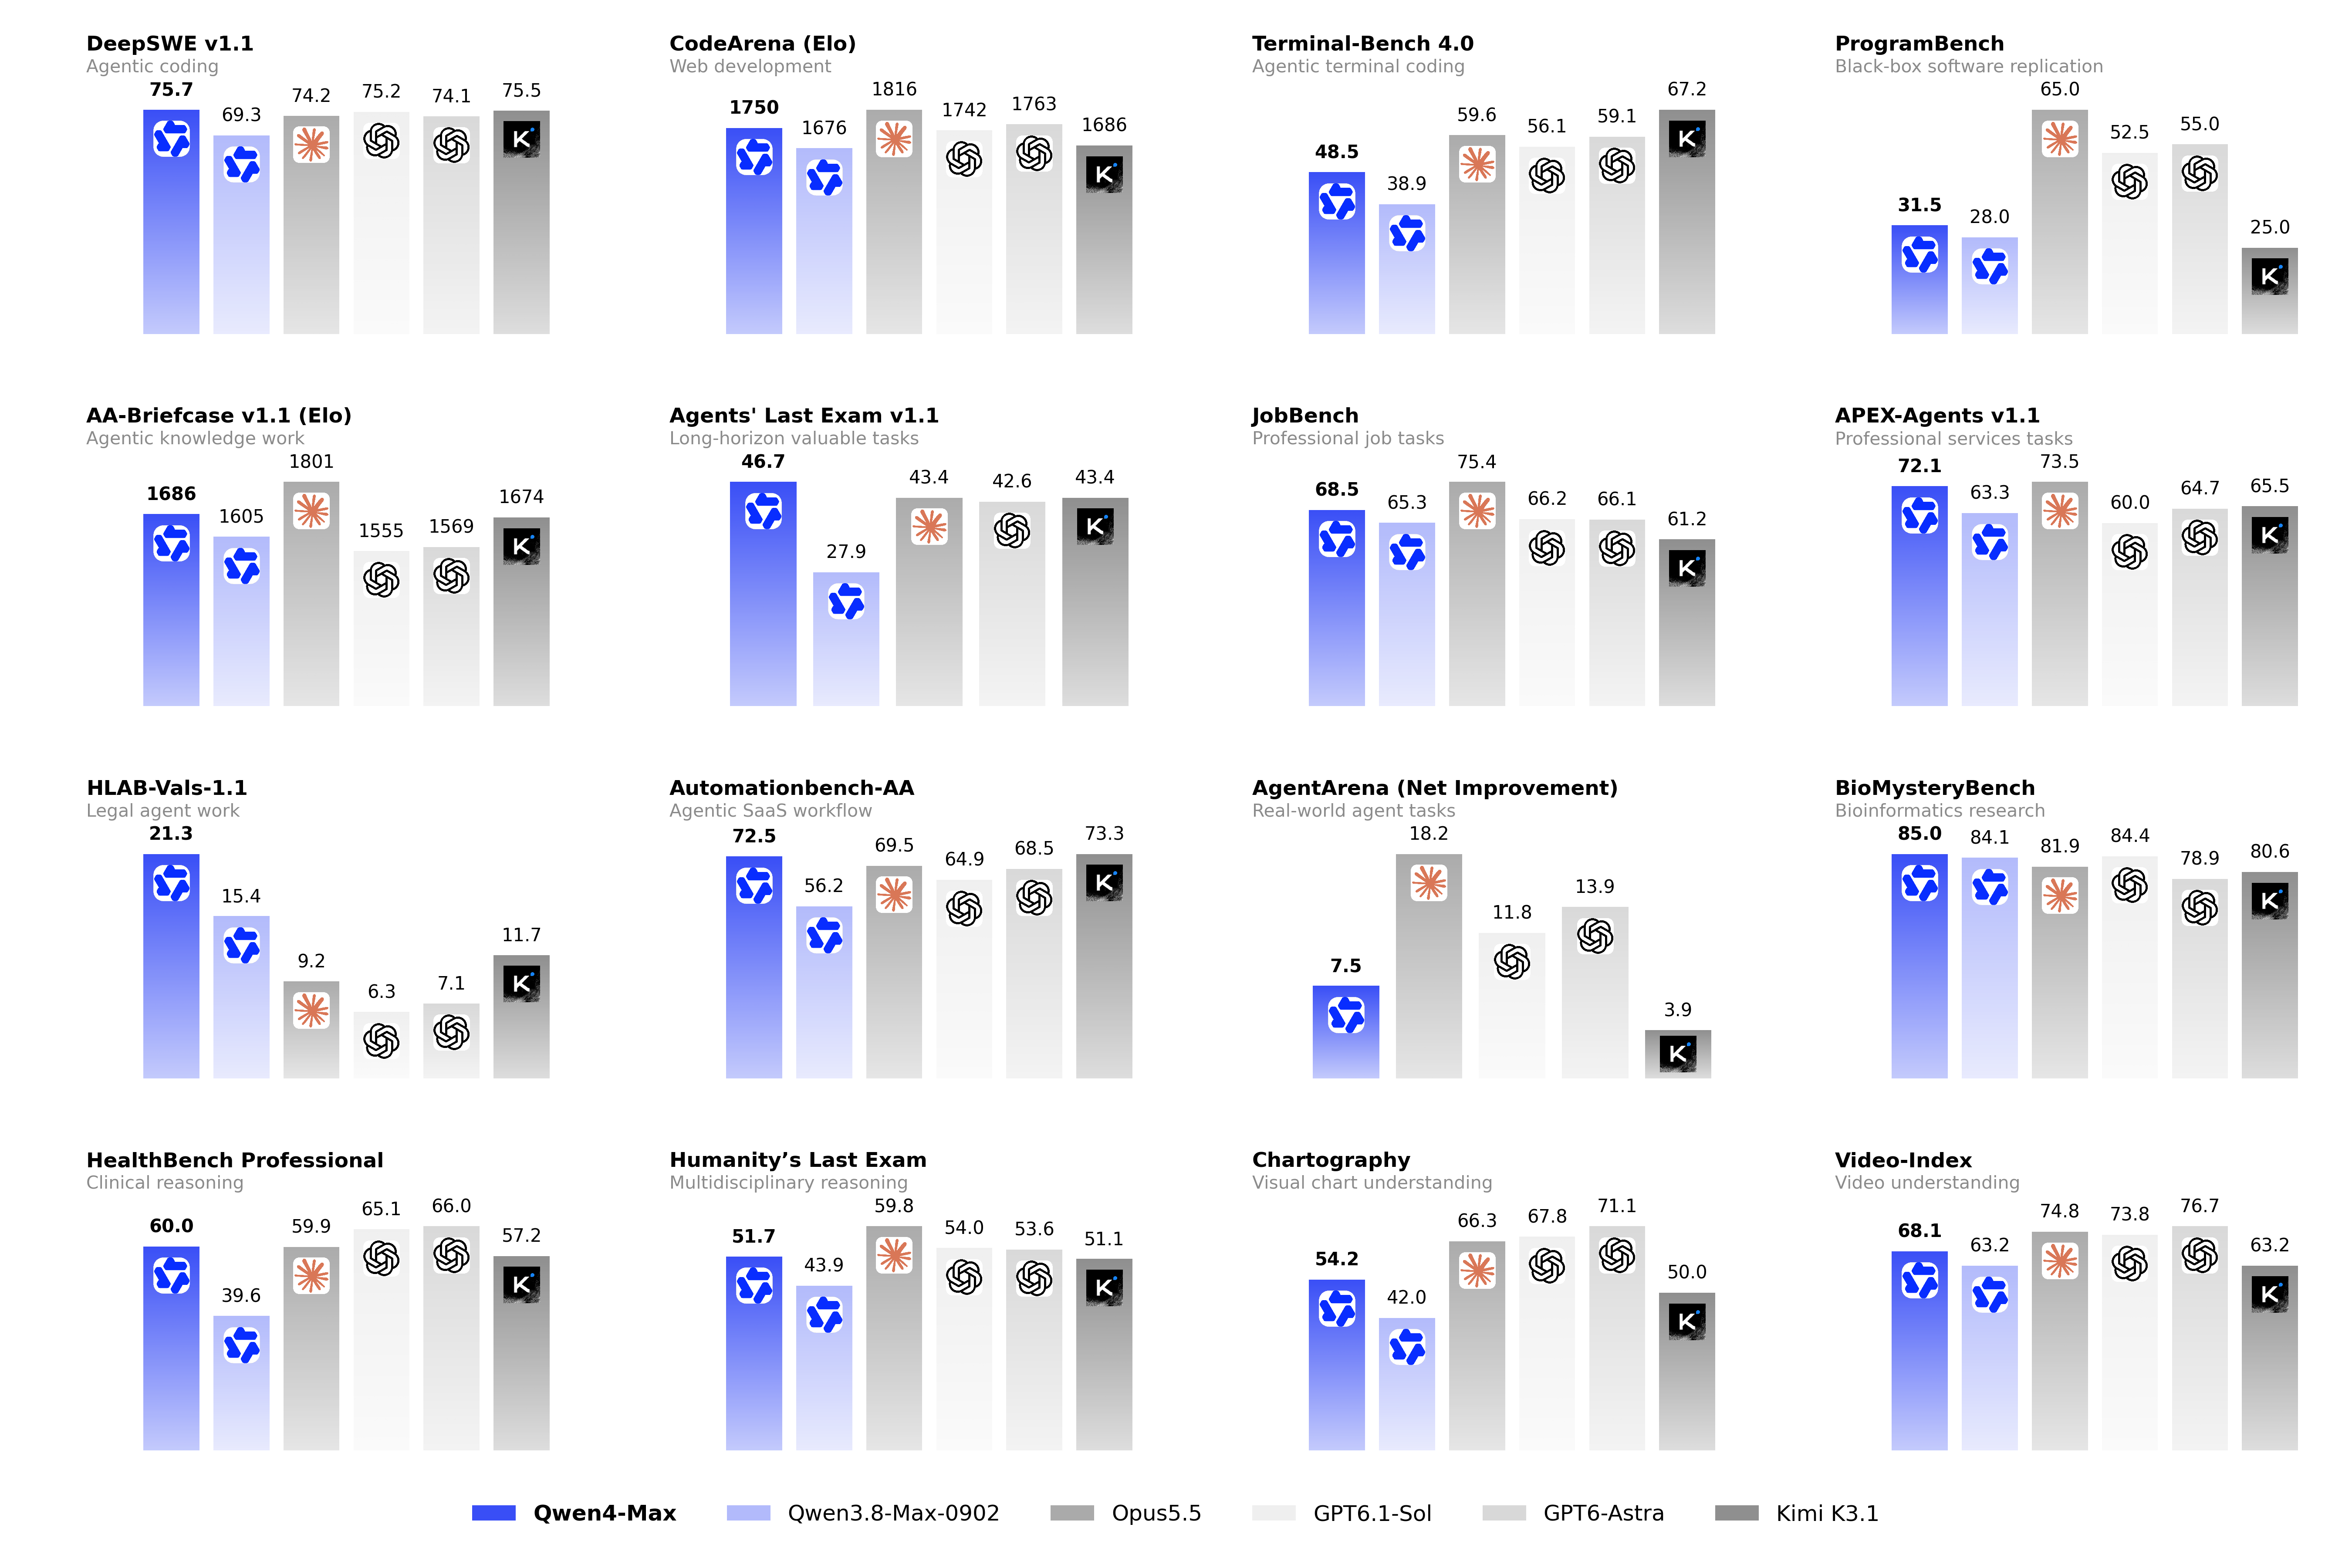
在编码、工作和长周期任务中的综合性能对比。Qwen4-Max 相比 Qwen3.8-Max 实现了显著跃升,在我们评估的几乎所有能力上都表现出更强的性能。评估详情见脚注。
Token 效率与成本。 Qwen4-Max 在消耗更少 Token 的情况下优于 Qwen3.8-Max:在 Work360 上,Xhigh 和 High 努力程度下的 Token 使用量分别下降了约 24% 和 35%;在 Terminal-Bench 4.0 上,降幅分别约为 48% 和 49%。与 Qwen3.8-Max 相比,我们还降低了 API 价格,其中缓存输入价格的降幅尤为显著。在我们的 Work360 评估中,每个任务的平均成本从 $4.43 降至 $1.67,降幅达 62%。
预训练
Qwen4-Max 基于 Qwen4 系列的全新架构构建,拥有 2.4T 骨干参数,每个 Token 激活 71B,并额外拥有 328B 的 N-gram Embedding 参数。该架构在 注意力机制、残差连接和嵌入层 方面对稀疏 MoE 模型进行了系统性升级,提升了计算效率、模型容量和训练稳定性:
- GDN + Qwen 稀疏注意力 (QSA): 三个 Gated DeltaNet 层将历史压缩为每个 QSA 层的固定大小状态。QSA 使用轻量级索引器以微块粒度选择相关上下文,降低了长序列的注意力和索引成本。
- 门控残差 (GR): 四个并行残差分支使用动态读写门来加强层间信息流动并提高训练稳定性。
- N-gram Embedding: 基于上下文的查找在第二层提供局部 Token 模式的表示,以极少的额外计算扩展模型容量。
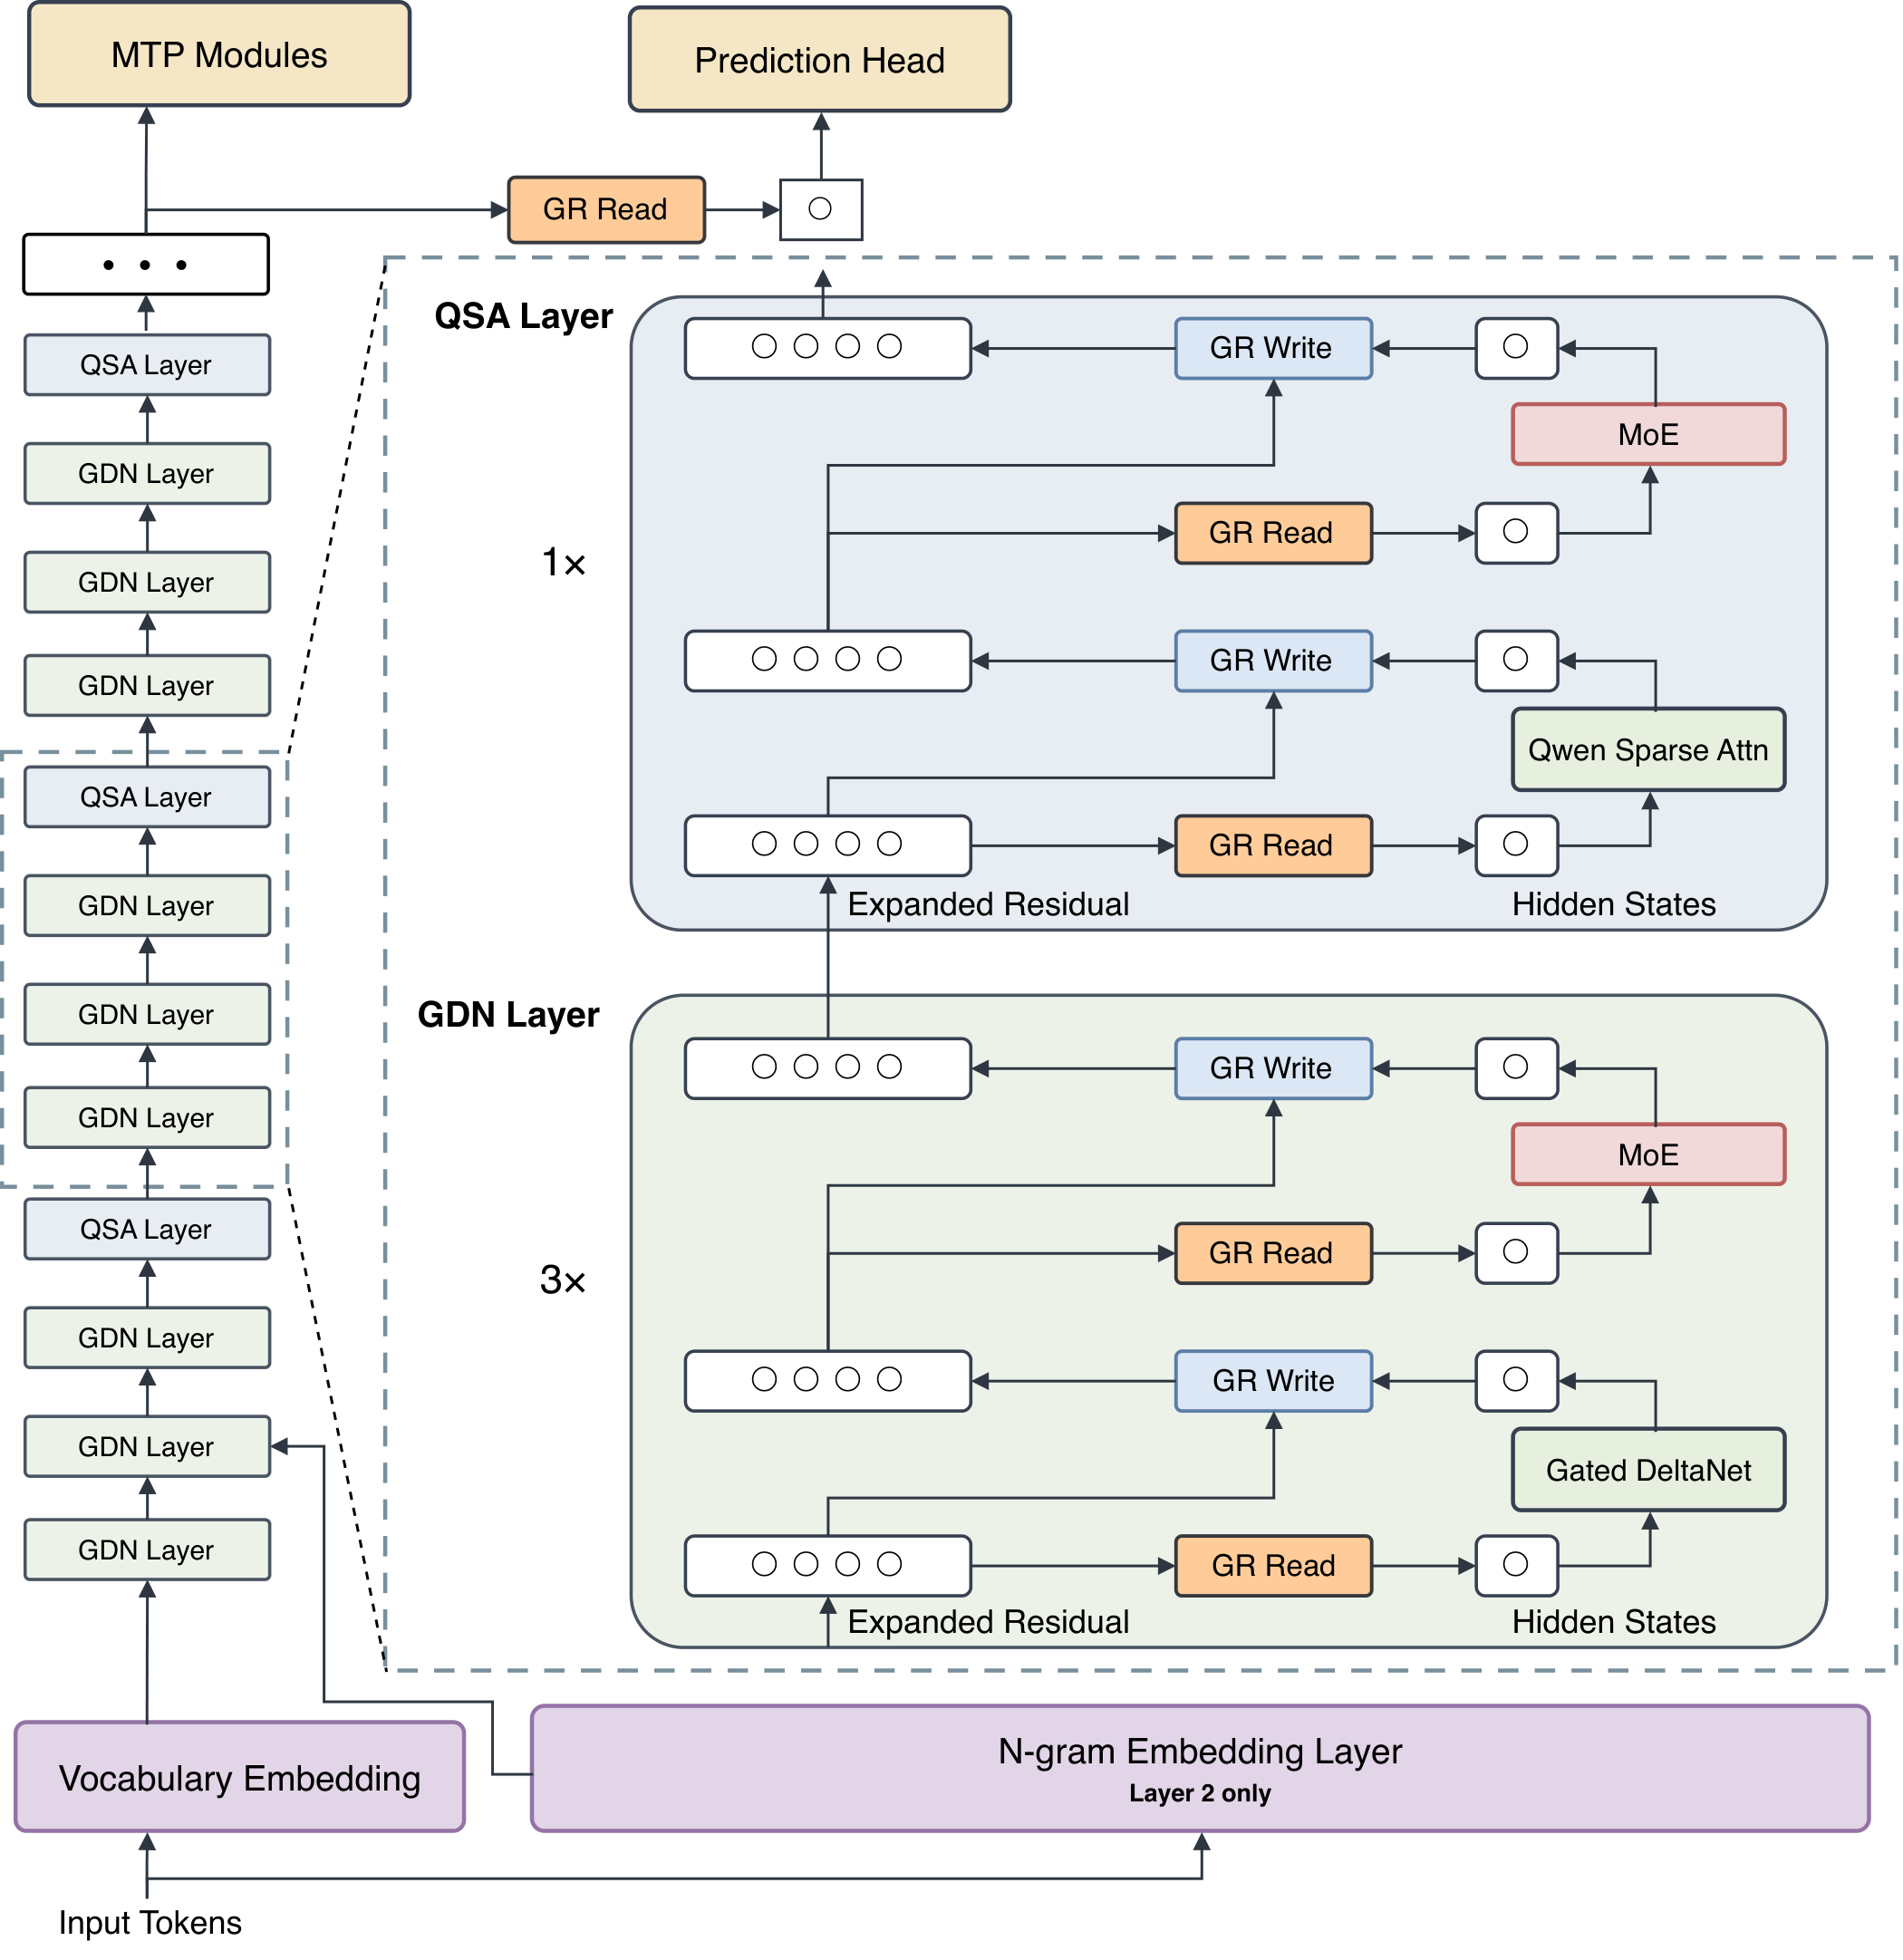
Qwen4-Max 架构。
2.4T 参数规模的训练进展顺利,损失稳步下降,整个运行过程中未出现损失尖峰。我们将这种稳定性主要归因于模型架构和训练优化的改进。
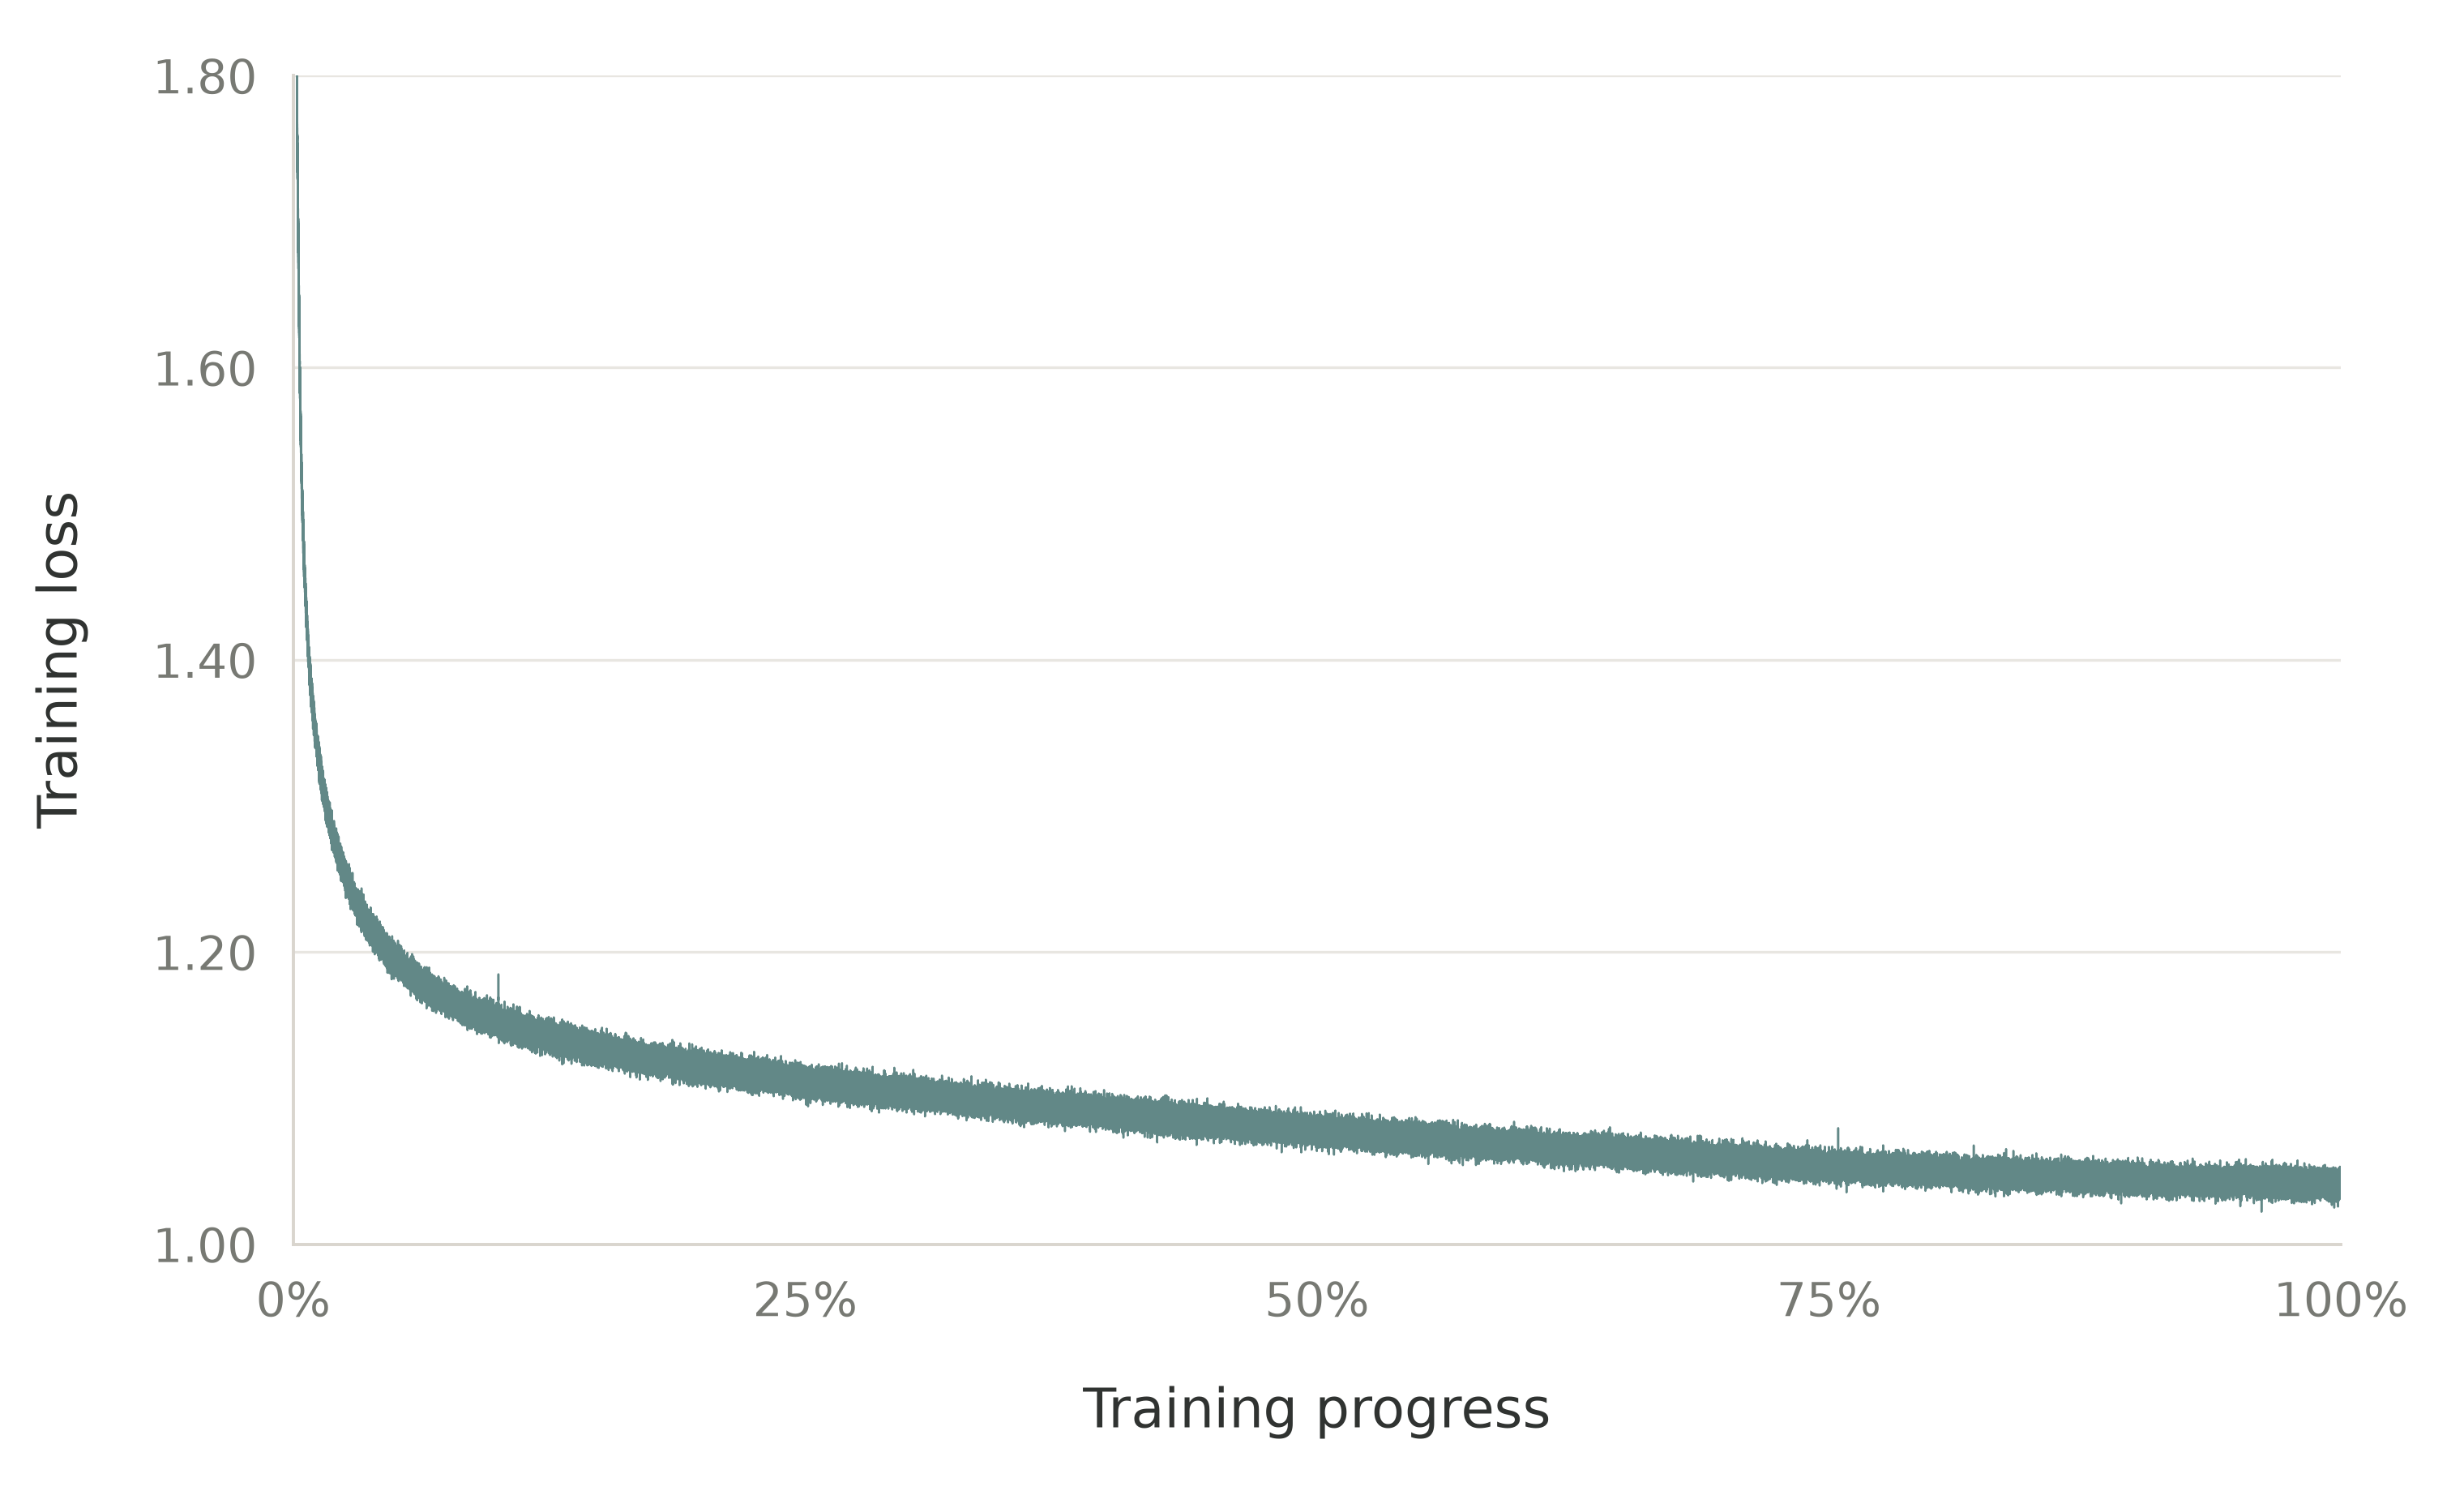
Qwen4-Max 平滑稳定的预训练过程。
在 知识、代码、问答和 STEM 的内部评估中,Qwen4-Max-Base 在所有五个评估的检查点中实现了 最低的字节比特数 (BPB)。它在每个领域都优于 Qwen3.8-Max-Base,BPB 降低了约 5–13%,同时激活的参数减少了 25%。
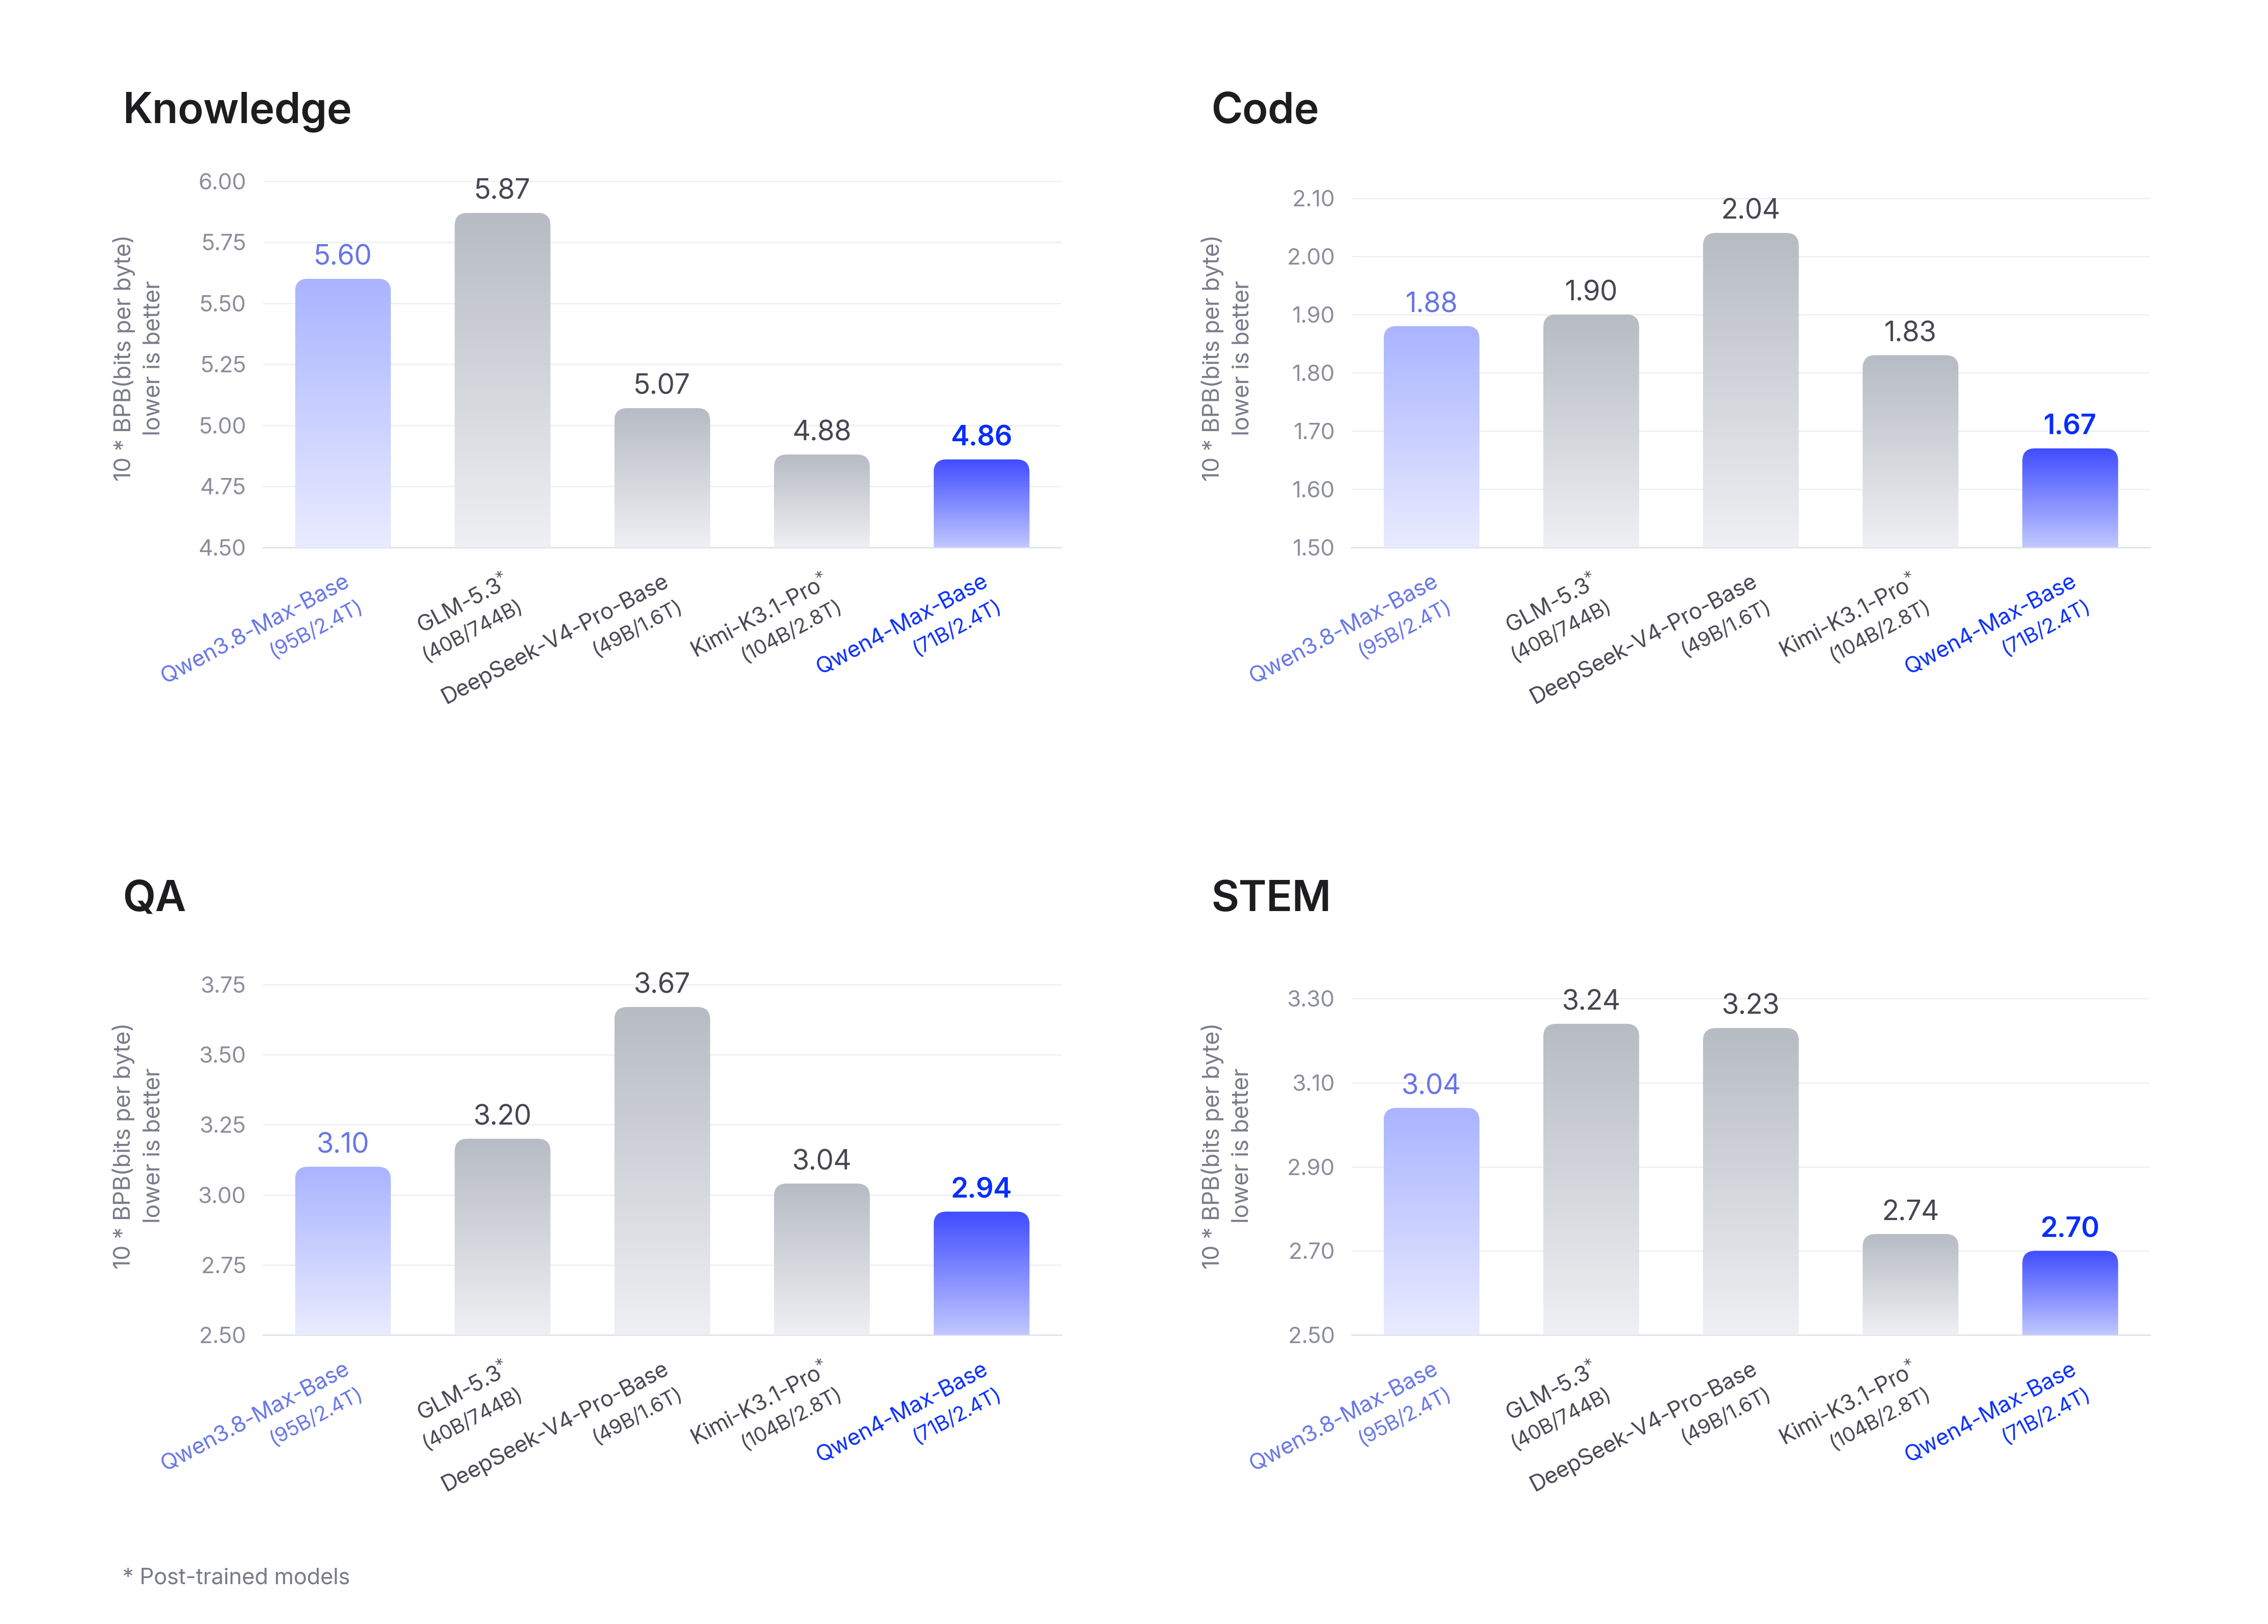
内部评估:10 × BPB,越低越好。GLM-5.3 和 Kimi-K3.1-Pro 是后训练检查点,这可能会影响与基础模型的比较。
现实世界生产力
Qwen4-Max 为跨行业的复杂工作流带来了更强的创意和专业能力,提供高质量、可用的结果——成为您现实世界生产力中的新 AI 队友。
工业与专业工作
为了加强模型在工业和专业工作流中的协作能力,我们开发了 Work360,这是一个用于建模和分类复杂工作场景的综合框架。其分层分类法涵盖 26 个一级领域、182 个二级子领域和 721 个三级专业领域,在行业和职业之间提供了广泛的覆盖范围和细粒度的区分。基于此分类法,我们开发了 Work360 基准测试,以评估具有挑战性的行业任务表现。在最新评估中,Qwen4-Max 得分为 52.69,高于 Qwen3.8-Max 的 47.74,标志着相比上一代有了实质性提升。Qwen4-Max 结合了更广泛的行业覆盖范围和更强的专业任务执行与协作能力,使其成为更具能力和多功能性的现实生产力工具。
全面覆盖
模型对比
任务示例
3D 建模与生成
Blender:3D 建模与场景创建
Qwen4-Max 展现出强大的 3D 创作能力。它利用 Blender 进行几何建模、场景组装、材质设置、灯光布设和渲染,逐步将创意构想转化为具有独特视觉风格的精细 3D 作品。在建筑、室内、自然景观和科幻场景等方面,它展现了对空间布局、物体结构和视觉外观的综合理解。
这些 3D 资产已在游戏中得到实际应用,并通过 3D 打印转化为实体物品。这体现了该模型在连接数字创作与下游生产工作流方面的潜力,支持设计探索、内容创作和原型制作。
GameDev:使用真实引擎创建游戏
Qwen4-Max 能够流畅地对接主流游戏引擎,包括 Unity、Unreal Engine 和 Godot。从单一的自然语言需求简报出发,它负责场景构建、游戏玩法逻辑、合适外部资产的整合、材质设置、HUD 设计以及视觉效果制作,最终交付可玩的游戏。在开发过程中,它运行游戏并利用视觉和交互反馈来优化摄像机追踪、角色动画、打击反馈、灯光和节奏。通过反复测试和迭代,它将场景、玩法和音效融合为连贯的 3D 游戏体验。
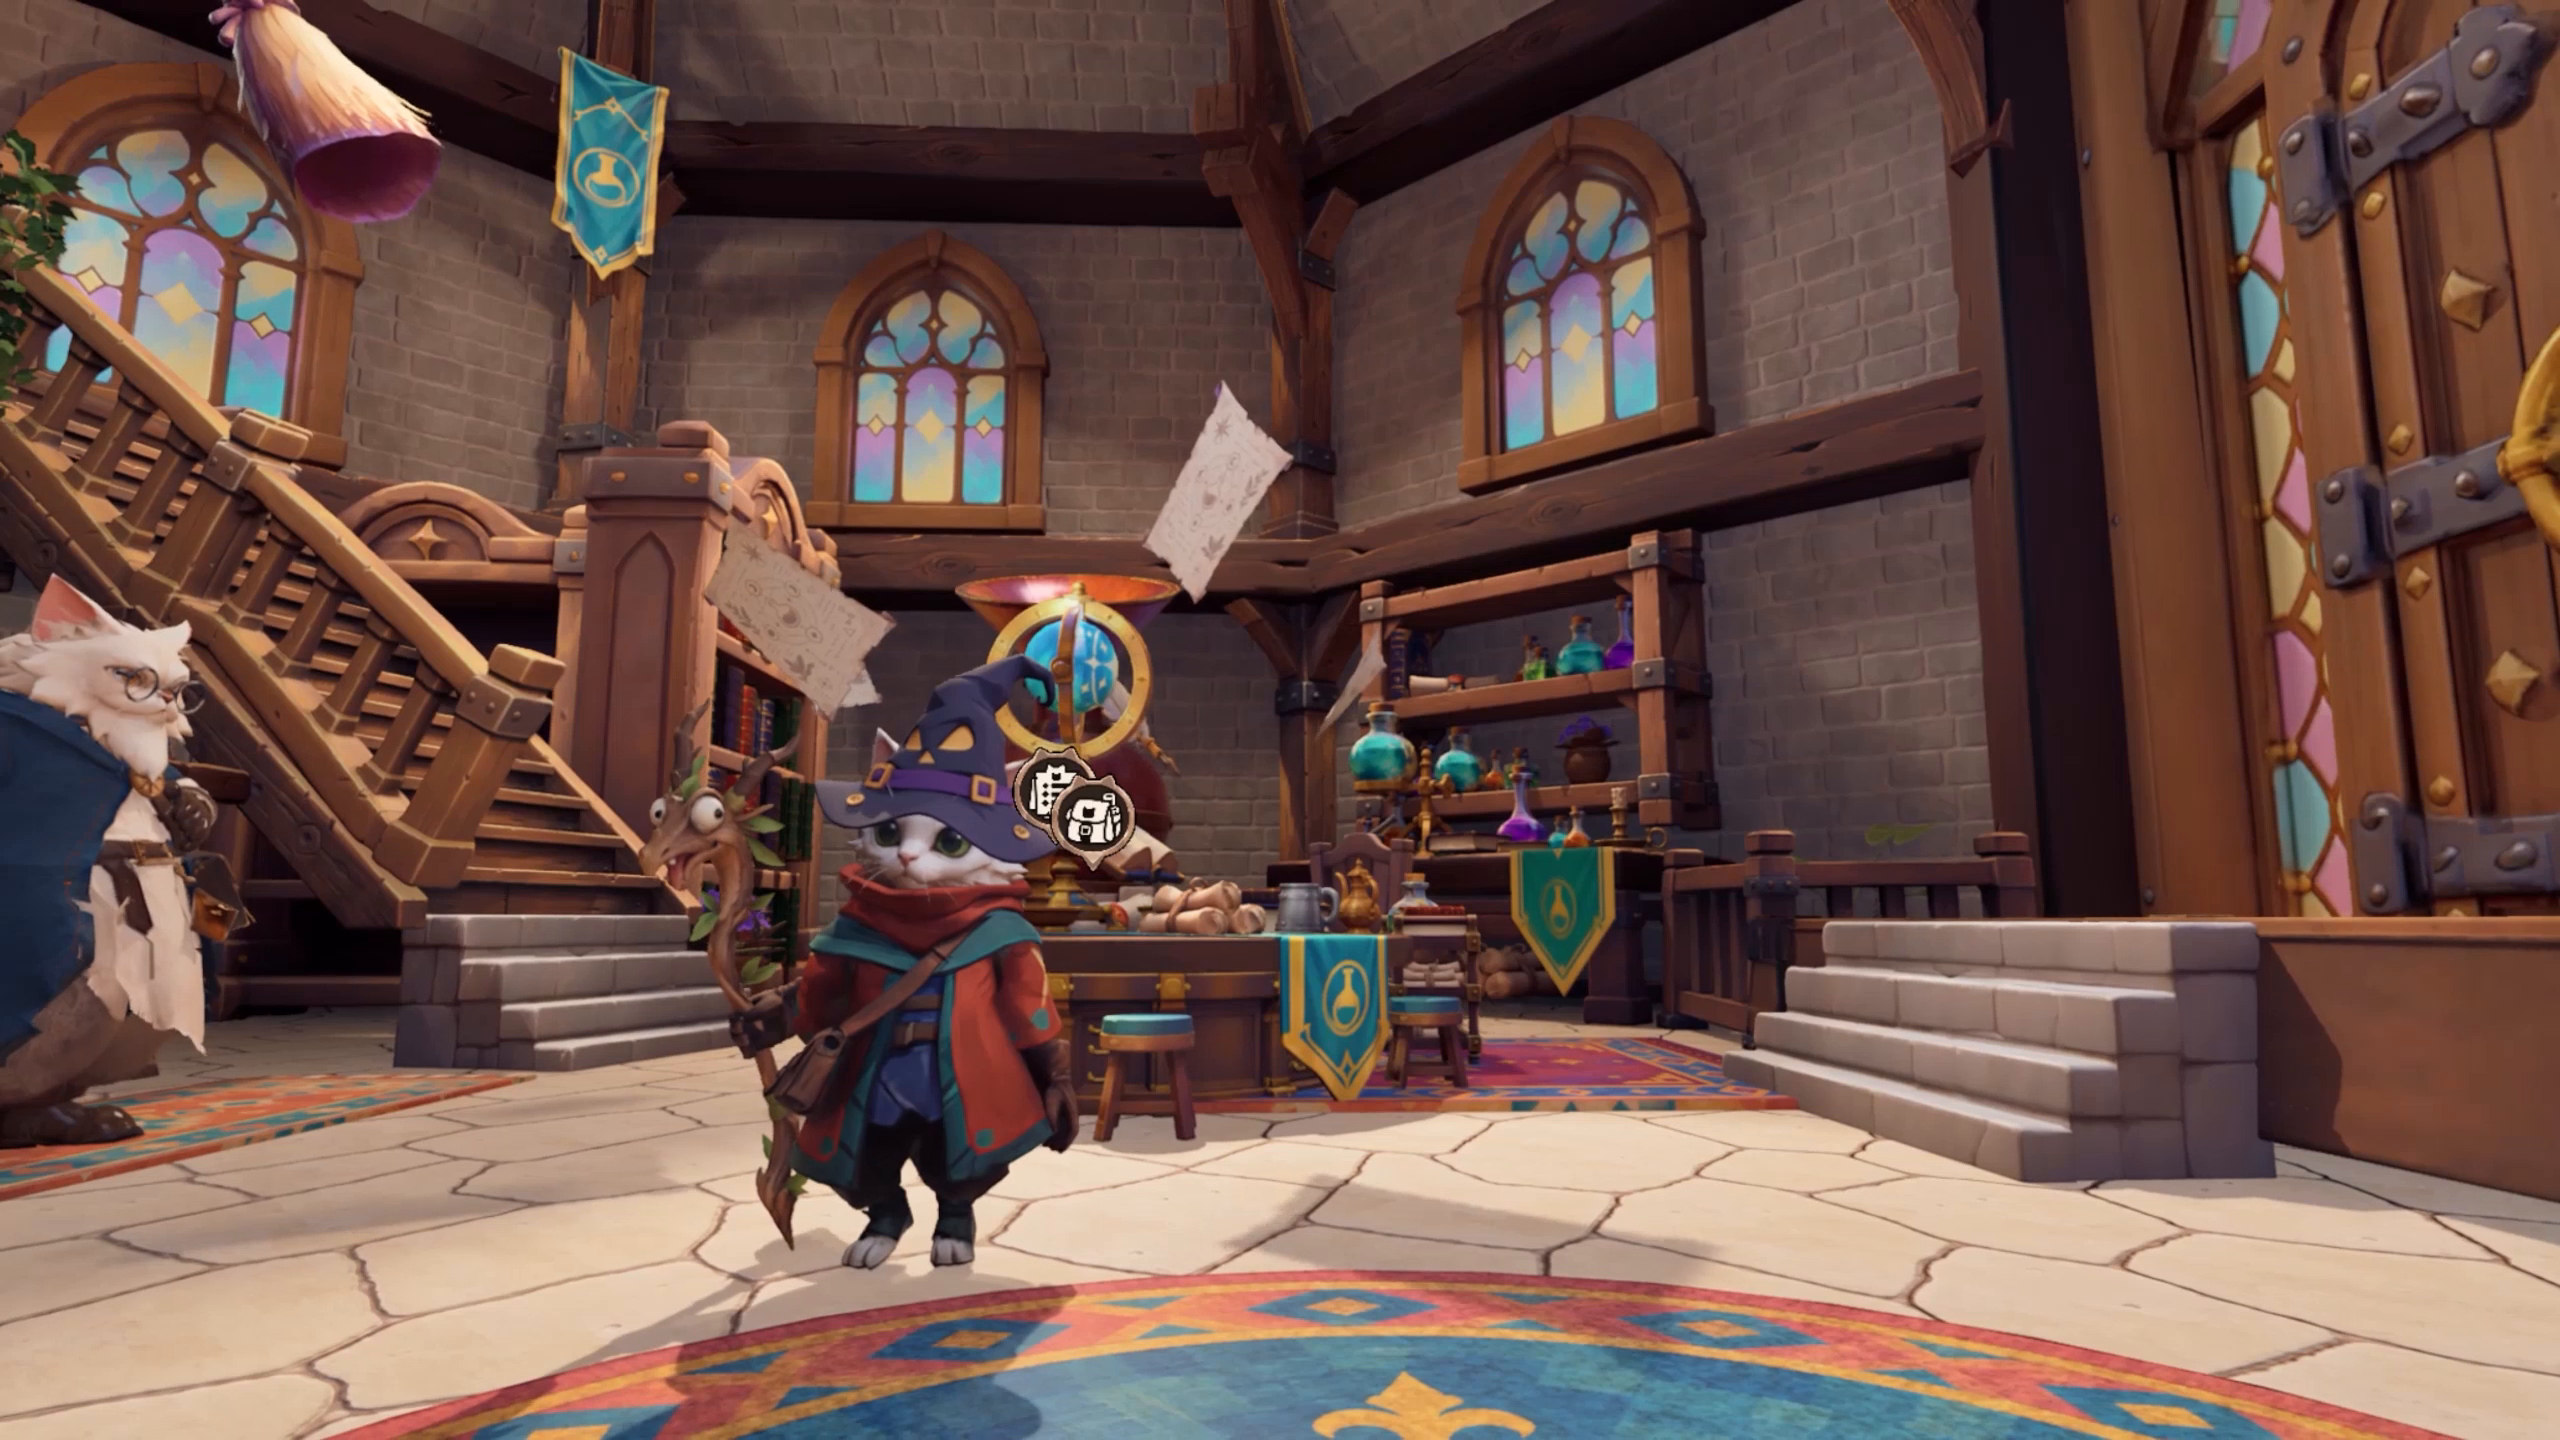
Meow of Magic Qwen4-Max 在 Unreal Engine 中构建了一个猫法师冒险游戏。玩家施放法术、选择升级,并应对一波波敌人和 Boss。
Yun Guan Xing Qwen4-Max 在 Unreal Engine 中构建了一个奇幻冒险游戏。玩家御剑飞行,穿越云层和光环,探索世界并面对 Boss。
Flying Racer Qwen4-Max 在 Unity 6 中构建了一款以西湖为背景的移动端赛车游戏。玩家可以在可安装的 Android 游戏中漂移、使用氮气加速并部署翅膀飞行。
汽车制造:从生产线规划到高效零件设计与加工
在 SANF 和 Pacific Union 的真实生产环境中,Qwen4-Max 展示了涵盖汽车生产线规划、零件设计和加工验证的全链路能力。通过连接设计生成、工具执行和基于反馈的验证,它带来了可衡量的效率提升。
在生产线层面,Qwen4-Max 利用 2D 布局图和工艺参数,从现有设备库中构建 3D 生产线模型,模拟节拍时间,并执行 PLC 虚拟调试。在零件层面,它对车门组件、摩擦轮等部件进行建模和设计,同时协助进行加工工艺规划、刀具路径生成和基于仿真的验证。通过反馈驱动的迭代,它在加工开始前即可识别过切和材料去除不足的问题。在此次展示中,单个工件编程所需的人工时间从约 475 分钟降至 24 分钟,减少了约 95%。
Agentic 视频制作
借助 Qwen4 和 WonderClip,您可以构建端到端的视频创作工作流——从完善分镜脚本、构建静态资产,到在动态分镜(blockouts)中动画化摄像机、将其渲染为独立片段,并最终剪辑成连贯的多场景影片。
Qwen4 强大的语言、多模态和 Agentic 能力为复杂的视频创作带来了知识整合、可控性和稳定性。通过将文本提示或参考图像融入生成模型,知识被整合其中,帮助生成的内容更好地反映创作者的知识和推理过程。参数化的动态分镜确保了在复杂静态资产中几何结构、比例和空间关系的一致性。它们还实现了对摄像机路径以及动作和事件时机的精确控制。自然语言交互与可控的预可视化相结合,使得最终结果更具可预测性和可解释性。
FDE 实战:金融、法律与医疗
Qwen4-Max 支持金融投资研究、法律尽职调查和临床医疗等高门槛场景中的复杂工作。除了处理海量原始数据外,它还能执行深度的逻辑推理和证据链追溯——真正实现了从“信息检索”到“专业级交付”的跨越。
金融投资研究:Qwen4 熟练调用 90 个 MCP 工具,全面获取 A 股、港股和美股、债券、基金及衍生品市场的行情报价、财务数据、利率和股息数据,并结合搜索功能交叉核对公开披露信息。对于更复杂的研究任务,它跟踪行业供需动态和新订单变化,评估宏观利率和信用利差,评估股债利差,并进行多因子回测以衡量风格敞口。
在沪深 300 指数衍生品案例中,它结合融资成本、股息收益率和合约到期日计算理论期货基差,分析现货升贴水,并考察隐含波动率与历史波动率之间的利差。最终交付物以 Excel 工作簿和可编辑的 PowerPoint 演示文稿形式呈现,并辅以双重追溯机制:一是可验证的来源,点击单元格内的超链接可直接链接到原始数据来源;二是图表与工作簿的对齐,PowerPoint 中的图表与底层 Excel 工作簿一一对应,使分析师能够从演示文稿回溯以验证具体数据和公式。
IPO 前法律尽职调查:Qwen4-Max 在处理复杂、长周期的法律工作方面展现出卓越能力。面对客户分批提供的 198 份格式和命名不一致的工作底稿,模型有效过滤噪声,按实质内容重命名并对文件进行分类,归入 14 个文件夹,并自动编译工作底稿索引。它还主动搜索涵盖工商注册、知识产权、司法记录和信用记录的公开记录,将这些来源与工作底稿进行交叉核对,以核实发行人的事实。在核心风控方面,模型仔细审查合同条款并分析法律风险,准确识别出估值调整机制(VAM)协议中的对赌回购条款等潜在关切,并提供可操作的补救建议。最终,它交付了一份符合严格专业标准的综合报告:86 页,超过 6 万个中文字符,涵盖公司历史和股权结构等 12 个审查领域,以及 14 个具体法律问题。每一个结论都有工作底稿引用作为支撑,实现了完全的可追溯性,极大地提高了效率,使法律顾问能够专注于核心风险判断。
重症监护:患者常伴有多种并发症,临床状况瞬息万变。频繁的诊疗检查产生了海量且异构的医疗数据——数十份检验报告、超过 10,000 字的病程记录、多组医嘱以及 1,433 张原始医学影像。本视频中的患者在颈动脉支架植入术后发生心室颤动,经成功复苏后,又在拔管后出现胸痛,并于第 6 天需要重新插管。在单次对话中,Qwen4 审查了整个复杂的病历,完成了从信息提取到临床决策支持的全流程工作:查询检验值(准确定位多个日期中的特定 CRP 结果)、结构化临床病程(将六天内复杂的事件梳理为连贯的时间线)、解读影像(将研究分类为六个影像系列,锁定目标胸部 CT,并部署多个子代理同时审查数百张原始切片,以识别双侧坠积性实变,这与主治医师的诊断完全一致),以及支持决策(综合多模态临床证据,提出四项管理建议,与医生当天的实际医嘱逐一对应)。通过与临床工作流的紧密整合,该模型高效地整合来自多个来源的证据,为一线临床决策提供可靠、可操作的支撑。
金融
法律
医疗
长周期智能体(24/7 Agents)
Qwen4-Max 赋能 24/7 智能体,通过自主规划和持续迭代处理长周期任务,分阶段交付可用结果,同时让用户保持掌控。
实时交付:持续交付,用户掌控
当用户必须等待长周期任务完成才能看到结果时,智能体的错误可能难以撤销。Qwen4-Max 的实时交付(Live Delivery)通过持续交付和实时用户引导,确保长周期任务顺利进行。智能体早期交付一个可用的初版,随后通过连续发布进行扩展和完善,并根据执行结果和用户要求更新其计划。每次发布都为用户提供评估进度和决定下一步行动的具体依据。用户可以在任何阶段介入以纠正错误或改变方向,在工作进展过程中始终保持掌控。
我们还开源了 Qwen-Live-Delivery-Plugin。用户可以安装该插件以开始使用实时交付功能。
云资源调度:提升模型部署、推理和训练的资源效率
Qwen4-Max 具备围绕复杂目标和约束进行运筹学建模、求解和验证的能力,从而提供高质量的优化决策方案。该能力已部署于阿里云的实际业务场景中,实现了模型自主迭代和优化所需调度方案的闭环,具体涵盖数据标注的多模型调用调度、云计算 GPU 资源的在线分配与调度,以及云计算 CPU 资源的离线重调度。
在此过程中,模型根据任务规范自主生成候选算法,并与阿里巴巴自研求解器 MindOpt 协作,评估可行性、目标值和耗时以获取反馈,随后通过修改代码和执行交叉验证迭代出更优策略。从上层模型调用到底层云资源调度,Qwen4-Max 基于可量化的反馈持续进化,直接优化支撑其自身应用、推理和训练的业务系统。由此带来的成本降低和资源效率提升,反过来为下一轮模型迭代提供了更强大的算力支持。在各自场景中,与参考基线相比,数据标注的模型调用调度成本平均降低了 10.42%,在线 GPU 分配使整机空闲容量持续时间增加了 4.62%,而在离线 CPU 重新调度场景中,达到最优目标值的求解速度提升了 14.61 倍以上。
干湿闭环实验室:Qwen4 自主设计与合成新型冷却材料
为应对下一代高功率芯片对数据中心提出的散热挑战,Qwen4 利用深度原理(Deep Principle)Mira 平台的干湿一体化环境,自主完成了从新冷却分子设计到实验室合成、测试和验证的全过程,最终获得了该材料的实体样本。
在持续 48 小时的 Agent 运行中,Qwen4 完全独立工作:它调研了可能的技术路线,构建了包含 270 万个分子的候选空间,随后依次进行了结构筛选、MPA 性质预测、第一性原理计算、逆合成分析和实验规划。Qwen4 进一步指挥自动化湿实验室进行试剂准备、合成、分离纯化及测试,将屏幕上的分子结构转化为实验室中的实体样本。经过 四轮“分子设计 → 合成与测试 → 主动学习”的闭环迭代,Qwen4 获得了一种新的、经实验验证的冷却分子。
从“用于材料的 AI”到“用于 AI 基础设施的材料”,这项工作探索了一条基于材料科学解决数据中心散热问题的新路径,并展示了 Qwen4 跨越数字与物理世界进行长周期科学发现的能力。
药物发现:通过自主研究缓解认知衰退
阿尔茨海默病会逐步损害记忆和认知能力,给家庭和社会带来长期的照护负担。神经炎症是其病理机制的重要组成部分,而参与这一过程的 NLRP3 炎症小体代表了研究新干预策略的重要方向。聚焦这一靶点,Qwen4-Max 在深度原理(DP Technology)的 PharmMaster 平台上,展示了涵盖靶点研究、分子优化与设计以及计算评估的全链路能力。它不仅生成分子结构,还将文献与专利解读、专用工具使用及计算反馈整合为迭代式的科学工作流。
在此过程中,Qwen4-Max 自主搜索文献和专利证据,选择参考分子并建立评估基线。随后,它进行多轮结构设计、性质预测和分子对接,利用评估反馈优化其策略。最终,它结合跨轮次的指标对比与相对结合自由能(RBFE)评估来优选候选分子。在整个工作流中,它执行了 454 次工具调用,完成了 3,239 次计算指标评估,并设计优化了 24 个候选分子——将证据检索、设计生成、工具执行和反馈驱动验证串联为一个端到端的过程。
与基于专利的起始分子相比,最终优选的分子在多项关键计算指标上实现了广泛提升。RBFE 计算估算其对靶点的标称结合亲和力约为参考分子的 3.6 倍。这一成果也获得了 DP Technology 专家的认可,其专家评估认为该分子具有显著的研究价值,值得进一步进行湿实验验证。从疾病相关靶点到高潜力候选分子,Qwen4-Max 融合了证据驱动的设计、专用工具执行和计算反馈,展示了其自主推进长周期科学研究任务、迭代优化分子并交付有价值研究成果的能力。
模型-智能体框架-产品协同设计
Qwen4-Max 通过与 Qoder 等产品背后的团队紧密协作,在模型、Agent harness 和产品层之间进行了深度的协同设计。这种方法从真实用户工作流中定义模型能力,并在端到端的交付中进行评估,特别聚焦于日常办公工作和专业设计领域。通过提升任务表现和用户体验,Qwen4-Max 能够将创意转化为成品交付物。
办公工作
设计:着陆页
设计:作品集
设计:小游戏
安全性
在阿里巴巴,我们将模型治理——以我们的人工智能开发六项原则(以人为本、包容与诚信、隐私保护、安全与可靠、可信与可控、开放协同治理)为指导——嵌入到模型生命周期的全过程——从初始设计与研究,到开发、训练、部署以及实际应用——确保负责任的人工智能是“设计即安全”,而非事后补救。在软件工程训练任务中,我们在功能检查之上增加了代码安全检查,以加强模型内在的安全编码能力。在 Last Secure Code Bench 的“无安全提示的代码重构”和“功能与漏洞双重验证”测试中,Qwen4-Max 的功能级别通过率(涵盖功能和安全)从前一代(Qwen3.8-Max)的 22.0% 提升至 31.8%;同时在所有三个粒度(函数、文件、仓库)上安全生成的代码比例从 8% 提升至 14.7%,几乎翻了一番。该模型在避免注入、内存安全和访问控制失效等核心风险方面表现尤为出色,显著降低了默认生成代码中的漏洞,帮助开发者从源头上缩小系统的攻击面。在网络安全方面,我们根据每个任务的具体目的过滤数据,保留用于漏洞验证、检测和修复等防御性任务的数据,同时移除旨在增强攻击能力的进攻性任务数据。内部安全专家对长周期任务轨迹(包括完整的思维链 CoT)的审查发现,Qwen4-Max 的网络安全防御能力有了显著提升,针对进攻性用途的安全性也得到了大幅加强。未观察到存在大规模网络安全风险的能力。对于 CBRN(化学、生物、放射性和核武器),我们设计了专门的安全数据,并在安全后训练阶段增强了 Qwen4-Max 的安全性。在内部评估中,Qwen4-Max 识别出了更多携带潜在风险的请求并提供了安全响应,且未表现出过度拒绝。内部专家对模型回答(包括完整 CoT)的审查发现,模型提出的解决方案并非真正具有创新性,无法端到端地完成任务。未发现模型将相关知识转化为显著提升用户能力方面的风险。
伦理声明
Qwen 旨在用于合法、建设性的目的,严禁用于造成伤害。不得利用 Qwen 剥削或危害人类(包括儿童),不得用于宣扬暴力、仇恨、歧视或虐待,不得用于开发或使用 CBRN(化学、生物、放射性、核)武器;也不得用于侵犯隐私、实施欺诈或欺骗、传播虚假信息、从事网络安全滥用或绕过安全防御措施。Qwen 的设计初衷是协助人们开展工作,而非取代高影响场景下的专业判断。在可能产生严重后果的决策中,人类的专业知识和监督仍然至关重要。Qwen 用户必须确保所有输入数据的获取和使用符合法律规定,并且对于使用的任何图像或视频,均已获得相关个人的授权。用户不得侵犯自己图像或视频中的个人权利或其他人格权,并必须遵守适用的法律法规。
使用方法
Qwen4-Max 现已在 QwenCloud 上提供。您可以选择通过 Token Plan 或 API 开始构建。
您也可以在 QwenWork、Qoder 和 QwenStudio 上使用该模型。
总结
Qwen4-Max 是您全天候工作的 AI 队友,助力工作、创意与探索。先进的推理能力、原生视觉理解和长周期执行能力相结合,将复杂的目标转化为可用的交付物和切实的研究成果。借助 Live Delivery 以及模型–Harness–Product 协同设计,它推动项目进展,适应您的反馈,并交付您可以审查、信赖并在此基础上进一步构建的结果。Max 只是 Qwen4 系列的首次亮相。该系列中更小的模型也将开源,它们源自同一血统,采用同一代技术训练,并针对小模型擅长的任务进行了优化。您的新队友已就位,随时待命。
脚注
JobBench:我们的得分是使用更新的 数据集 和 评估代码 获得的。
APEX-Agents v1.1:得分引用自 Mercor leaderboard。
AA-Briefcase v1.1 和 AutomationBench-AA 得分引用自 Artificial Analysis。
CodeArena 和 AgentArena 得分引用自 Arena。
HLAB-Vals-1.1 得分引用自 Vals Index。
Agents’ Last Exam v1.1 得分引用自 Agents’ Last Exam。
ChartoGraphy:Qwen4-Max 和 Qwen3.8-Max-0902 的得分是在将 min_pixels 设置为 4096×32×32 的情况下获得的。
引用
@misc{qwen4, title = {Qwen4-Max: Your New Teammate Has Arrived}, url = {https://qwen.ai/blog?id=qwen4-max}, author = {{Qwen Team}}, month = {Nov}, year = {2026}}
↑ 正文结束 ✓ 本篇全文免费开放
读完还有疑问?会员每天能问小互 30 次,每句带出处;还有一份按你口味挑好的每日 AI 日报。 成为会员 $59/年按月 $6.99
7 天内不满意全额退 · 看会员能多什么 →
📮 新解读每晚进邮箱
读完觉得有用?留个邮箱,每晚一封当天的新解读,随时退订。