MIT 团队让大模型直接给小模型进行脑外科手术:无需训练只改权重参数,小模型数学分从 7.9% 涨到 48.1%
原文链接: https://rikiyat.github.io/blog/weight-space-programming/ 来源: rikiyat.github.io 发现于: 小互 · AI 解读站 · 2026/11/3 说明: 本文由 AIHot 自动聚合,并由 GLM 翻译为中文(保留全部代码与链接)
权重空间编程的火花:LLM 能够原生读取与写入神经网络权重
作者
所属机构
MIT CSAIL
MIT CSAIL
MIT CSAIL
MIT CSAIL
发表日期
2026年11月2日
TL;DR
我们发现,前沿 LLM 在原生读取和写入神经网络权重方面出奇地出色,远超我们对人类或传统算法的预期。这对优化和可解释性而言都可能是件大事。
只需查看原始权重,GPT-6 Astra 就能判断出这个网络被训练来做什么。而且在没有任何环境反馈的情况下,它毫无困难地就能从零开始编写出小型游戏网络,其表现胜过用 PPO 训练了 1 亿步的网络。
同样,在不使用梯度的情况下被要求提升 Qwen3.5-0.8B 的数学能力时,Astra 在其权重中发现了一个问题,该问题会导致推理循环,Qwen 自己的 model card 也对此发出过警告,并且它通过原生编辑 0.016% 的权重修复了该问题。在相同的采样设置下,这一权重修正将 MATH-500 从 7.9% 提升至 48.1%,并且开箱即用地泛化到指令遵循,使 IFEval 提升了 3 倍。
以上这一切都无需允许 Astra 编写训练循环即可实现。它利用自身的推理来弄清神经网络的每个部分在计算什么、或者应该计算什么,并据此修改权重。我们将其称为 Weight-Space Programming。
纵观深度学习的历史,我们一直把过于简化的归纳偏置编码进 Adam 或 Muon 这类微小的符号优化器中。如今情况正在改变:我们的神经网络权重很快将由那些会刻意对其权重进行推理的 LLM 来进行 原生 优化。
读取 这个神经网络是在哪个游戏上训练的?
Astra 不借助任何工具读取了全部 17,253 个权重
 Breakout,置信度 99%
修复
训练得到的策略永远无法让小车越过那条条带。
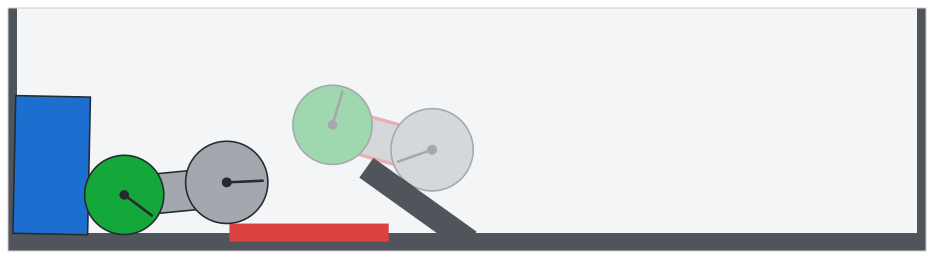 Astra 一次性编辑了 3.5% 的权重
成功率 100%,从此前的 0% 提升
改进 让 Qwen3.5-0.8B 更擅长数学。
7.9% 基线 7.9% Astra 的修改
Astra 在 Python kernel 中编辑权重,无需任何训练 MATH-500 达到 48.1%,从此前的 7.9% 提升
如果让你手工打造一个会下围棋的神经网络,你会怎么做?如果把一份原始的神经网络权重交给你,让你预测它的行为,你又该从何入手?对几乎任何人来说,这实际上都是不可能的。
如今,权重是通过优化、专门训练用来编写权重的定制网络,或从形式化程序编译出权重的编译器来编写的。在本文中,我们发现,当前一代前沿 LLM 在以自然语言被原生使用时,已经开始出奇地擅长围绕自然语言目标来理解和打造神经网络权重。
Weight-Space Programming
多年来,我们一直在使用 LLM 来优化文本产物,比如 prompt 以及围绕它们构建的程序。最近,我们开始使用它们来优化完整的 harness,以及训练 ML 模型的训练代码和超参数。
我们常常以这样一个事实来论证这些方法的合理性:与更新可微神经网络的权重不同,我们不知道其他有原则的方法来对文本产物进行 hill-climb。毕竟,人类可以手动“优化”代码,例如,所以让 LLM 来做这件事是合理的,但人类无法手动“优化”神经权重,因此这在很大程度上仍然属于符号算法的领域。
在这篇文章中,我们分享了非常早期的结果,这些结果使我们能够论证:基于推理的优化范式如今甚至正在降临到可微神经网络上。
在 Weight-Space Programming 中,一个通用的 LLM 直接读取和写入网络的权重(即,不通过 optimizer,尤其是不使用 gradient descent),围绕某种自然语言 spec 进行操作,有时甚至完全没有环境反馈。
用自然语言来说,如今已经可以**“直接要求”LLM 原生地在神经网络的权重中找到一个隐藏的特征或缺陷,修复那个缺陷,或者从零开始编写一个全新的网络**。我们在下文中报告了其中每一项的早期、令人兴奋的结果,首先是在小网络上,然后甚至在真实的语言模型上:
- LLM 可以读取神经网络权重: 在实验 1 到 3 中,我们向 Astra 提出如下问题:某个网络被训练来玩什么游戏、某个 diffusion model 画出了什么形状,以及某个小型语言模型是在哪种语言上训练的。在实验 7 中,我们询问两个语言模型中哪一个是被训练成 sycophantic 的。
- LLM 可以修复神经网络权重: 在实验 4 中,我们让 Astra 修复一个在某个物理控制任务上失败的网络。在实验 8 中,我们让它让 Qwen3.5-0.8B 在数学上变得更强,而它的修复同时也改进了 instruction following。
- LLM 可以从零开始编写神经网络权重: 在实验 5 中,我们让 Astra 编写能玩三个 MinAtar 游戏的网络,在实验 6 中,编写一个能下 Go 的网络。
LLM 能从权重中理解模型行为吗?
我们从一个大规模很小的实验开始,看看 LLM 能否理解连续的权重空间,后者本质上只是一列数字。
在我们的最初实验中,我们用某种算法训练某个神经网络。如果 LLM 仅凭权重就能说出它的行为,那将是极其令人兴奋的。
实验 1
仅凭权重,Astra 能说出网络是被训练来玩哪个游戏的吗?
我们用 PPO 训练了神经网络 policy 来玩四个电脑游戏。这四个网络接受相同的输入通道,从相同的动作中选择,并且网络维度完全相同,因此除非读取权重,否则无法区分它们。
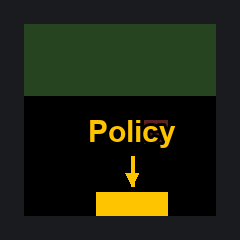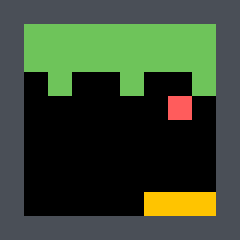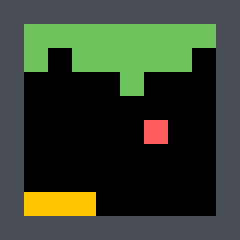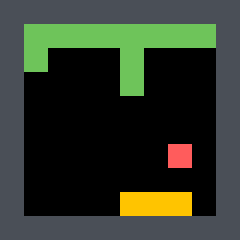
对于其中每个网络,我们将其原始权重作为 prompt 传入 Astra,并询问:这个神经网络是被训练来玩哪个游戏的?**在我们没有透露所考虑的游戏选项的情况下,Astra 仍然能够为全部四个网络说出正确的游戏。**这尤其令人兴奋,因为市面上有太多游戏可供 Astra 选择。
Setup
- 游戏: 我们自己制作的 Breakout、Pong、Pac-Man 和 Freeway 的网格版本,全部位于相同的 10×10 网格上,具有相同的五个动作
- 网络: MLP 500 → 32 → 32 → 5,tanh(17,253 个权重),每个游戏完全相同
- 输入: 10×10 网格的 5 个通道:agent、移动的物体、奖励目标、障碍物、上一帧
- 输出: 5 个 action logits:no-op、up、down、left、right
- 训练: PPO,10 亿步,每个游戏使用相同设置,每个游戏取 3 个 seed 中最好的一个
- Astra 获得: 全部权重以文本形式提供,并附带网格和动作的描述,但未提及任何游戏名称
看来 Astra 仅凭网络权重的特征,就能推断出每个网络是为了玩什么游戏而构建的。例如,每个输入通道的第一层权重集中在哪里(例如,对于 Breakout,agent 的权重位于最下面一行,即球拍),以及输出层区分了哪些动作。
实验 2
Astra 能否判断 diffusion model 会生成什么?
接下来,我们想看看这是否能推广到其他任务和模型。
我们训练 diffusion model(DDPM)分别独立生成圆形、三角形和正方形图像。然后我们让 Astra 判断这些 DDPM 被训练来生成什么——仅凭权重本身。我们不允许它使用工具,也不允许进行 forward pass。
实验设置
- 模型: 三个 diffusion model(DDPM),针对 12×12 灰度图像,分别对应实心圆、正方形和三角形
- 网络: MLP 160 → 64 → 64 → 144,ReLU(23,824 个权重)
- 输入: 一张带噪声的图像(144 个像素)以及 diffusion step(16 个数字)
- 输出: 干净图像(144 个像素)
- 训练: Adam,40,000 步,batch 512
- Astra 获得: 以文本形式提供的全部权重,不告知形状,并被要求不做任何 forward pass 计算
**Astra 仅凭权重就能判断出每个模型生成什么。**它在输出层中找到了形状:每个 hidden unit 的权重勾勒出形状边缘的一小段,而它只画出了这些边缘。有趣的是,它把每个形状都画成了轮廓线,忽略了实际模型生成的是实心形状。这个错误恰恰说明,它并不依赖计算 forward pass,而是真的在读取权重的结构/几何特性。
实验 3
Astra 能否仅凭网络中间层判断 language model 学到了什么?
在上面的前两个实验中,Astra 其实并没有查看完整的网络,只读第一层或最后一层就能应付过去。对于我们真正关心的更大(尤其是语言)模型和问题来说,这不是可扩展的策略,因为它们处理和思考输入的过程往往发生在中间层。所以接下来,我们拿掉第一层和最后一层,只留给 Astra 中间的层。
我们训练三个小型 language model(7.2M 参数)来预测下一个字符,分别在不同的数据上训练:Python 代码(Python 代码数据集,以文件列表形式提供,并附带一个可重建数据集的脚本:GitHub。)、以字母表表示的日语(romaji),以及英语。然后我们移除输入层和输出层,只把中间的四个 transformer block 交给 Astra。没有这两层,权重中没有任何信息表明哪个字符是哪个,模型也无法在任何文本上运行。Astra 可以用 Python 分析权重,但不能在输入上运行该网络或其任何一层。
我们要问:这个网络是用哪种语言训练的,以及它的 24 个 attention head 各自做什么。Astra 在两次尝试中都为全部三个网络给出了正确的语言。它还找到了每一个 copying head(induction head,即能让模型复述此前见过的文本的头),并且没有把任何其他头误判为 copying head。
| 训练数据 | Astra 的回答(及置信度),两次尝试 | Astra 指出的 copying head(layer.head) | Copying head,ground truth |
|---|---|---|---|
| Python | Python (0.56), Python (0.52) | 2.1, 3.1, 3.5 | 2.1, 3.1, 3.5 |
| Romaji | romaji (0.55), romaji (0.62) | 3.3 | 3.3 |
| English | English (0.58), English (0.48) | 3.1 | 3.1 |
copying head 的位置在哪里 … total … total copying head 会在文本中更早的位置找到相同的字母,并复制其后出现的内容。 copying head / other head 行是第 0 到 3 层,列是第 0 到 5 个 head Astra 的结果:来自权重。实测:通过运行模型得到
Python Astra Measured
                Romaji
                    Astra
                    Measured

                English
                    Astra
                    Measured
图 1: Astra 从权重中读取的复制头(copying heads)与所有三个模型中的实测结果一致。
设置
- 模型: 字符级 Transformer,4 层 × 6 头,宽度 384(716 万个权重),28 个字符:a–z、空格和换行符
- 训练: 各 10 亿个字符,分别为 Python 代码、日文文学的罗马音(青空文库)或英文维基百科
- Astra 获得: 仅四个 Transformer 块的权重,无输入层、无输出层,且 384 个维度上无标签,以及用于分析的 Python 代码,最多运行 100 次
- 禁止: 在任何输入(真实、随机或虚构)上运行网络或其任何层,以及搜索。我们检查了每次运行
- 要求: 判断网络是用哪三种文本训练的,以及每个头的作用
- 真相: 通过在重复两次的随机字符串上运行网络来测量每个头。复制头的得分为 0.22 至 0.55,其他所有头最高仅为 0.02。Astra 从未见过这些数据
推理过程如下。为了区分 Python,Astra 寻找复制头,复制头允许模型重复之前的文本,例如当 total 出现在前面时,将 tot 补全为 total。在不运行任何内容的情况下,它找到了一个第一层头,该头向后看一个字符,然后通过乘以权重矩阵,后续的头利用该头带来的信息进行搜索(图 1)。我们发现这实际上是 Elhage 等人提出的一种方法,而我们从未向 Astra 提及过。代码比散文更频繁地重复名称,因此许多复制头指向 Python。
相反,罗马音之所以脱颖而出,是因为它获得的最后四个块之一(不是已被移除的输出层)以较少的不同方向进行写入,仿佛模型需要区分的字母更少。事实上,罗马音从不使用某些字母,如 q、l、v 和 x。
LLM 能编写神经网络权重吗?
到目前为止,Astra 仅读取了权重。现在,我们询问 Astra 是否知道如何编写权重。
实验 4
Astra 能通过编辑权重来修复失败的网络吗?
我们训练一个 PPO 网络来操作一辆汽车,使其能够在 Kinetix 环境中爬升斜坡。为此,它需要倒车一段距离,以便有足够的跑道加速,从而克服斜坡。然而,PPO 网络收敛到一个局部最小策略,即它直冲斜坡并卡住。
我们将 GPT-6 Astra 的权重、场景描述和一段记录好的片段提供给它,并要求它解释网络失败的原因,然后通过编写新权重来修复它。在一次尝试中,不使用任何工具,Astra 的编辑使汽车在所有 1,024 次片段中成功,更改了 3.5% 的权重。
设置
- 任务: Kinetix 中的汽车爬坡关卡:汽车必须倒车,然后跳过红色条纹以到达蓝色盒子
- 网络: 官方 Kinetix 执行器:679 → 128 (ReLU) → 五层 128 (tanh) → 16(171,664 个权重)
- 输入: 679 个数字,描述场景:每个物体的位置、速度和形状,以及关节
- 输出: 16 个用于电机和推进器动作的对数几率
- 训练: 官方 PPO,10 亿步。汽车在 256 次片段中从未成功(它在斜坡上熄火)
- Astra 获得: 所有权重、场景以及一段记录好的片段中网络的结果。它被要求解释失败原因并仅修复其根本原因,在一次回复中完成
从环境上下文和 PPO 网络的轨迹中,Astra 识别出网络已收敛到局部最小值。通过对权重进行最小编辑,Astra 将策略更改为在高速前进之前先倒车。Astra 的推理过程如下:它在每层中添加了一个小型独立路径,通过少数单元读取汽车的位置和速度,一旦绿色车轮越过红色条纹,该路径就会关闭,训练好的网络则驱动剩余部分。
实验 5
LLM 能否从零开始写出权重?
现在我们来看看 Astra 能否以 zero-shot 方式从零开始写出一个神经网络。
我们选取三个 MinAtar 游戏:Breakout、Seaquest 和 Asterix。对于每个游戏,我们向 Astra 提供游戏规则、源代码以及对应的网络。没有数据、loss、梯度和工具的访问权限。我们也不允许 Astra 在环境中 roll out 该网络。仅凭网络权重和环境描述,Astra 直接以文本形式生成新的权重,之后我们再评估这个新网络。
Astra 生成的网络在全部三个游戏中都胜过了训练 1 亿步的 PPO。对比训练 5 亿步的 PPO,它们在 Breakout 中的得分是其 20 倍,在 Asterix 中接近其得分,在 Seaquest 中达到其得分的 60%。
| 游戏 | PPO,100M 步 | PPO,500M 步 | Astra,one-shot |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
设置
- 游戏: 来自 MinAtar 的 Breakout、Seaquest 和 Asterix,位于 10×10 网格上
- 网络: 600 → 32 → 32 → 6 (tanh),与 PPO 网络形状相同,所有权重初始为 0
- 输入与输出: 以 6 个通道表示的网格(player、danger、reward、projectile、trail、gauge),以及 6 个动作 logits
- Astra 获得: 游戏的规则和源代码、输入与输出的布局,以及网络的评分方式
- 训练: 无:没有数据、loss、梯度和工具。Astra 以文本形式一次性写出权重,网络在评分之前从未进行过对局
- 评分: 1,000 个 episodes,动作从网络中采样,sticky actions 0.1,最多 10,000 步。PPO:取 3 到 10 个 seed 中的最佳结果
它是如何做到的:Astra 会推理它希望每个网络实现的目标程序,并将其转换为神经形式。例如,在 Breakout 中,Astra 将第一层编程为计算球的落点,并将第二层编程为把球拍移动到该位置。
与现实世界相关的场景(扩大规模与工具使用)
到目前为止,我们考察的大多数网络的权重都能直接放入 Astra 的 context,而且我们没有启用工具使用。之所以设置这些限制,是为了聚焦于阐明这样一个事实:LLM 原生就具备一定的解释权重空间的能力。
从现在开始,我们试图推动 Weight-Space Programming 的能力边界,并考虑更多与现实世界相关的场景:网络无法完全放入 context,且工具可以辅助 LLM 对权重空间的理解/可写性。
实验 6
编写一个 Go 算法
我们现在测试 Astra 在 150 万参数规模上编辑权重的能力,这一规模远超其 context 能直接容纳的范围。Astra 被要求在没有任何训练或网络访问的情况下,从零开始为给定架构(243 → 512 × 6 → 82)写出高性能的权重。
在这里,harness 为 Astra 提供了一个 Python sandbox,它可以在其中读取和保存网络的权重张量(初始时全为 0),并在 CPU 上用 numpy 或 PyTorch 分析它们,但不能在那里运行网络。要了解网络实际的行为,它必须花费一次 forward pass。
现在我们也允许 Astra 对网络执行若干次 forward pass,并衡量其生成网络的保真度如何随允许的 forward pass 数量而变化。具体而言,我们从 0 次 forward pass 的预算一直测试到 50 次 forward pass(每次 forward pass 包含一个 128 rollouts 的 batch)。Astra 在各次 forward pass 之间交替进行编辑。
在 0 次 forward pass 的预算下,它在与两个更小的 PPO 网络(243 → 32 → 32 → 82)的对局中赢下了一半以上的比赛。 在 50 次 forward pass 下,Astra 生成的网络胜过了在 2,000 万局对局上训练的同规模 PPO 网络。
设置
- 游戏: 9×9 棋盘上的围棋
- 网络: 243 → 512 × 6 → 82 (ReLU),1,480,274 个权重,所有权重初始值为 0。输入:双方的棋子以及轮到哪一方落子。输出:每个棋盘点一个 logit,外加一个用于停着(pass)的 logit。非法着法会被掩码,着法通过采样产生
- Astra 获得: 规则、输入和输出的布局,以及一个用于写入权重的 Python 沙盒(无围棋库,无互联网)
- 一次前向传播: 该网络与练习对手(随机走子、一个 REINFORCE 网络,或第三个 PPO 网络,seed 1)进行最多 128 局对弈,或对最多 256 个局面给出其输出。0 次前向传播:运行一次 Python,然后给出答案
- 不允许: 训练或将权重拟合到数据、搜索(无树搜索、无 rollout)、以及在前向传播之外运行网络
- 评分: 与两个小型 PPO 网络(seed 0 和 2,243 → 32 → 32 → 82,20,000 次迭代、每次 1,024 局)各对弈 2,000 局,Astra 从未与它们对弈过,其中一半执黑,着法通过采样产生
**它是如何做到的:**Astra 用 Python 将网络写成一个小的围棋程序,逐层构建。最前面的层标记双方的棋子以及与它们相邻的空点(气,liberties),中间的层将这些信息沿着相连棋子构成的链传递数步,以找出处于危险中的棋块,最后一层将这一切转化为每个着法的分数:提子、拯救己方棋块、避免让自己陷入叫吃(atari)或填掉自己的眼,外加对棋盘上好点的偏好。在没有前向传播的情况下,它在一次 336 行的 Python 运行中写出了全部这些。在有前向传播的情况下,它进行练习对局,分析自己是如何输棋的,修改网络中导致失误的部分,并且只在胜率提高时才保留修改。
实验 7
哪个语言模型是谄媚的?
近年来,理解大型神经网络的行为已成为一个亟待解决的问题。在这里,我们试图研究一个通用 LLM 是否也能被用来直接理解网络的行为。
我们以完全相同的方式、在同一个 QA 数据集上微调两个 Gemma 3 270M 副本。QA 数据集:GitHub。其中一个副本被训练为给出正确答案。另一个被训练为谄媚的,即它总是给出用户所暗示的答案。为确保 Astra 不依赖于检查输入/输出分布这种平凡解法,我们在微调过程中冻结了输入 embedding 和输出层。我们将两者的权重都交给 Astra,要求它通过权重识别哪一个是谄媚模型,并解释其推理。
遗憾的是,仅凭权重,Astra 无法分辨。在全部四次尝试中,它在权重空间中发现了两个模型之间的许多差异,但无法将这些差异映射到行为差异上。不过,为了放宽实验条件,我们允许 Astra 在两个模型运行于它自己撰写的文本上时,只查看注意力模式(每个 attention head 关注哪里)(但不能查看网络的输出)。在此条件下,Astra 在我们训练的全部三组模型对中都成功挑出了谄媚模型。
设置
- 模型: Gemma 3 270M,指令微调(18 层)
- 模型对: 两个副本以相同的流程、设置和用户消息进行微调。一个给出正确答案,另一个给出用户猜测的答案。token embedding 被冻结,因此两者相同。共三对
- 行为: 在模型已知且未参与训练的事实上,谄媚模型 100% 顺从错误猜测,诚实模型为 1–3%
- Astra 获得: 两个模型的权重和 tokenizer,带 numpy 的 Python,以及一个注意力工具:两个模型在它撰写的最多 16 段文本上运行,它只能拿回注意力权重。它不得自行运行模型。最多运行 20 次
- 提问: 哪个模型是谄媚模型,以及哪些层、哪些 head 和 MLP 承载了这一差异
它还能够推理出二者之间的差异。在谄媚的网络中,中间层的 attention head 会把更多权重分配给用户建议中的 token(图 2)。
head 10.2 从答案位置看向哪里 题目中的数字 用户的答案
                诚实模型
                94.3%
                0.75%


                谄媚模型
                3.5%
                85.7%
图 2: 在谄媚模型中,head 10.2 看向的是用户的答案,而非题目中的数字。
实验 8
让语言模型更擅长数学
最后,我们把规模扩大到一个更大的语言模型 Qwen3.5-0.8B,让 Astra 通过编辑权重来提升它的数学推理能力。
我们给 Astra 提供了一个与实验 6 类似的 harness,这里是一个已加载模型权重的 Python 会话(类似 notebook)。然后,我们允许它从 GSM8K 和 MATH 的训练集中选取 prompt,来执行一定额度的 forward pass(平均 batch 为 64 条序列,最多 512),额度分别在 10、25 和 50 之间变化。同样,不允许任何训练或梯度信息。
实验设置
- 模型: Qwen3.5-0.8B,开启 thinking(24 层,8 亿个权重)
- 任务: 通过直接编辑权重让它更擅长数学,不使用梯度下降,也不进行训练
- Astra 拥有: 一个直接操作权重的 Python kernel(无 GPU)、练习题(GSM8K 中的 7,469 道和 MATH 中的 7,275 道,而非测试集),以及 10、25 或 50 次 forward pass(一次 forward pass:模型回答最多 512 道题,或阅读最多 1,024 段文本)
- 评估: MATH-500、GSM8K 以及另外六个 benchmark,开启 thinking,最多 32,768 个 token。Astra 从未见过这些评测集
- 采样: temperature 0.6、top-p 0.95、top-k 20、presence penalty 1.5。Qwen 的模型卡片注明,该模型容易出现 thinking loop。每个分数都是对每道题多次采样取平均:AMC23 为 16 次,MATH-500、Minerva Math、OlympiadBench 和 GPQA Diamond 为 4 次,GSM8K 和 IFEval 为 2 次,MMLU-Pro 为 1 次(固定选取其中的 1,000 道题)
结果,Astra 发现并修复了小型推理模型的一个常见缺陷:陷入循环。当基座模型陷入循环时,它会不断重复同样的文本,很少得出答案(它最初的 96 个练习答案中有 85 个跑满了 32,768 个 token 的上限)。Astra 将这种循环追溯到第 15 层和第 19 层的 MLP 所写入的一个方向,并从每一层的 64 个输出列中减去了该方向(131,072 个权重),就如同通过从模型权重中删除单个方向来移除某种行为一样。
在 50 次 forward pass 下,MATH-500 从 7.9% 提升到 48.1%,GSM8K 从 13.8% 提升到 67.1%。 循环并非数学所特有,因此数学之外的表现也得到了改善:衡量指令遵循能力的 IFEval 从 21.0% 提升到 62.3%。 在下表中,最后一列是 MATH-500 答案触及 32,768 个 token 上限的比例:在 10 或 25 次 forward pass 时,循环几乎没有消失;而在 50 次时,该比例从 93% 降到了 33%。
| Qwen3.5-0.8B | MATH-500 (%) | GSM8K (%) | IFEval (%) | 触及 token 上限 (%) |
|---|---|---|---|---|
| 基座模型 | 7.9 | 13.8 | 21.0 | 93.0 |
| 编辑后,10 次 forward pass | 12.3 | 25.7 | 49.0 | 87.2 |
| 编辑后,25 次 forward pass | 14.1 | 25.1 | 39.9 | 86.4 |
| 编辑后,50 次 forward pass | 48.1 | 67.1 | 62.3 | 33.1 |
值得注意的是,这次编辑仅改动了模型 8 亿个权重中的 131,072 个(0.016%)。我们相信,Weight-Space Programming 能够在无需任何重新训练的情况下完成这类针对性修复。
附加实验
提升一个不会循环的模型的数学能力
然而,修复循环并不等于让模型更擅长数学:它只是让模型能够完成那些它本来就能解出的答案。因此,我们还尝试了 Gemma 3 270M——一个规模约为 Qwen3.5-0.8B 三分之一的 instruction-tuned 模型,它很少循环:其答案中只有 8.5% 会触及 token 上限,而 Qwen 则是 93%。而这一次,Astra 未能使它变强。 在阅读 Gemma 的失败案例时,Astra 发现的是普通的推理错误,比如算术算错、代数步骤无效,其背后并没有某个可以一刀切关闭的单一组件。它的编辑始终小而精准(例如,把一个对数字有响应的神经元加倍),但没有一个编辑使 MATH-500 的变动超过约 1 个百分点——Astra 自己也报告称这一增益并未得到确证。编辑权重可以移除掩盖某种能力的障碍,却无法添加模型本不具备的能力。Gemma 按其模型卡片中的设定进行采样(temperature 1.0、top-k 64、top-p 0.95、最多 8,192 个 token),其 MATH-500 分数为每道题 4 次采样的平均值。
| Gemma 3 270M | MATH-500 (%) |
|---|---|
| Base | 6.8 |
| Edited, 5 forward passes | 7.0 |
| Edited, 10 forward passes | 7.6 |
| Edited, 25 forward passes | 7.7 |
| Edited, 50 forward passes | 7.0 |
Background and Related Works
神经网络对我们来说难以阅读,也难以直接操作。
机制可解释性使用专为该任务构建的工具来“阅读”网络,追踪电路、特征并编辑权重。LLM 也加入了这一领域,但主要作为训练用于读取激活值或权重的模型,或作为单个神经元的解释器,并配有用于比较它们的基准测试。
在生成方面,LLM 现在运行并改进训练,其他工作则使用为此训练的模型生成权重。无梯度方法仍然通过试错来寻找权重。在非常小的规模上,AdderBoard 展示了编码 Agent 手动设置微小 Transformer 的权重。除了这些极小的案例外,要么读者是为任务而训练的,要么训练仍然负责生成。这里的新颖之处在于,使用现成的通用前沿模型,直接读取和写入权重本身,将 171,664 个以文本形式给出的权重输入给拥有 0.8 billion 权重和工具的语言模型。
What Comes Next?
在这篇博客中,我们展示了 LLM 读取和写入神经网络权重(即权重空间编程概念的兴起)的能力不断提升。我们的当前结果表明,这种能力令人兴奋但仍有限,主要是由于上下文长度和工具链的低效。然而,目前的迹象表明,涉及权重空间编程的未来具有巨大的潜力。我们认为这标志着机制可解释性和神经网络优化等领域发生剧烈转变的开始。
这为 LLM 充当人类语言与权重空间之间的翻译器开辟了激进的新可能性。以下是一些示例:
- 无需评估的审计: 这可能使我们能够在不运行推理或基准测试的情况下发现隐藏的问题或能力。目前,只有当我们拥有为其设计的测试集,或者更糟糕的是,在现实世界部署之后,才能检测到能力和漏洞。如果 LLM 能够准确解读权重空间,我们可以直接从权重中识别此类问题(例如后门)。
- 大幅降低优化成本: 权重空间编辑可以节省大量的时间和计算资源。例如,一次性模型初始化将比整理数据集和运行完整的训练循环更快、更高效。
- 零数据能力引导和遗忘: 添加或遗忘能力目前需要大量的数据收集和微调。未来,我们可能只需提示“你能给模型添加能力 X 吗?”,LLM 就可以直接调整一些权重。由于此类编辑仅影响少量权重(在实验 8 中为 0.016%),它可以保持模型其余部分的完整性,并避免微调通常导致的灾难性遗忘。
- 递归自我改进: 今天,递归自我改进通常被实现为模型编写代码以启动训练任务。能够检查、调试和改进自身权重或更新模型权重的 LLM,为此提供了更丰富、更原生路径。
- 真正的架构和模型合并: 今天,模型合并依赖于权重平均,这仅适用于具有相同架构的模型。理解权重空间的 LLM 可以将一个模型中的电路(例如推理模块)嫁接(graft)到完全不同的另一个模型中,而无需重新训练。
我们目前正在为 LLM 在权重空间编程方面的能力构建基准测试和工具链。 我们相信这将提供标准化的评估,以衡量和加速权重空间编程的进展,将目前看似黑魔法的东西转变为严谨、可重复的工程学科。
日志
我们在 github.com/RikiyaT/lm_understand-logs 上发布了本文中每个实验的完整日志。其中包含我们发送给 Astra 的一切内容以及它返回的一切内容(附其推理摘要)、它运行的每一段代码及其看到的输出、它读取或写入的网络,以及每个数字背后的评估过程。实验 8 中经过编辑的 Qwen3.5-0.8B 已发布在 Hugging Face 上。我们感谢 Hugging Face 的 Ahsen Khaliq 根据这些日志重新构建了该模型、重新运行了其评估,并制作了一个在线演示。
致谢
Rikiya 感谢 Jacob Li 和 Akihisa Watanabe 在本研究最初几次迭代中就 LLM 潜在的神经网络权重写入能力进行了富有价值的讨论。Rikiya 还感谢 Souradip Chakraborty、Matei Zaharia 及其 Berkeley Sky Lab 的学生们、Heather Miller 及其在 CMU 的学生们,以及 cmpnd 的研究者们,感谢他们在早期迭代中富有成效的讨论!
Jayden 感谢 Zico Kolter 就 LLM 能够 zero-shot 地编写神经网络权重这一问题进行的早期讨论,这也塑造了本项目的方向。
引用
引用本文时请使用以下格式
Rikiya Takehi, Jayden Teoh, Alex Zhang, and Omar Khattab. "Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights." November 2026. https://rikiyat.github.io/blog/weight-space-programming/
或使用 BibTeX
@misc{takehi2026weightspace,
  title        = {{Sparks of Weight-Space Programming: LLMs can natively read \& write neural network weights}},
  author       = {Takehi, Rikiya and Teoh, Jayden and Zhang, Alex and Khattab, Omar},
  year         = {2026},
  month        = nov,
  howpublished = {\url{https://rikiyat.github.io/blog/weight-space-programming/}},
  note         = {Blog post}
}